ORCA: A Distributed Serving System for Transformer-Based Generative Models
摘要
用于生成任务的大规模 Transformer 模型(例如 GPT-3)近年来引发了巨大关注,凸显了为此类模型提供系统级服务(Serving)支持的迫切需求。由于这类模型以自回归的方式生成下一个 Token,系统必须多次运行模型前向传播才能完成单个推理请求,其中每一次模型迭代仅生成一个输出 Token。然而,现有的推理服务系统在处理这种具有“多迭代”特征的工作负载时表现不佳。根本原因在于其调度机制过于僵硬,无法在运行过程中动态调整正在处理的请求 Batch:同一个 Batch 中提前生成完毕的请求无法即时返回给客户端,而新到达的请求又必须一路排队,直到当前 Batch 完全执行完毕。
在本文中,我们提出了迭代级调度(Iteration-level Scheduling),这是一种以迭代(而非请求)为粒度调度执行的新型机制,调度器每次仅调用执行引擎运行 Batch 的单次迭代。此外,为了让 Transformer 模型能够同时兼容 Batching 与迭代级调度,我们设计了选择性批处理(Selective Batching),即仅对部分特定算子施加批处理。基于这两项技术,我们实现了名为 ORCA 的分布式服务系统,并针对千亿参数规模模型的扩展性进行了专门设计。在 GPT-3 175B 模型上的评估结果表明,ORCA 在延迟和吞吐量上均显著超越了 NVIDIA FasterTransformer:在维持相同延迟水平的前提下,实现了 36.9 倍的吞吐量提升。
1. Introduction
- 问题:
- LLM 生成是自回归迭代式的,每次模型 forward 仅生成一个 token,然后这个 token 作为输入进行下一次迭代推理。
- 现有推理系统以 batch 维度进行 request 调度,即整个 batch 的所有
request 全部推理完成后,才返回完整的 batch result,这导致了:
- batch 内生成长度短的 request 已经推理结束了,但是没有被及时返回给 client,导致时延增加。
- 排队 requests 需要等待整个 batch 推理结束,导致排队时间增加。
- 本文提出的方法:
schedule the execution of the engine at the granularity of iteration instead of request- 一个 batch 每次运行只跑一次 forward,而非整个 batch request 全部生成结束。
apply batching only to a selected set of operations, which we call selective batching- Attention 计算 batch 内每个 request 独立进行;
- Transformer 其他运行进行 batch 运行。
- 基于上述两个方法,设计并实现了 ORCA:针对 Transformer
生成式模型的分布式推理服务系统。
- 支持超大模型的 TP/PP 推理。
- 实现了上述 iteration-level 调度算法。
- 效果:
- GPT-3 模型(扩展到 341B 参数)的 serving 吞吐对比 FastTransformer 实现 36.9× 倍提升。
2. Background
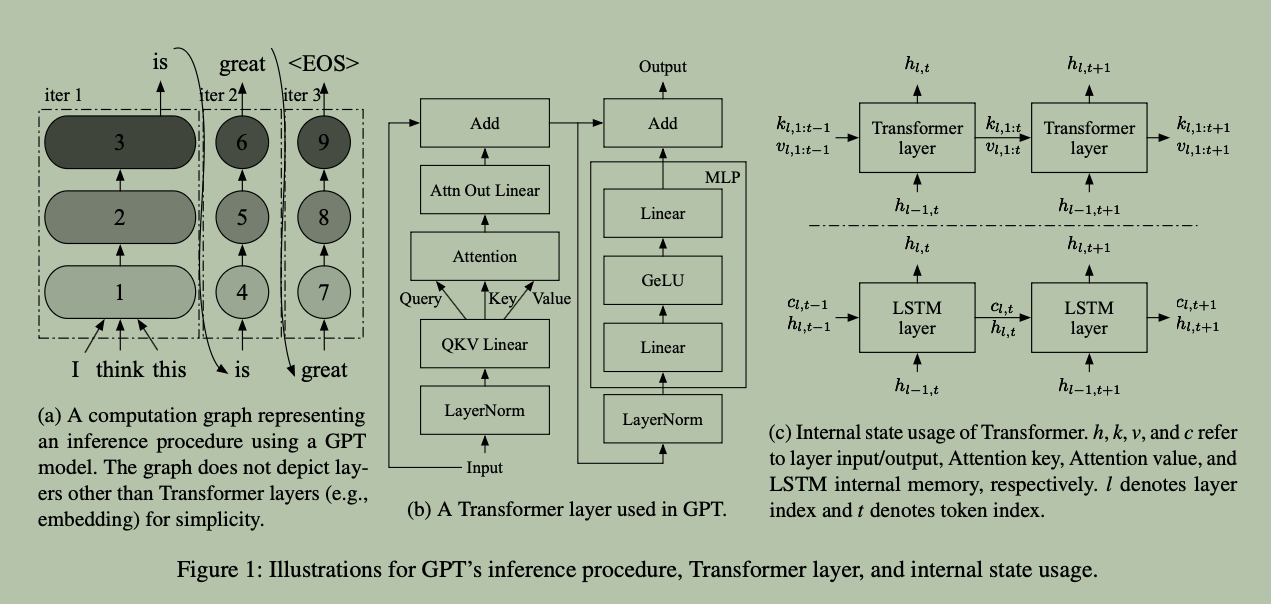
- 面向系统背景读者/reviewer 的 Transformer 模型结构/自回归推理过程/KV Cache 介绍,略。
ML inference serving systems 示意图
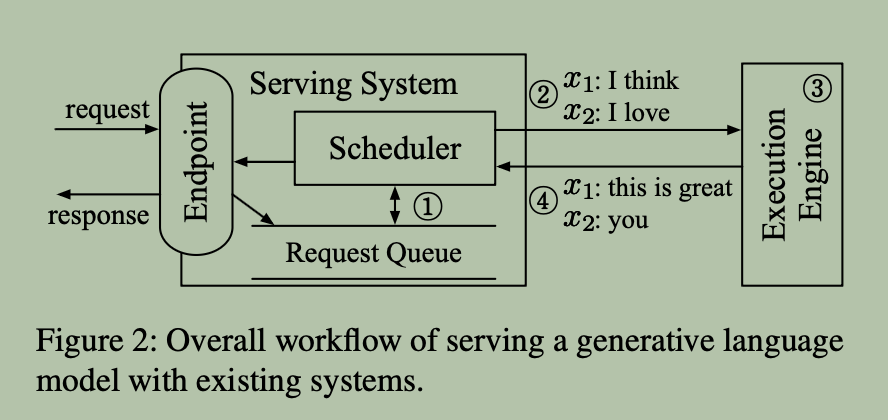
- 推理服务系统主要组成
- Scheduler:将若干个 request 组装为 batch 并调度执行引擎进行模型推理。
- 执行引擎:进行 batch 推理并返回生成结果给 scheduler。
3. Challenges and Proposed Solutions
针对已有系统存在的问题提出的两大解决方法:
- iteration-level scheduling
- selective batching
3.1 问题 1:Early-finished and late-joining requests 与解决方法:Iteration-level scheduling
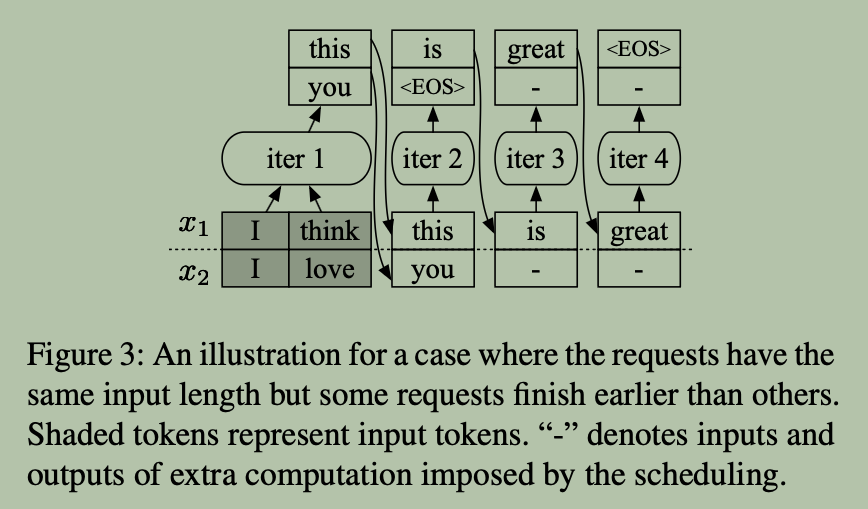
问题
- 已有系统的调度是以请求为粒度的,如上图所示,导致:
- 早退计算浪费:同 Batch 内请求所需的生成迭代数(Token 数量)不同。先生成完毕的短请求(Inactive requests)无法中途退出,引擎仍需对其进行空转或 Padding 等额外的无效计算。
- 端到端延迟增长:提前完成的请求无法立刻返回给客户端,必须挂起等待最长请求完成,产生了额外延迟。
- 新请求长时间排队:在当前 Batch 运行期间新到达的请求,无法中途“插队”,只能在队列中等待整个 Batch 完全结束。
解决方法:Iteration-level scheduling
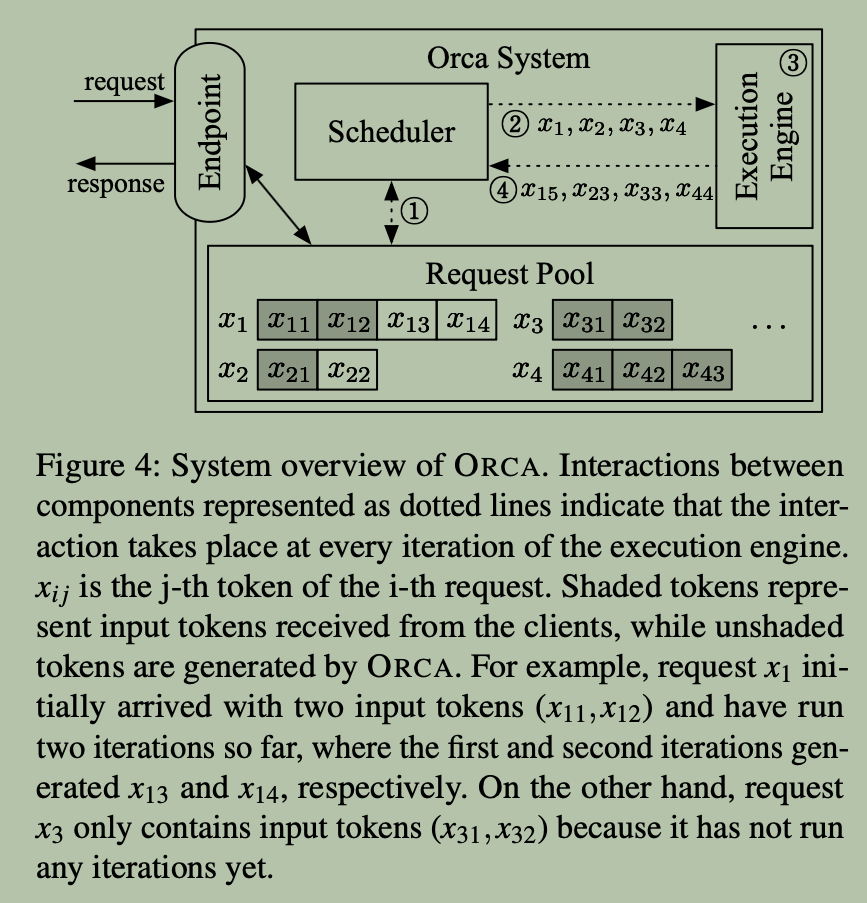
- 核心机制:将调度的基本单位从“请求级”下沉到
“迭代级(Iteration-level)”。调度器每轮循环重复三步:
- 选择下一轮要运行的请求集;
- 调用引擎仅执行模型单次迭代(Generation of 1 token);
- 接收该轮迭代的输出。
3.2 问题 2:Batching an arbitrary set of requests 与解决方法:Selective batching
问题
- 问题根源:迭代级调度允许随时将不同进度的请求混拼在同一个 Batch 中,但传统 Transformer 的 Batching 要求所有输入张量的形状必须完全一致。
- 三种无法直接 Batching 的张量冲突场景:
- 同在 Initiation 阶段(Prompt 处理):不同请求的输入 Prompt 长度不同,导致 Token 数量维度不匹配。
- 同在 Increment 阶段(Token 逐个生成):不同请求已生成的历史 Token 数量不同,导致 Attention 的 Key/Value 状态张量形状不同。
- 跨阶段混合(Initiation + Increment):Initiation 阶段需并行输入全部 Prompt Token,而 Increment 阶段每次只输入 1 个 Token,输入张量维度冲突。
解决方法:Selective batching
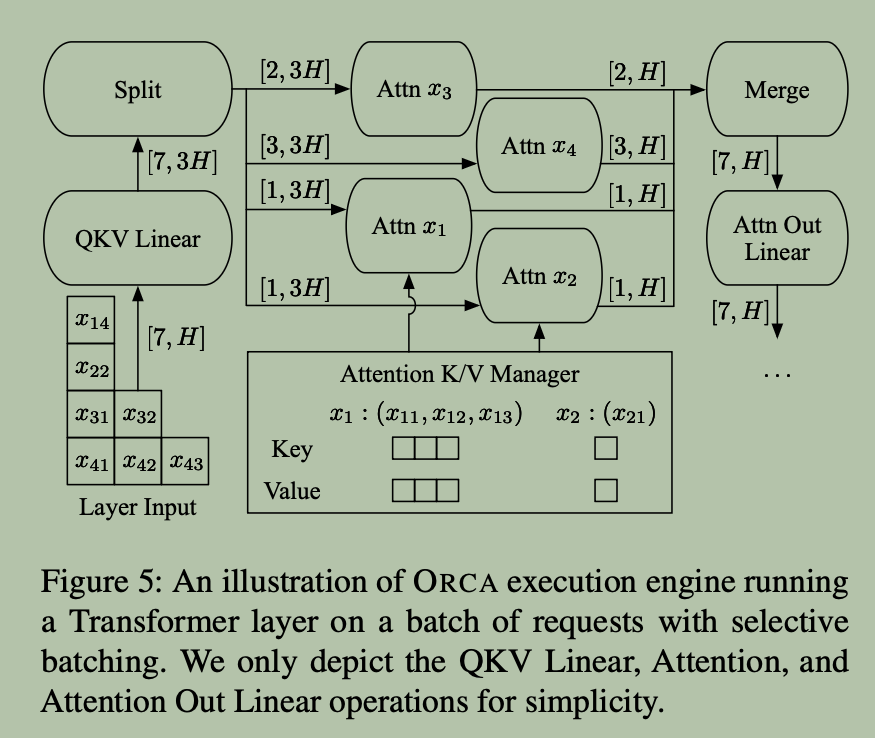
- 核心机制:针对 Transformer 内部不同算子的特性进行解耦,仅对特定算子实施批处理,而非强制全模型 Batchify。
- 无参数算子展平批处理(Non-Attention
Ops):Linear、LayerNorm、Add、GeLU 等算子不需要区分具体的
Request 维度。ORCA 将所有请求的 Token 展平成无显式 Batch 维度的二维张量
[∑L, H](其中
∑L为本轮所有请求 Token 数之和),统一进行大矩阵乘法与点素运算,最大化权重重用与 GPU 并行度。 - Attention 拆分独立计算(Attention Ops):Attention
算子需要区分 Request 维度以计算内部注意力并维护 KV 状态。ORCA 在
Attention 前插入 Split 算子,将张量按 Request
拆开独立计算 Attention;计算完成后通过 Merge
算子重新合并为
[∑L, H]矩阵继续后续层。 - 底层物理直觉:Attention 算子本身没有任何模型权重参数,将其拆开独立计算完全不会损失“跨请求复用模型权重”的显存带宽收益。同时配合 Attention K/V Manager 动态管理各请求的历史 KV Cache。
4. ORCA Design
4.1 Distributed Architecture
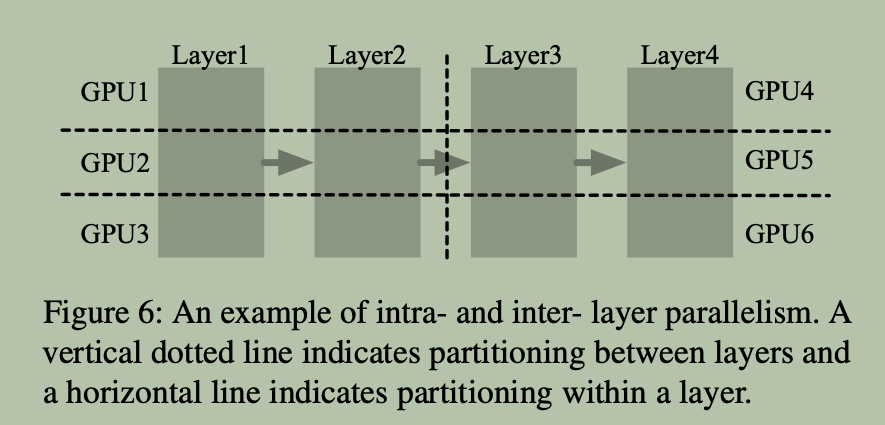
- 支持 TP & PP 进行大规模模型参数划分到多个 GPUs/Machines,如上图所示。
ORCA 架构
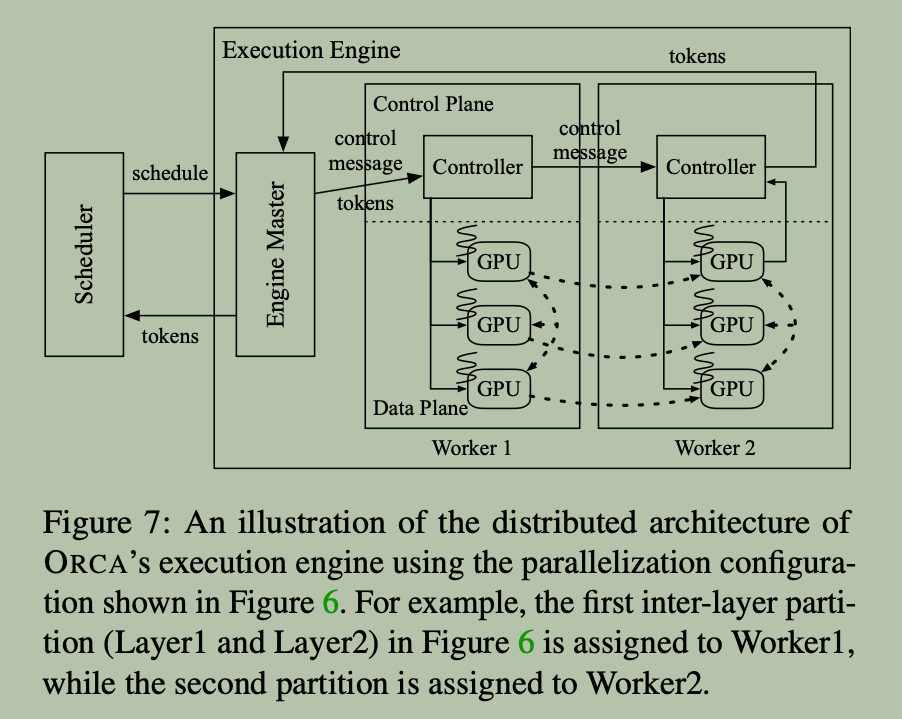
- Execution Engine:
- Engine Master:负责接收调度器的 Batch 指令,并将调度元数据(请求 ID、Token 索引、Initiation/Increment 状态等)下发给第一个 Worker。
- Worker Process:每个 Worker 进程负责模型的一个层间切片(Inter-layer partition)。每个 Worker 内部管理多个 CPU 线程,各自独立控制一张 GPU(线程数由层内并行度决定)。
- 控制面与数据面分离:
- 问题:
- 像 FasterTransformer 或 Megatron-LM 在分布式推理时,元数据(Batch 大小、序列长度等控制信息)是通过 NCCL 随 Tensor 一起传输的。这强制 CPU 每次发指令前都必须与 GPU 做同步,造成了 CPU-GPU 阻塞开销。
- ORCA Solution:
- 控制面(Control Plane):CPU 之间通过 gRPC 传输控制消息与 Token ID。Worker 1 的 Controller 在把 GPU Kernel 发送给本地 GPU 后,无需等待 GPU 算完,立刻通过 gRPC 将控制消息广播给 Worker 2 的 Controller,彻底抹平 CPU 阻塞。
- 数据面(Data Plane):GPU 之间仅在计算层间 Tensor 传递时,使用 NCCL 传输。
- 问题:
4.2 Scheduling Algorithm
调度算法同时考虑了:
- 最大 batchsize:以在 throughout 和 latency 之间取得平衡
- 剩余可用 KV Cache 容量
- 按照 FCFS 顺序进行请求调度
伪代码如下:
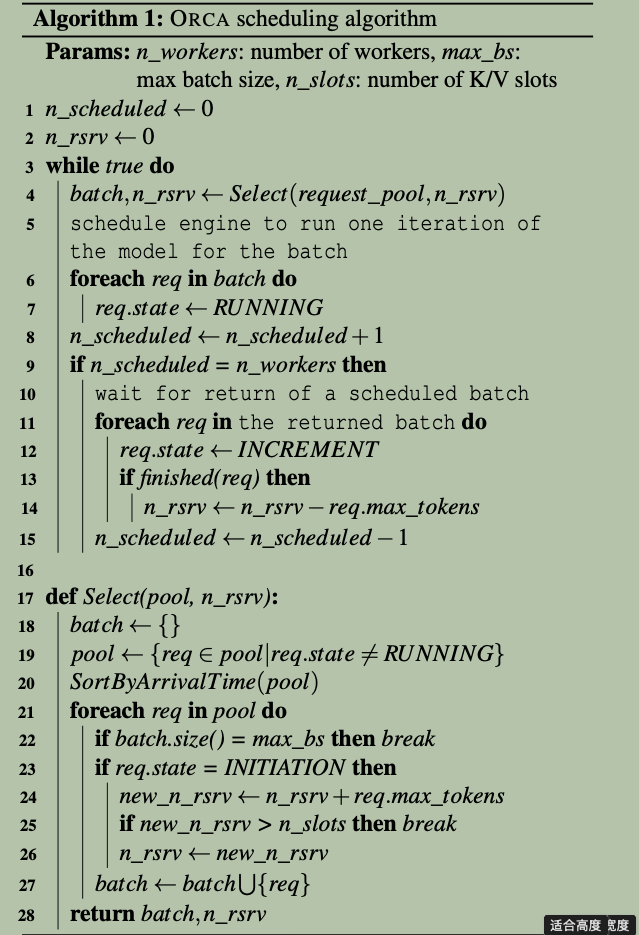
- 为了限制 KV Cache 容量占用,需要设置 request 的最大 token 长度属性
max_tokens以事先为每个 request 分配 KV Cache 显存。- -> 后续 vLLM & PagedAttention 解决的问题。
Pipeline parallelism
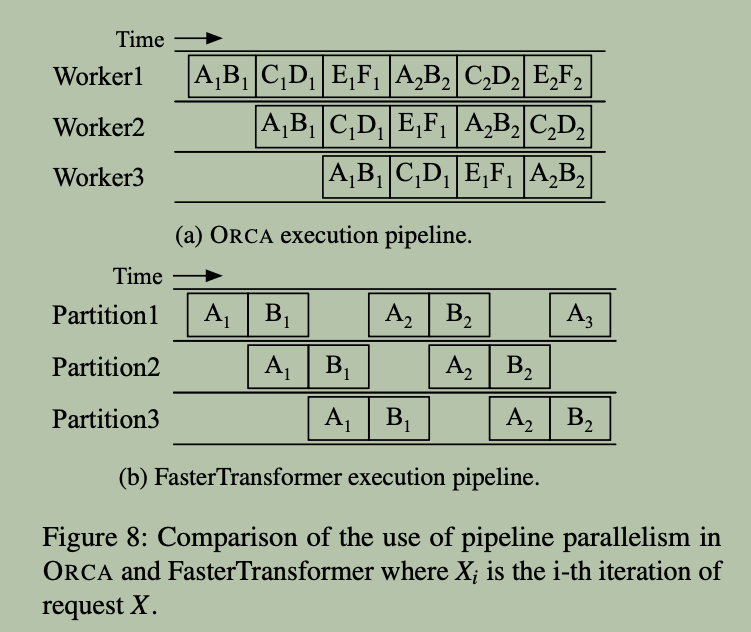
- 已有方案及存在的问题:
- 在多 Worker(多流水线 stage)场景下,传统 FasterTransformer 为了填满流水线,必须将一个静态 Batch 强行切分成多个 Microbatch,这不仅降低了 Batching 效率,还容易因为 Microbatch 数量不足而产生气泡。
- ORCA:
- 调度器允许当前引擎中同时在跑的 Batch 数量达到
n_workers(Worker 节点数)。 - 调度器连续向 Worker 1 注入 Batch AB、Batch CD、Batch EF;Worker 1 算完 Batch AB 的第 1 轮迭代后,不必等待整批算完,立刻接手算 Batch CD 的第 1 轮迭代。
- 整个过程完全不需要对单个 Batch 做 Microbatch 切分,既保持了大 Batch 矩乘的高硬件利用率,又彻底消除了流水线等待气泡。
- 调度器允许当前引擎中同时在跑的 Batch 数量达到
5. Evaluation
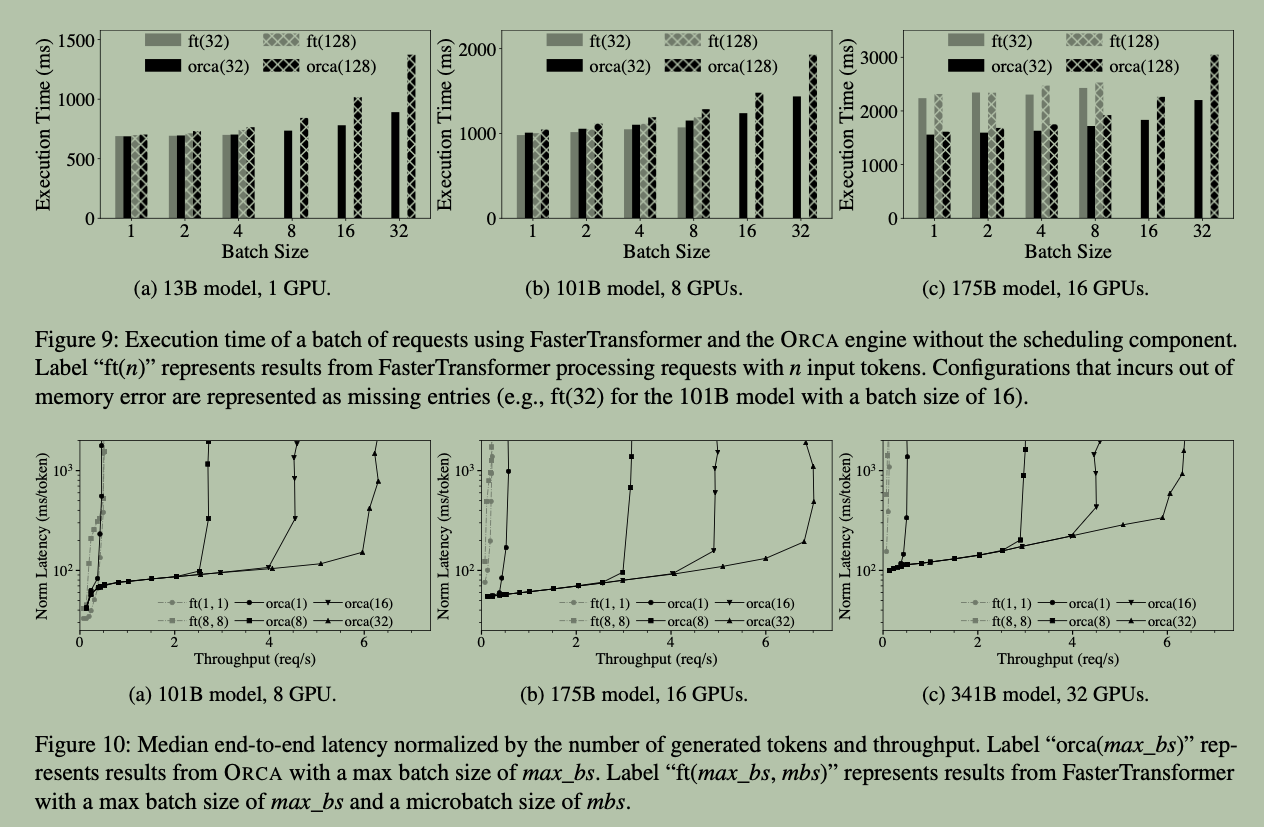
- ORCA 在各个配置下均优于 FasterTransformer。
6. Conclusion
- ORCA
- Contiguous Batching(iteration-level schedule 替代原本的
request-level schedule)
- 减少了 batch 内早结束 request 的 latency;
- 减少了请求队列内 request 排队 latency。
- Selective Batching
- Attention op 不进行 request 间 batch;
- 其他 op 进行 batch。
- Contiguous Batching(iteration-level schedule 替代原本的
request-level schedule)