OnlineSoftmax: Online normalizer calculation for softmax
- Online normalizer calculation for softmax
- arXiv 发布日期:8 May 2018
- 代码:online-softmax
- 作者:
摘要:
Softmax 函数在机器学习中无处不在,此前多项研究曾为其提出过更快的替代方案。在本文中,我们提出了一种以更少内存访问(访存)次数计算经典 Softmax 的方法,并假设这种访存开销的降低能够提升 Softmax 在实际硬件上的性能。基准测试证实了这一假设:Softmax 单算子加速高达 1.3 倍,而结合并融合后的 Softmax+TopK 算子加速高达 5 倍。
1. Introduction
- Safe Softmax 三趟遍历实现存在的问题:
- 内存访问次数多,kernel 是内存带宽受限的。
- 本文提出的 Online Softmax:
- 一次遍历同时求出 max + sum(exp),然后一次遍历计算概率,减少了内存访问次数。
2. Original softmax
朴素 Softmax(Naive Softmax)与访存开销
Softmax 函数定义为 \(y_i = \frac{e^{x_i}}{\sum_{j=1}^V e^{x_j}}\)。
- 算法流程:需要对输入向量进行 2
次遍历:
- Pass 1:扫描输入向量,累加计算归一化分母 \(d_V = \sum_{j=1}^V e^{x_j}\)。
- Pass 2:再次扫描输入向量,计算每个元素的最终概率 \(y_i = \frac{e^{x_i}}{d_V}\) 并写入内存。
- 访存统计:每个向量元素产生 3 次内存访问(2 次 Load 读取 + 1 次 Store 写入)。
数值稳定性问题(Overflow / Underflow)
在实际硬件中,由于浮点数表示范围有限,朴素算法在计算指数 \(e^{x_j}\) 时极易发生数值上溢(Overflow)或下溢(Underflow)。
Safe Softmax 及其访存瓶颈
为了防止指数溢出,主流实现采用了数值安全的变形形式:在求指数前先减去向量的最大值 \(m_V = \max_{k=1}^V x_k\),即 \(y_i = \frac{e^{x_i - m_V}}{\sum_{j=1}^V e^{x_j - m_V}}\)。
- 主流框架支持:包括 TensorFlow、PyTorch (Caffe2)、MXNet、CNTK 和 Chainer 在内的主流深度学习框架均默认使用该安全版本。
- 算法流程:为了获取全局最大值 \(m_V\),不得不进行 3
次遍历:
- Pass 1:扫描向量,求解全局最大值 \(m_V = \max_{k=1}^V x_k\)。
- Pass 2:再次扫描向量,计算基于 \(m_V\) 的归一化分母 \(d_V = \sum_{j=1}^V e^{x_j - m_V}\)。
- Pass 3:第三次扫描向量,计算概率 \(y_i = \frac{e^{x_i - m_V}}{d_V}\) 并写回显存。
- 访存瓶颈:提前求解 \(m_V\) 的要求导致每个元素产生 4 次内存访问(3 次 Load + 1 次 Store)。
3. Online normalizer calculation
The algorithm 3 calculates both the maximum value \(m\) and the normalization term \(d\) in a single pass over input vector with negligible additional cost of two operations per vector element.
3.1 算法流程
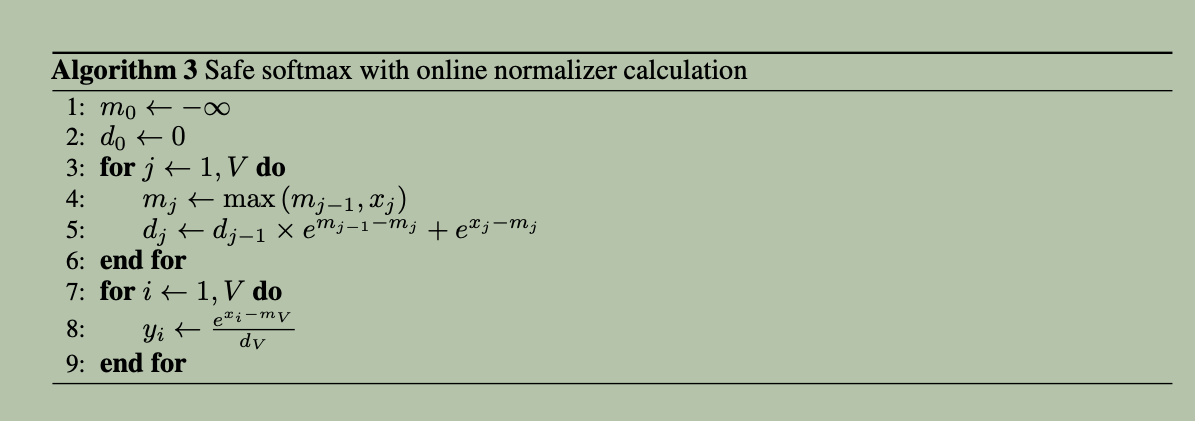
- 单 Pass 同步更新:受计算在线动态方差的 Welford 算法启发,在单次扫描输入向量时,同时维护“当前局部最大值 \(m\)”与“局部归一化分母 \(d\)”。
- 动态对齐递推式: 在遍历第 \(j\) 个元素 \(x_j\) 时,通过指数差值对旧累加和进行缩放修正: \[m_j = \max(m_{j-1}, x_j)\] \[d_j = d_{j-1} \cdot e^{m_{j-1} - m_j} + e^{x_j - m_j}\]
- 访存缩减:将 Safe Softmax 的访存次数从 4 次(3 Load + 1 Store)直接降低到 3 次(2 Load + 1 Store)。
3.2 归纳法证明
- 基础步(Base Case, \(V=1\)): \(m_1 = x_1\),\(d_1 = e^{x_1 - m_1} = e^0 = 1 = \sum_{j=1}^1 e^{x_j - m_1}\),成立。
- 归纳假设(Inductive Step): 假设对 \(V = S-1\) 成立,即 \(m_{S-1} = \max_{k=1}^{S-1} x_k\),且 \(d_{S-1} = \sum_{j=1}^{S-1} e^{x_j - m_{S-1}}\)。
- 递推推导(当 \(V=S\) 时): 根据算法,\(m_S = \max(m_{S-1}, x_S)\)。 将归纳假设代入递推式 \(d_S = d_{S-1} \cdot e^{m_{S-1} - m_S} + e^{x_S - m_S}\):
\[ d_S = \left( \sum_{j=1}^{S-1} e^{x_j - m_{S-1}} \right) \cdot e^{m_{S-1} m_S} + e^{x_S - m_S} \] 展开乘项:
\[ d_S = \sum_{j=1}^{S-1} \left( e^{x_j - m_{S-1}} \cdot e^{m_{S-1} - m_S} \right) + e^{x_S - m_S} = \sum_{j=1}^{S-1} e^{x_j - m_S} + e^{x_S - m_S} = \sum_{j=1}^S e^{x_j - m_S} \]
证毕。
数值安全性保证:
- 运行最大值 \(m_j\) 被严格限定在原始向量的极值范围内,不会发生上下溢。
- 局部分母满足 \(1 \le d_j \le j\),使用单精度浮点数(FP32)存储时,可以支持处理高达 \(1.7 \times 10^{37}\) 个元素而不发生溢出。
3.3 并行化扩展
为适配 GPU 等高度并发的计算硬件,将串行递推推广为二元结合算子 \(\oplus\):
\[ \begin{bmatrix} m_i \\ d_i \end{bmatrix} \oplus \begin{bmatrix} m_j \\ d_j \end{bmatrix} = \begin{bmatrix} \max(m_i, m_j) \\ d_i \cdot e^{m_i - \max(m_i, m_j)} + d_j \cdot e^{m_j - \max(m_i, m_j)} \end{bmatrix} \]
- 结合律与交换律:算子 \(\oplus\) 满足结合律与交换律。
- GPU 树状归约:基于此性质,可以在 CUDA kernel Thread Block 内部使用树状归约在多线程间并行计算全局的 \(m_V\) 和 \(d_V\),完全解除了串行依赖。
4. Softmax and top-k fusion
问题背景:
- 自回归推理需求:在大语言模型或自动回归模型的解码推理阶段(如 Beam Search 或 TopK 采样),Softmax 算子后面通常紧跟一个 TopK 算子。
- 传统计算的冗余:TopK 的目标是从概率向量 \(y\) 中找出前 \(K\) 个最大概率值 \(v\) 及其对应的索引 \(z\)。然而,传统的 Safe Softmax 必须将全部 \(V\) 个元素的 Softmax 概率值 \(y_i\) 完整算出来并写回显存。绝大多数非 TopK 元素的概率计算与显存读写都是完全冗余的。
融合算法流程
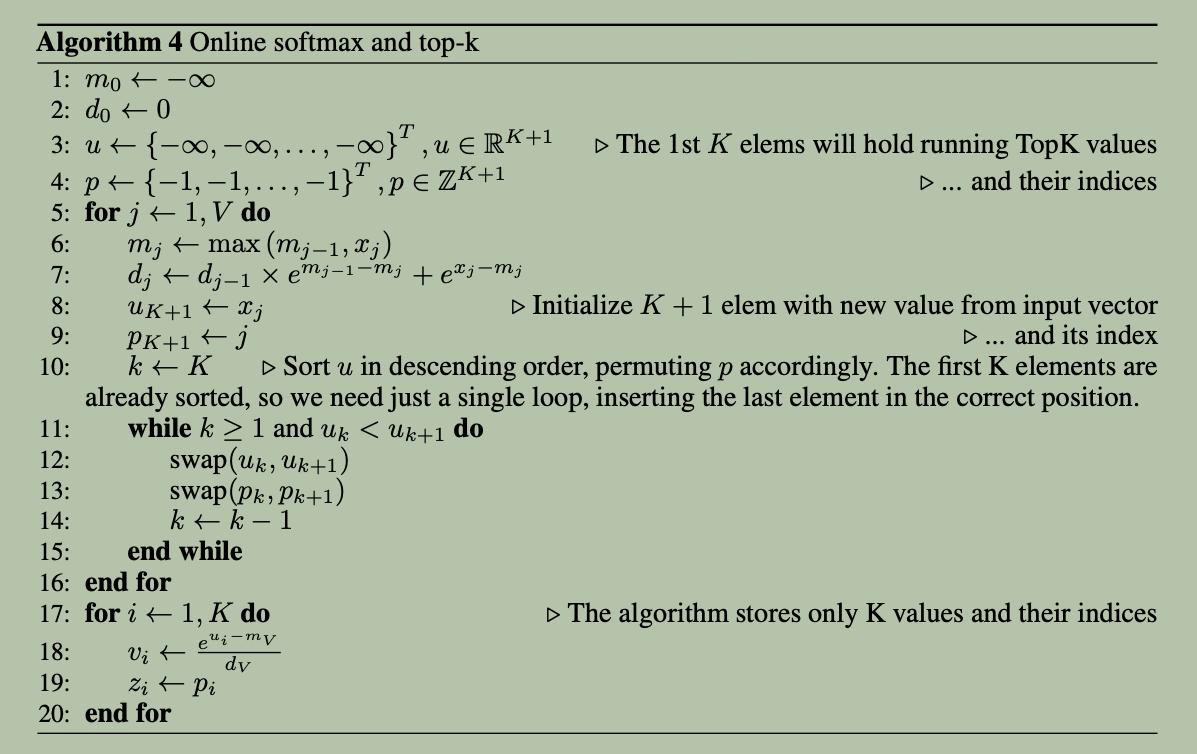
- 初始化片上状态:
- 设置局部最大值 \(m_0 = -\infty\),局部分母 \(d_0 = 0\)。
- 在片上(寄存器/Shared Memory)分配长度为 \(K+1\) 的数组 \(u\)(保存当前 Logits 值)和 \(p\)(保存对应索引)。
- 单次主循环遍历 (\(j = 1
\dots V\)):
- 更新 Online Normalizer:读取 \(x_j\),按 Online Softmax 公式更新局部最大值 \(m_j\) 和动态缩放分母 \(d_j\)。
- 插入新元素:将新元素 \(x_j\) 及其索引 \(j\) 填入片上数组 \(u\) 和 \(p\) 的第 \(K+1\) 个位置。
- 单趟冒泡插入排序:由于前 \(K\) 个元素已经保持降序,只需运行一次
while循环,将第 \(K+1\) 个元素向上冒泡交换(swap)到正确位置即可。
- 最终输出计算:
- 遍历完成后,片上已拿到了全局最大值 \(m_V\)、全局分母 \(d_V\) 以及前 \(K\) 个最大 Logits \(u_1 \dots u_K\)。
- 仅对这 \(K\) 个最终选出的元素计算概率 \(v_i = \frac{e^{u_i - m_V}}{d_V}\) 并写回显存。
访存次数降低分析
| 方案模式 | 运行机制 | 单元素显存访存次数 |
|---|---|---|
| Safe Softmax + TopK (Unfused) | Safe Softmax 做 3 次 Pass(3 读 1 写 = 4 次),TopK 读入概率(1 读 = 1 次)。 | 5 次 |
| Online Softmax + TopK (Unfused) | Online Softmax 做 2 次 Pass(2 读 1 写 = 3 次),TopK 读入概率(1 读 = 1 次)。 | 4 次 |
| Online Softmax + TopK (Fused) | 单次 Pass 融合:片上同步维护归一化分母与 TopK 队列,跳过全量概率写回。 | 1 次 |
5. Benchmarking
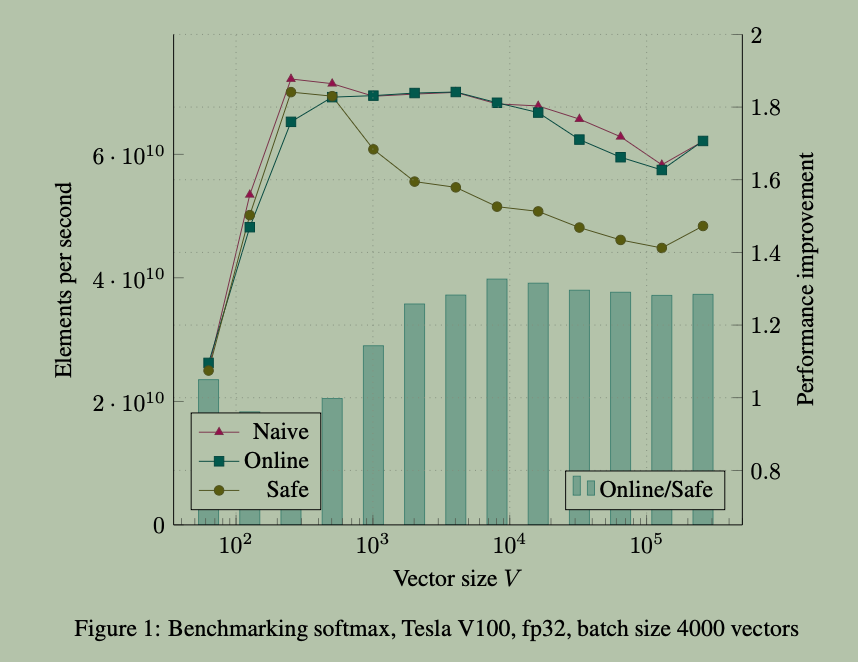
- 大 Batch 结果:
- 当向量维度 \(V < 1000\) 时,三种算法性能基本持平,数据能较好地命中片上 L1/L2 Cache。
- 当 \(V \ge 1000\) 时,Profiler 显示发生了 Cache 溢出(Cache Thrashing),计算转变为彻底的 DRAM 主显存带宽受限(DRAM Bandwidth Limited)。
- 此时 Online 和 Naive 算法显著超越 Safe Softmax,在 \(V = 4000\) 时达到了 ~1.3x 的物理加速,高度贴近访存降低 1.33x(4 次降至 3 次)的理论极限。
- 小 Batch 结果:
- 在 GPU 未饱满利用、受限于延迟的环境下,当 \(V \ge 1000\) 后,Online Softmax 依然比 Safe Softmax 稳定快 ~1.15x,证明减少显存访存即使在 Latency 占主导的场景下依然能带来物理收益。
6. 代码实现
1 | |
7. Online Softmax 在 FlashAttention 中应用
参考:
7.1 Self-Attention 回顾
忽略 Batch 和 Head 维度(这两个维度天然可以并行),Self-Attention 定义为
\[ O = \text{softmax}(Q K^T) V \]
其中,\(Q, K, V, O\) 均为形状为 \([L, D]\) 的二维矩阵,其中 \(L\) 为序列长度(Sequence Length),\(D\) 为 Head 维度(Head Dimension)。Softmax 作用于矩阵的最后一个维度(即对 \(Q K^T\) 矩阵按行归一化)。
标准的自注意力计算在硬件实现中通常被拆解为 3 个独立阶段:
\[ X = Q K^T \\ A = \text{softmax}(X) \\ O = A V \]
其中,\(X\) 为 logits 矩阵,\(A\) 为 Attention Score 矩阵,\(O\) 为输出矩阵。
根据 Self-Attention 的上述定义式,可以得到以下结论:
- 输出矩阵 \(O\) 中每个 Token 的第
\(d\) 维元素,就是 \(V\) 矩阵中第 \(d\) 列所有行(所有 Token)的加权和。
- 输出矩阵 \(O\) 的每一行作为一个 \(d\) 维行向量,都可以看作根据 Attention Score \(A\) 对矩阵 \(V\) 中的 \(L\) 个 \(d\) 维行向量做加权累加得到。
- 输出矩阵 \(O\) 的第 \([i, j]\) 个元素,来自 \(Q\) 的第 \(i\) 行,矩阵 \(K^T\) 所有列(整个矩阵),矩阵 \(V\) 的第 \(j\) 列。
普通矩阵分块(Tiling)与 Softmax 的矛盾
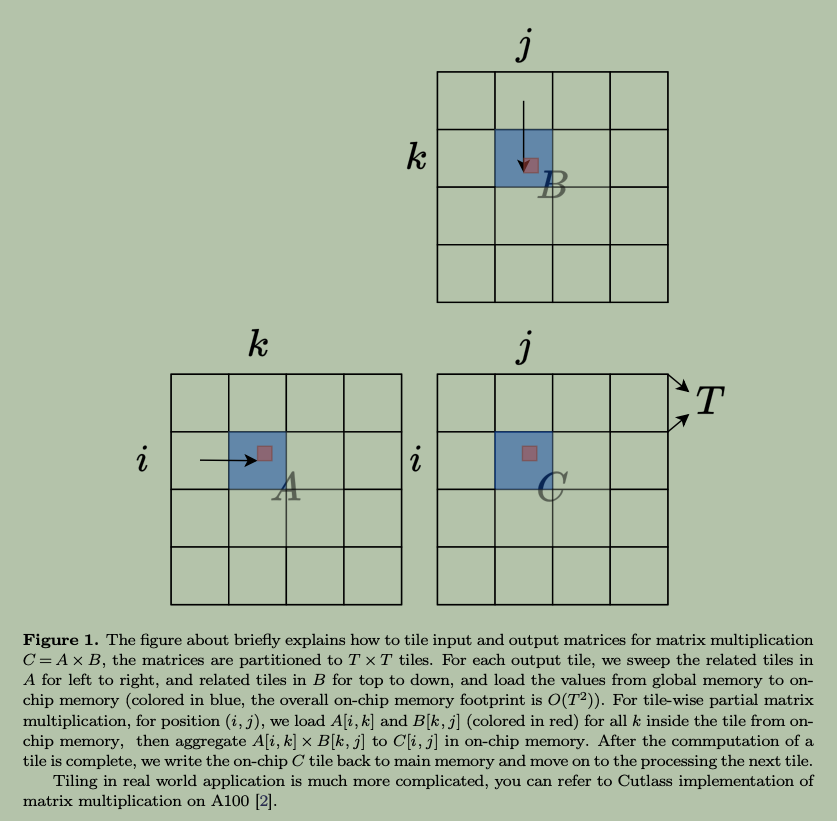
- 普通矩阵乘法易于分块:在传统矩阵乘法 \(C = A B\) 中,由于加法满足结合律,可以轻松将矩阵切分成 \(T \times T\) 的小块(Tiles)逐块载入片上 SRAM 计算并累加,片上显存开销仅为 \(O(T^2)\),与全局矩阵大小无关。如上图所示。
- Softmax 破坏结合律:Self-Attention 包含 Softmax 归一化算子,由于 Softmax 依赖全局最大值和归一化分母,不具备直接的结合律,导致朴素的分块矩阵乘法无法直接应用于 Attention 算子。
核心问题与 FlashAttention 的动机
标准实现需要在全局显存(HBM)中完整实例化并保存巨大的 \(X\) 和 \(A\) 矩阵。而 FlashAttention 的突破在于完全不向全局显存写回中间矩阵 \(X\) 和 \(A\),而是将整个计算融合在单个 CUDA Kernel 中。这就引出了核心问题:是否有办法重构算法,让 Softmax 具备类似结合律的性质,从而实现片上分块计算?
7.2 FlashAttention
7.2.1 Multi-pass Self-Attention
首先考虑如何利用 Online Softmax 多次遍历 \(Q, K, V\) 进行 Self-Attention 计算,算法流程如下:
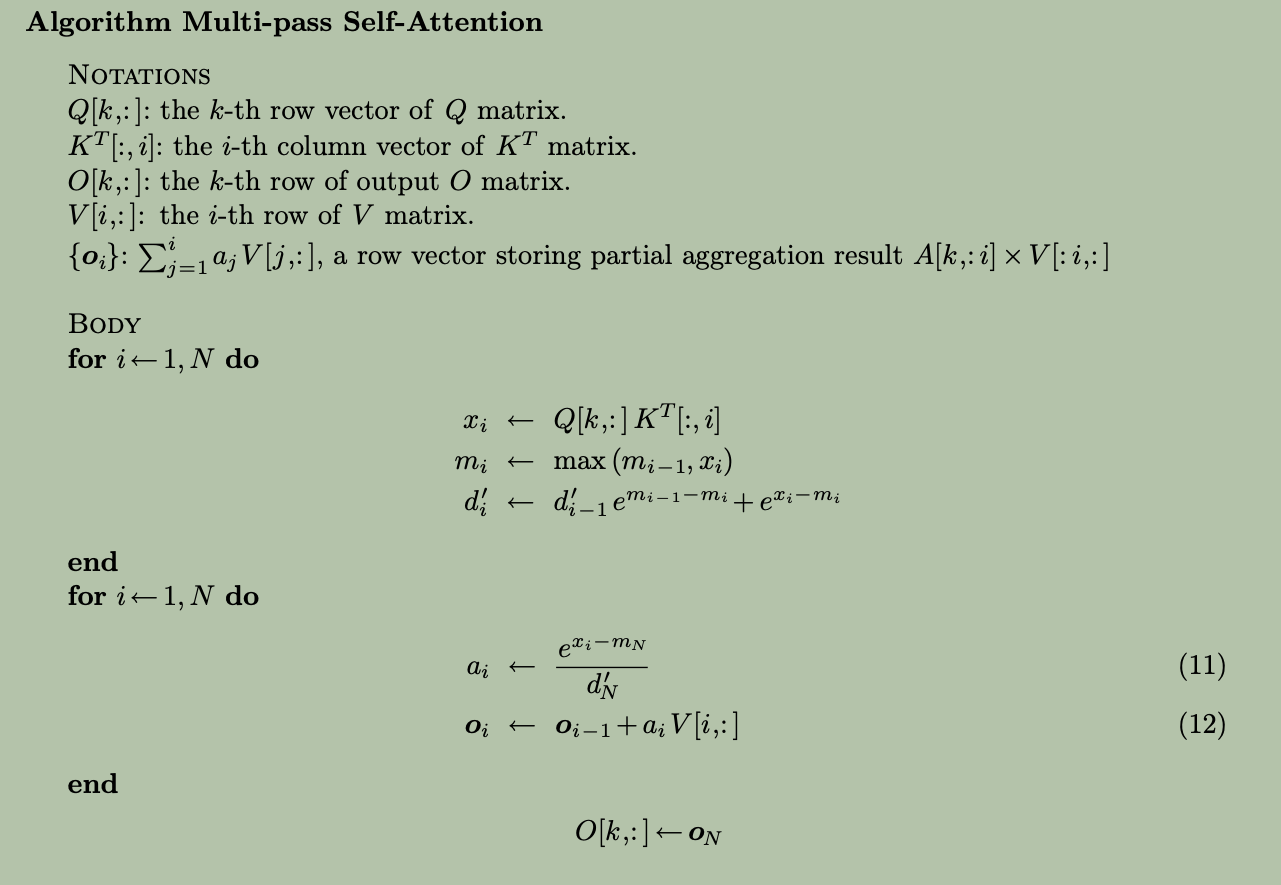
相关符号含义和算法整体流程说明如下:
- 算法目标与符号说明:
- 目标:计算输出矩阵 \(O\) 的第 \(k\) 行结果,即:\(O[k,:]\) 。
- 其他符号:
- \(O[k,:]\) 的计算依赖于矩阵 \(A\) 的第 \(k\) 行和矩阵 \(V\) 的所有列。
- 矩阵 \(A\) 第 \(k\) 行依赖于矩阵 \(Q\) 的第 \(k\) 行,即:\(Q[k,:]\) ,以及矩阵 \(K^T\) 的所有列。
- \(\mathbf{o}_i = \sum_{j=1}^i a_j V[j, :]\) 表示存储部分累加结果 \(A[k,:i] \times V[:i,:]\) 的行向量(长度为 \(D\))。
- 算法流程:
- 第一次遍历:
- 首先沿着矩阵 \(K^T\) 的每一列 \(K^T[:,i]\),计算 logits \(x_i\) ;
- 利用 Online Softmax 公式计算 \(m_i\) 和 \(d_i'\) ;
- 第二次遍历:沿着矩阵 \(A\) (的第
\(k\) 行)的每一列元素 \(a_i\) 和矩阵 \(V\) 的每一行 \(V[i,:]\)
- 基于最大值 \(m_N\) 和归一化项 \(d_N'\) 计算 \(a_i\) ;
- 更新 \(\mathbf{o}_i\) :\(\mathbf{o}_i = \mathbf{o}_{i-1} + a_i V[i, :]\) ;
- 保存最终结果:
- \(O[k,:] \leftarrow \mathbf{o}_N\) 。
- 第一次遍历:
将上面算法中的公式 12 进行等价变换,得到: \[ \mathbf{o}_i = \sum_{j=1}^i a_j V[j, :] = \sum_{j=1}^i \frac{e^{x_j - m_N}}{d'_N} V[j, :] \] 这一形式仍然依赖于全局常数 \(m_N\) 和 \(d'_N\) 。
仿照 Online Softmax 形式进行变换,定义局部替代输出序列 \(\mathbf{o}'_i\) :
\[ \mathbf{o}'_i := \sum_{j=1}^i \frac{e^{x_j - m_i}}{d'_i} V[j, :] \] 其中:
- 分子只减去当前局部最大值 \(m_i\);
- 分母只除以当前局部归一化分母 \(d'_i\)。
现在,建立 \(\mathbf{o}'_i\) 与上一步 \(\mathbf{o}'_{i-1}\) 之间的递推关系。把 \(\mathbf{o}'_i\) 拆成“历史前 \(i-1\) 项”与“当前第 \(i\) 项”: \[ \begin{aligned} \mathbf{o}'_i &= \sum_{j=1}^i \frac{e^{x_j - m_i}}{d'_i} V[j, :] \\ &= \left( \sum_{j=1}^{i-1} \frac{e^{x_j - m_i}}{d'_i} V[j, :] \right) + \frac{e^{x_i - m_i}}{d'_i} V[i, :] \\ &= \left( \sum_{j=1}^{i-1} \frac{e^{x_j - m_{i-1}} e^{m_{i-1} - m_i}}{d'_i} V[j, :] \right) + \frac{e^{x_i - m_i}}{d'_i} V[i, :] \\ &= \left( \sum_{j=1}^{i-1} \frac{e^{x_j - m_{i-1}}}{d'_{i-1}} V[j, :] \right) \frac{d'_{i-1} e^{m_{i-1} - m_i}}{d'_i} + \frac{e^{x_i - m_i}}{d'_i} V[i, :] \\ &= \mathbf{o}'_{i-1} \frac{d'_{i-1} e^{m_{i-1} - m_i}}{d'_i} + \frac{e^{x_i - m_i}}{d'_i} V[i, :] \qquad (14) \end{aligned} \]
7.2.2 FlashAttention
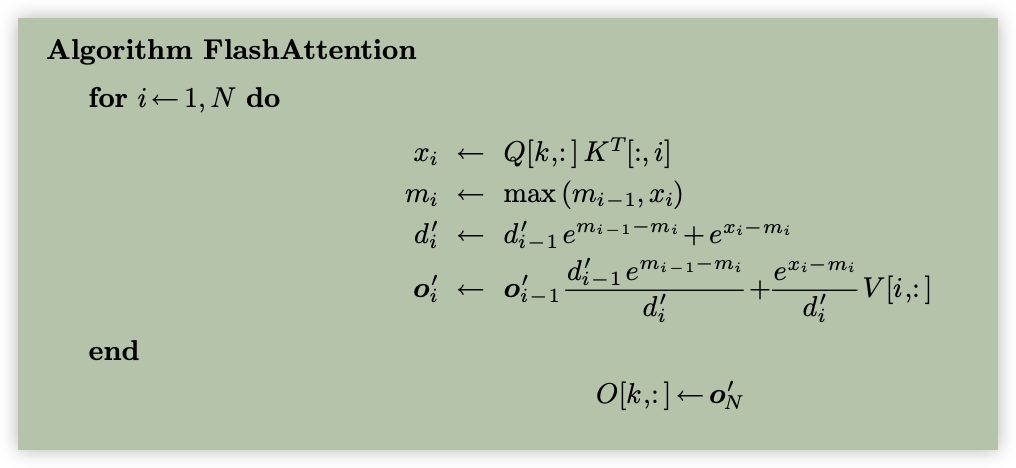
单次遍历递推公式: \[ \mathbf{o}'_i = \mathbf{o}'_{i-1} \cdot \underbrace{\left( \frac{d'_{i-1} e^{m_{i-1} - m_i}}{d'_i} \right)}_{\alpha: \text{历史输出 Rescaling 衰减}} + V[i, :] \cdot \underbrace{\left( \frac{e^{x_i - m_i}}{d'_i} \right)}_{\beta: \text{新 Value 物理权重}} \]
这个递推式仅依赖 \(d'_{i-1}, d'_i, m_{i-1}, m_i, x_i\) 和当前 Value 向量 \(V[i, :]\)。所有的依赖全部解开,自注意力机制的完整计算(点积 \(\to\) Softmax \(\to\) 乘 \(V\))可以在单次主循环(Single Pass)内一次遍历完成。
7.2.3 FlashAttention (Tiling)
相关符号:
- \(b\) 表示一个 tile block 大小;
- \(\text{\#tiles}\) 表示一行的 tile 数量,即:\(N = b \times \text{\#tiles}\) ;
- \(\mathbf{x}_i\) 为行向量,表示当前第 \(i\) 个 tile 块内包含的 \(b\) 个未归一化点积 Logits: \(\mathbf{x}_i = Q[k, :] K^T[:, (i-1)b : i b]\) ;
- \(m_i^{(\text{local})}\) 表示当前第 \(i\) 个 tile 块内部 \(b\) 个 Logits 的局部最大值: \(m_i^{(\text{local})} = \max_{j=1}^b \mathbf{x}_i[j]\) ;
则按 tile 的 FlashAttention 算法流程为:
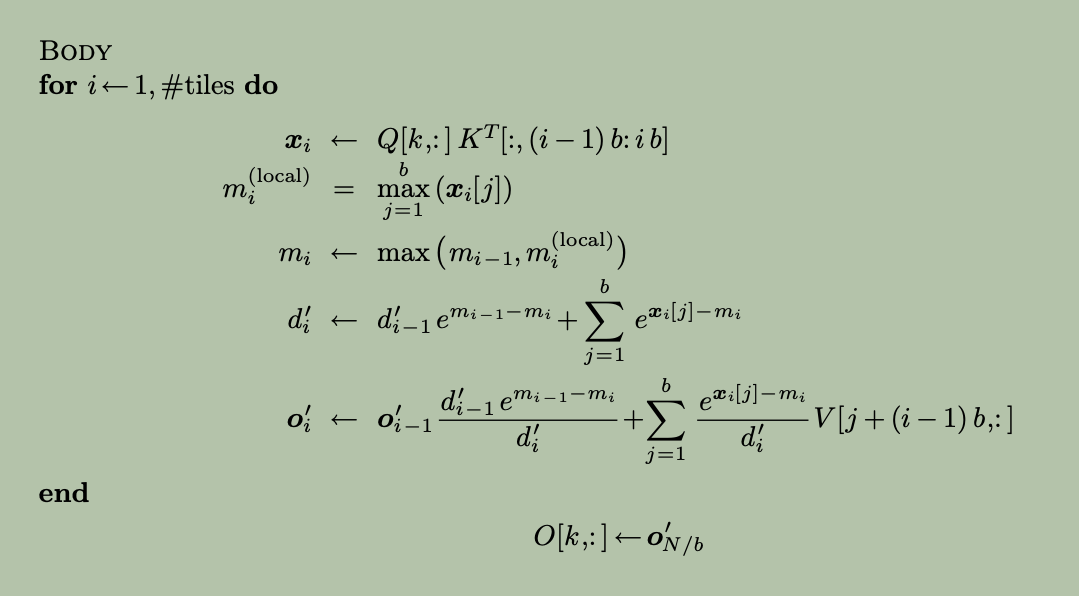
设 \(Q[k, :]\) 为待计算行,将 \(K^T\) 和 \(V\) 沿序列长度拆分为若干个尺寸为 \(b\) 的数据块,在遍历第 \(i\) 个 tile(覆盖索引 \([(i-1)b : i b]\))时:
- SRAM 计算局部点积向量:\(\mathbf{x}_i = Q[k, :] K^T[:, (i-1)b : i b]\)。
- 片上提取局部最大值:\(m_i^{(\text{local})} = \max_{j=1}^b \mathbf{x}_i[j]\)。
- 刷新全局最大值:\(m_i = \max(m_{i-1}, m_i^{(\text{local})})\)。
- 累加全局分母: \[d'_i = d'_{i-1} e^{m_{i-1} - m_i} + \sum_{j=1}^b e^{\mathbf{x}_i[j] - m_i}\]
- Tile 级片上输出矩阵 Rescaling 覆盖: \[\mathbf{o}'_i = \mathbf{o}'_{i-1} \cdot \left( \frac{d'_{i-1} e^{m_{i-1} - m_i}}{d'_i} \right) + \sum_{j=1}^b V[j + (i-1)b, :] \cdot \left( \frac{e^{\mathbf{x}_i[j] - m_i}}{d'_i} \right)\]
循环结束时,\(o'_{N/b}\) 即为最终精准无损的注意力输出向量。
映射到硬件,示意图如下:
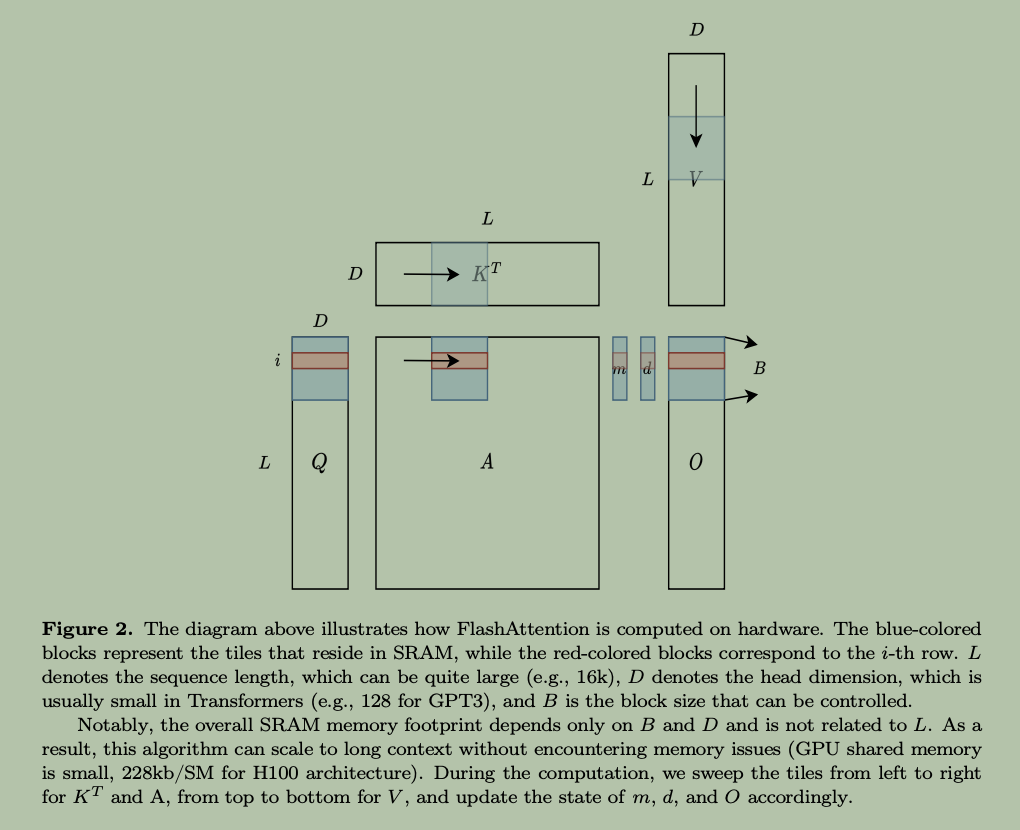
算法扫描过程与存储位置示意如下:
1 | |
- 显存占用与序列长度 \(L\) 解耦: 在 SRAM 中,片上常驻的中间变量仅有 \(Q_i\) 块、\(K_i^T\) 块、\(V_i\) 块以及局部向量 \(m, d, O_i\)。 片上 SRAM 的空间复杂度仅为 \(\mathcal{O}(B \cdot D)\)(其中 \(B\) 为块大小,\(D\) 为 Head 维度)。显存占用与长上下文 \(L\) 解耦,这使得 Transformer 处理百万级超长上下文成为可能。
- 零显存中间矩阵实例化: 大小为 \(L \times L\) 的中间矩阵 \(X\)(Logits)和 \(A\)(Softmax 概率)只在 SRAM 中随算随擦,全过程 0 次回写 HBM 全局显存。
- 极简硬件数据流: 硬件只需要沿着 \(K^T\) 从左向右扫、沿着 \(V\) 从上向下扫,以单向流式的方式在片上做 Rescaling 覆盖,就能完成原本需要 GB 级显存数据搬运的全局注意力计算。
上述为一个 SM/block 内 FlashAttention 执行流程,扩展到 grid 以及细化到具体 warp/thread 执行流程如下:
顶层:Grid 级并行(SM / Block 的三维扩展)
由于注意力机制在不同 Batch、不同 Head 以及 Query 的不同行之间没有任何数据写冲突,FlashAttention 在 GPU 全局发射 CUDA Grid 时,直接在三个维度上展开并行:
\[ \text{Grid Dim} = \left( \underbrace{\lceil L / B_r \rceil}_{\text{Q 序列分块数}}, \; \underbrace{\text{Num\_Heads}}_{\text{多头数量}}, \; \underbrace{\text{Batch\_Size}}_{\text{批次大小}} \right) \]
- 物理分发:GPU 上的硬件调度器(GigaThread Engine)会将这成千上万个 Thread Block 动态分发到 GPU 的几十上百个 SM(Streaming Multiprocessors) 上同时执行。
- 独立计算:每个 Thread Block 拿到属于自己的 \((b, h, i)\) 坐标,只负责计算 Batch \(b\)、Head \(h\) 下第 \(i\) 个 Q 块(大小为 \(B_r \times D\))对应的输出 \(O_i\)。
中层:Block 级协作(HBM \(\to\) SRAM 协同加载)
进入单个 SM 内,一个 Thread Block(通常包含 128 ~ 256 个线程,即 4 ~ 8 个 Warp)共同管理一片共享内存(SRAM):
- 协同搬运 (Cooperative Load):Block
内的所有线程/Warp 合作,以向量化指令(如
LDG.128或 Hopper 架构上的 TMA 异步拷贝指令)将全局显存(HBM)中的 \(Q_i\) 块以及当前的 \(K_j^T, V_j\) 块批量搬运至 Shared Memory。 - 流式循环:在 Block 内部,通过
__syncthreads()或异步屏障同步,沿着 KV 序列方向(Tile by Tile)流动扫描,完成片上动态 Rescaling 修正。
底层:Warp / Thread 级分工(Tensor Core 计算)
在 Shared Memory 拿到 Tile 数据后,Block 内部的 Warp 会进行更加细致的切割分工(Warp Partitioning):
- 行维度瓜分:在 FlashAttention-2 的内核设计中,Block 内部的多个 Warp 会再次按行瓜分 \(Q_i\) 块。例如,若 \(B_r = 64\) 且 Block 内有 4 个 Warp,则每个 Warp 独立负责其中 16 行 Query 的最终 \(O_i\) 计算。
- 片上私有化(无锁更新):由于每个 Warp 负责不同的 \(O\) 行,不同 Warp 之间在更新 \(m, d', O\) 状态时完全不需要加锁或跨 Warp 同步,所有局部中间结果均保存在 Warp 专属的寄存器中。
- Tensor Core 指令协同:Warp 内部的 32 个 Thread
协作调用硬件 Tensor Core 指令(如
mma.sync/wgmma)高效完成矩阵乘法,并通过 Warp 内的 Shuffle 指令(__shfl_xor_sync)快速求出 16 行内的局部最大值 \(m\) 与分母 \(d'\)。