GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers
- arXiv 提交日期:31 Oct 2022(发表于 ICLR 2023)
- 代码:gptq GitHub repo
- 作者:
摘要
生成式预训练 Transformer 模型(如 GPT 或 OPT)凭借在复杂语言建模任务中的突破性表现脱颖而出,但也伴随着极高的计算与存储成本。具体而言,由于其庞大的参数规模,即便是为大型、高精度的 GPT 模型执行推理,也可能需要多张高性能 GPU,这限制了此类模型的实用性。尽管目前已有研究尝试通过模型压缩来缓解这一压力,但现有的压缩技术在面对 GPT 模型的巨大规模和复杂性时,适用性与性能表现均受到限制。
在本文中,我们针对这一挑战,提出了一种基于近似二阶信息的全新单次(One-shot)权重量化方法——GPTQ,该方法兼具极高的精度与极高的效率。具体来说,GPTQ 仅需约 4 个 GPU 小时即可完成拥有 1750 亿参数的 GPT 模型的量化,将每个权重的比特位宽降至 3 或 4 bit,且相较于未压缩的基线模型,精度下降几乎可以忽略不计。相比此前提出的单次量化方法,我们的方法在保持精度的同时将压缩收益提高了一倍以上,使我们能够首次在单张 GPU 内运行 1750 亿参数模型进行生成式推理。
此外,我们还证明了该方法在极端量化场景下(即权重被量化至 2-bit 甚至三进制/Ternary 水平)仍能保持可观的精度。实验表明,相较于 FP16 精度,这些改进可转化为端到端的推理加速:在高端 GPU(如 NVIDIA A100)上可实现约 3.25 倍的加速,而在性价比更高的 GPU(如 NVIDIA A6000)上可实现约 4.5 倍的加速。
代码实现已开源:https://github.com/IST-DASLab/gptq。
1. Introduction
- 问题与背景:
- GPT 模型在 NLP 任务上性能很好,但是由于模型参数量巨大带来的计算和存储成本,导致模型的训练和推理成本高昂,即使是推理对于 GPT-3 175B 规模的模型,也需要多 GPU。
- 已有方法存在的不足:
- 部分方法需要模型重新训练(require model retraining),对 Billion 级参数量模型成本高昂。
- 部分方法训练代价低(post-training),但是难以扩展到 Billion 参数级模型。
- 最基础的量化方法(round-to-nearest quantization)无法应用到低于 8 bits 的量化精度。
- 本文提出的 Solution:
- 提出了一种后训练量化方法 GPTQ,可在几小时内完成几百 Billion 参数模型的量化,同时在量化到 3~4 bits 仍能够不明显降低模型正确率。
- 拥有量化到极端情况的能力:2 bits 甚至三元值(ternary values)。
- 开发了定制的动态解量化 CUDA Kernel,大幅减少了显存搬运,在 A100 上实现了 3.25 倍的端到端加速,在性价比更高的 A6000 上实现了 4.5 倍的加速。
2. Background
2.1 Layer-Wise Quantization
逐层量化形式化表示:
\[ \arg\min_{\hat{W}_l} \| W_l X_l - \hat{W}_l X_l \|_2^2 \quad \quad (1) \]
其中:
- \(W_l\) 为线性层 \(l\) 对应的权重矩阵
- \(X_l\) 表示包含 \(m\) 个样本数据穿过网络时产生的该层输入特征矩阵
- \(\hat{W}_l\) 为优化目标:量化权重矩阵
2.2 Optimal Brain Quantization
GPTQ 基于 Optimal Brain Quantization (OBQ) 方法,用于求解上述逐层量化问题。
OPQ Motivation:
- 公式 (1) 可以重写为针对权重矩阵 \(W\) 的每一行误差平方和。因此,OBQ 独立处理每一行 \(w\),每次量化一个权重,同时始终更新所有尚未量化的权重,以补偿因量化单个权重而引入的误差。
- 由于对应的目标函数是一个二次函数,其 Hessian 矩阵为 \(H_F = 2 X_F X_F^T\)(其中 \(F\) 表示剩余全精度权重的集合),下一个被贪心选择进行量化的最优权重(记为 \(w_q\))以及对应的所有 \(F\) 中未量化权重的最优补偿更新量(记为 \(\delta_F\)),由以下公式给出(其中 \(\text{quant}(w)\) 表示将 \(w\) 四舍五入映射到量化网格上最近的网格点):
\[ w_q = \arg\min_{w_q} \frac{(\text{quant}(w_q) - w_q)^2}{[H_F^{-1}]_{qq}}, \quad \delta_F = - \frac{w_q - \text{quant}(w_q)}{[H_F^{-1}]_{qq}} \cdot (H_F^{-1})_{:, q} \quad \quad (2) \]
- OBQ 使用这两个公式迭代地量化权重,直到 \(w\) 中的所有权重都被量化完成。
- 为了避免每次都重新对 \(H\) 求逆的高昂代价,OBQ 通过在逆矩阵上直接执行一步高斯消元(Gaussian Elimination),在量化 \(w_q\) 后扣除 \(H\) 的第 \(q\) 行和第 \(q\) 列。更新后的逆矩阵可由下式给出:
\[ H_{-q}^{-1} = H^{-1} - \frac{1}{[H^{-1}]_{qq}} H^{-1}_{:, q} H^{-1}_{q, :} \quad \quad (3) \]
- 该方法配备了向量化实现,可以并行处理权重矩阵 \(W\) 的多行。
OPQ 问题:
- 对于一个形状为 \(d_{\text{row}} \times d_{\text{col}}\) 的矩阵 \(W\),OBQ 的运行时间具有立方级输入依赖关系 \(O(d_{\text{row}} \cdot d_{\text{col}}^3)\),这意味着将其直接应用到数十亿甚至数百亿参数级别的模型上是极其昂贵的。
3. The GPTQ Algorithm
3.1 Step 1: Arbitrary Order Insight
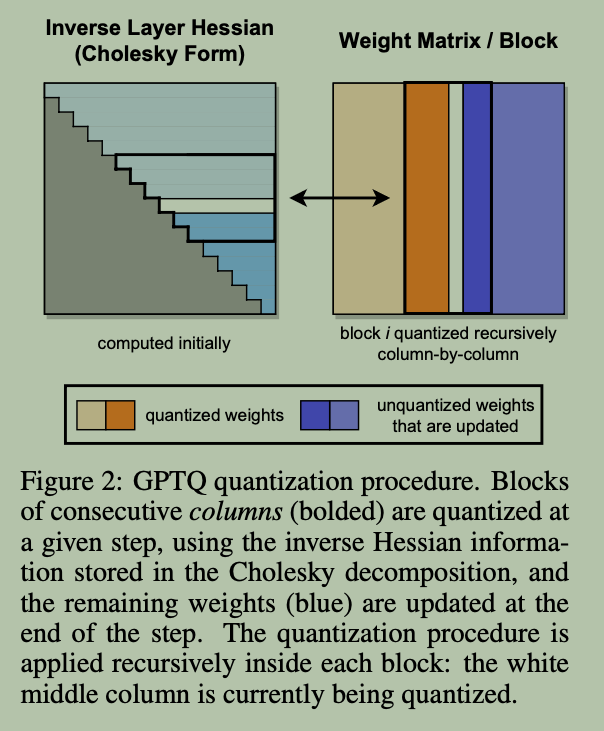
问题
传统的 OBQ(Optimal Brain Quantization)算法对权重矩阵的每一行进行独立处理,并采用贪心策略挑选当前重构误差最小的权重进行量化。由于每一行被量化的列顺序完全不同,导致逆 Hessian 矩阵 \(H^{-1}\) 无法跨行复用,必须针对每一个权重元素独立进行高斯消元更新。这使得对于 \(d_{\text{row}} \times d_{\text{col}}\) 的权重矩阵,计算复杂度高达 \(O(d_{\text{row}} \cdot d_{\text{col}}^3)\),在千亿级大语言模型上计算耗时呈立方级爆发,完全无法扩展部署。
Solution
- 任意固定顺序洞察:作者发现,在大参数量层中,按照任意固定的列顺序(如简单的逐列顺序)量化权重,其最终重构误差与复杂的贪心搜索几乎没有差异。前期固定顺序量化产生的少量较大误差,会被后续大量未量化的权重在更新中平摊补偿。
- 跨行共享逆 Hessian 更新:让权重矩阵的所有行采用完全相同的列顺序(逐列)进行量化。由于逆 Hessian 矩阵 \(H^{-1}\) 仅取决于该层的输入特征 \(X\),与具体的权重数值无关,因此 \(H^{-1}\) 对所有行都是完全一致的。
- 复杂度剧降:\(H^{-1}\) 的更新计算从按元素更新 \(d_{\text{row}} \cdot d_{\text{col}}\) 次剧减为按列更新 \(d_{\text{col}}\) 次。算法总复杂度从 \(O(d_{\text{row}} \cdot d_{\text{col}}^3)\) 直接降低至 \(O(\max(d_{\text{row}} \cdot d_{\text{col}}^2, d_{\text{col}}^3))\),运行速度提升了 \(\min(d_{\text{row}}, d_{\text{col}})\) 倍(数个数量级)。
3.2 Step 2: Lazy Batch-Updates
问题
虽然 Step 1 降低了理论复杂度,但如果直接在 GPU 上按列循环更新权重,实际运行速度依然非常缓慢。这是因为逐列更新时,每次仅对巨大矩阵的元素执行极少数 FLOPs 计算,计算访存比(Compute-to-memory-access ratio)极低,导致计算性能完全受限于 GPU 的显存读取带宽。
Solution
- 延迟批处理机制(Lazy Batching):观察到第 \(i\) 列的量化四舍五入决策仅受作用于该列的累积更新影响,对后续列的更新在当前时刻无需立刻写入全局矩阵。
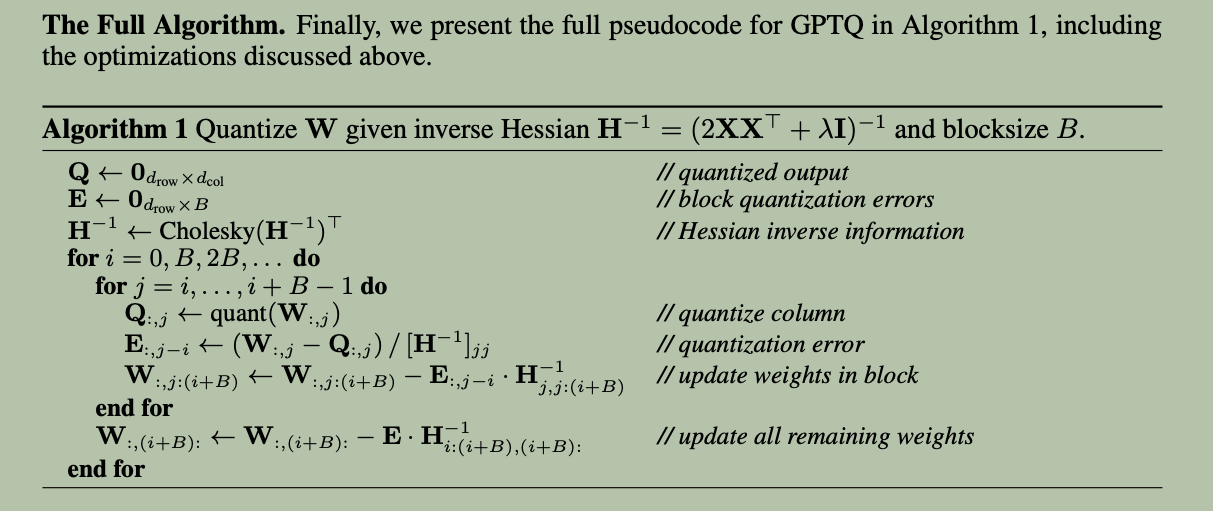
- Block 级局部与全局更新分离:将权重矩阵按列分为若干块(Block,如块大小 \(B=128\))。在当前 Block 内部,逐列量化并仅更新 Block 内部右侧的未量化列;待整个 Block 处理完毕后,积累该 Block 产生的量化误差矩阵 \(E\),利用多权重版本的公式通过 GPU 原生高效的大矩阵乘法(GEMM)一次性对 Block 右侧所有剩余权重进行全局批量更新。
- 消除吞吐瓶颈:在理论计算量不变的前提下,将散乱低效的访存转化为连续吞吐的 GEMM 操作,为超大模型量化带来了一个数量级的实际运行加速。
3.3 Step 3: Cholesky Reformulation
问题
在大模型规模下,随着 Block 更新与逆矩阵更新公式的反复迭代应用,浮点数累积误差会导致逆 Hessian 矩阵 \(H^{-1}\) 失去正定性(Become Indefinite)。矩阵一旦非正定,算法就会向错误方向激进更新剩余权重,导致整层量化精度严重崩溃(在大模型上极易发生)。
Solution
- 对角线阻尼(Damping):在 Hessian 矩阵对角线元素上加入小常数阻尼 \(\lambda I\)(通常取对角线均值的 1%),确保矩阵强正定,防止数值不稳定。
- Cholesky 预计算:观察到量化权重时仅需要 \(H^{-1}\) 从对角线开始的行信息,而对称逆 Hessian 矩阵的逐行扣除在数学上完全等价于 Cholesky 分解。因此利用高性能 GPU Cholesky Kernel,在循环开始前预先一次性计算出逆 Hessian 的 Cholesky 分解矩阵 \(G = \text{Cholesky}((2XX^T + \lambda I)^{-1})^T\)。
- 彻底解决数值稳定性:消除了循环中反复做矩阵求逆带来的累积数值误差,极大地增强了算法在大模型上的鲁棒性,同时借助高度优化的 Cholesky 算子获得了额外加速。
3.4 The Full Algorithm
4. Conclusion
- GPTQ
- 基于 OBQ 并做以下改进:
- Arbitrary Order Insight
- Lazy Batch-Updates
- Cholesky Reformulation
- 基于 OBQ 并做以下改进: