LLM Systems 24: Efficient LLM Inference with PagedAttention and vLLM
1. Paged Attention: Efficient memory management for KV cache
略,PagedAttention paper 覆盖 slides 这一部分主要内容。
2. vLLM: A real-world open-source inference engine
2.1 Overview
2.1.1 What is vLLM?
- vLLM is a popular open-source LLM inference engine to make inference efficient and effortless
- vLLM is collaboratively developed by many organizations
2.1.2 API
离线批量推理 API
1 | |
在线 Serving API
- A FastAPI-based server for online serving
- Server
1 | |
- Client
1 | |
2.1.3 vLLM Overview
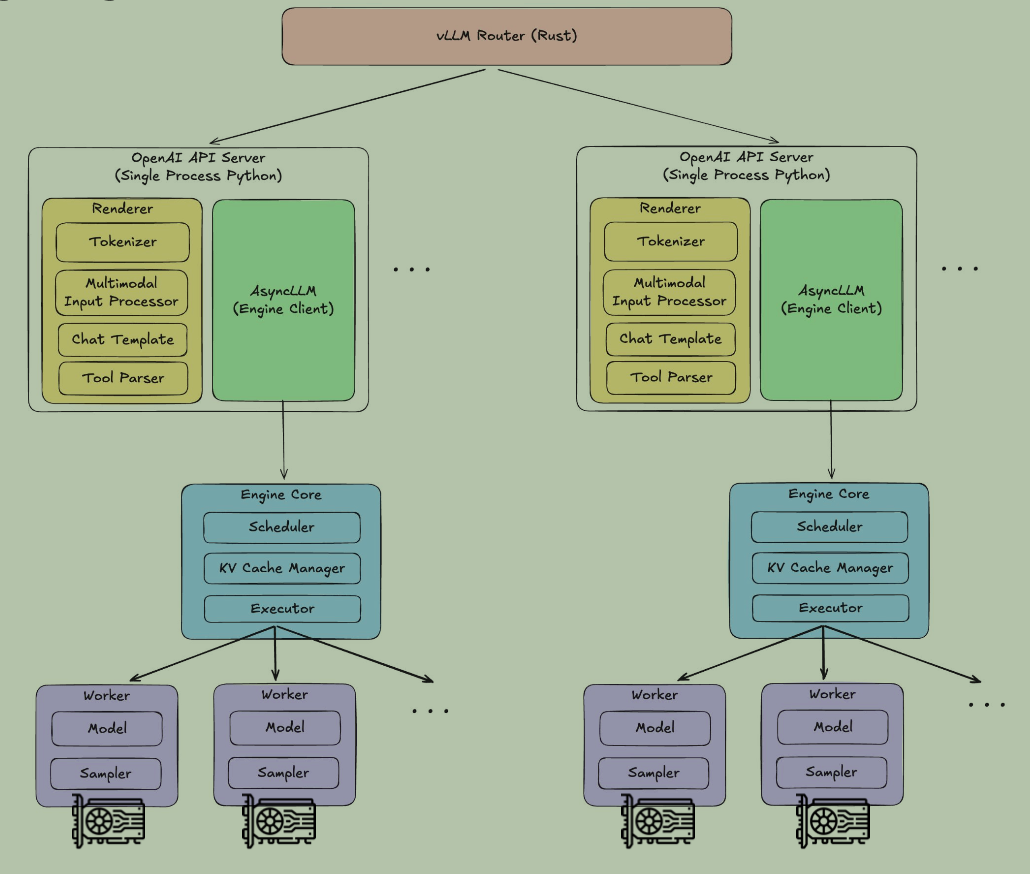
- vLLM Router (Rust)
- 定位:系统最顶层的分布式路由入口,采用 Rust 编写。
- 职责:负责高性能 HTTP/gRPC 请求的高并发接收、负载均衡与多 API Server 间的请求分发,避免 Python 进程在大并发连接下的 CPU 性能瓶颈。
- OpenAI API Server (Single Process Python):兼容
OpenAI 标准 API 的单进程 Python 服务端,主要拆分为两大模块:
- 前置处理与解析组件:
Tokenizer:文本 Token 分词与序列转换。Multimodal Input Processor:多模态输入(如图像、音频)的特征抽取与预处理。Chat Template&Tool Parser:应用对话模板并解析 Function Calling / Tool 调用。Renderer:控制文本渲染与格式化输出。
- AsyncLLM (Engine Client):作为 API Server 与后端 Engine 通信的异步客户端,负责将接收到的请求异步推送给 Engine Core 并流式接收结果。
- 前置处理与解析组件:
- Engine Core
(引擎核心):负责整个推理引擎的控制流与资源管理,包含三大核心组件:
- Scheduler(调度器):决定当前 Step 将哪些请求放入 Batch 进行计算,控制请求的加入、排队与抢占策略。
- KV Cache Manager(KV 缓存管理器):基于 PagedAttention 机制管理物理 KV Block 显存的动态分配、释放与逻辑 Block Table 映射。
- Executor(执行器):负责将调度好的计算任务下发并同步至底层的多 GPU Worker 节点执行。
- Worker (工作节点):运行在实际 GPU/ accelerators
上的底层计算进程(支持多卡分布式扩展),每个 Worker 包含:
- Model:加载模型权重,执行模型的前向传播(Forward Pass),结合了 Triton 自定义算子、CUDA Graph 及量化/融合内核。
- Sampler:对模型输出的 Logits 进行采样(如 Greedy、Temperature、Top-p/Top-k 采样),生成最终的 Token。
2.2 How does vLLM optimize LLM inference?
2.2.1 Minimizing CPU overheads
问题与重要性
- 推理单步极快:在 LLM autoregressive 推理的 Decode 阶段,单步模型执行仅需 5–10 ms(相当于每秒生成 100–200 Token)。相比之下,模型训练阶段单步长达 100 ms 至 1 秒以上。
- 敏感度极高:在单步仅 5–10 ms 的场景下,哪怕 1 ms 的 CPU 额外开销也会导致系统总体性能下降 20%。而在 Python 中,很容易产生 1 ms 以上的延迟。
Minimizing CPU Overheads:三个层次进行优化
- API Server 层:将原先 Python 编写的路由层重写为
Rust 语言实现的
vLLM Router。 - Engine Core(调度与内存管理层):实现异步调度(Async Scheduling) 与 异步反词元化(Async De-tokenization)。
- Worker(计算层):采用 GPU 原生输入准备(GPU-Native Input Prep) 和 分段 CUDA 图(Piecewise CUDA Graphs)。
2.2.1.1 Asynchronous Scheduling
同步与异步调度示意图:
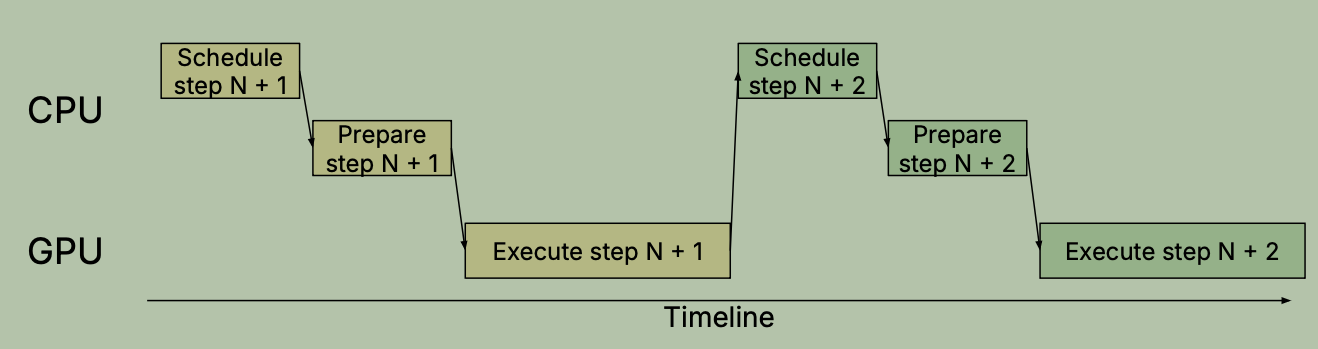
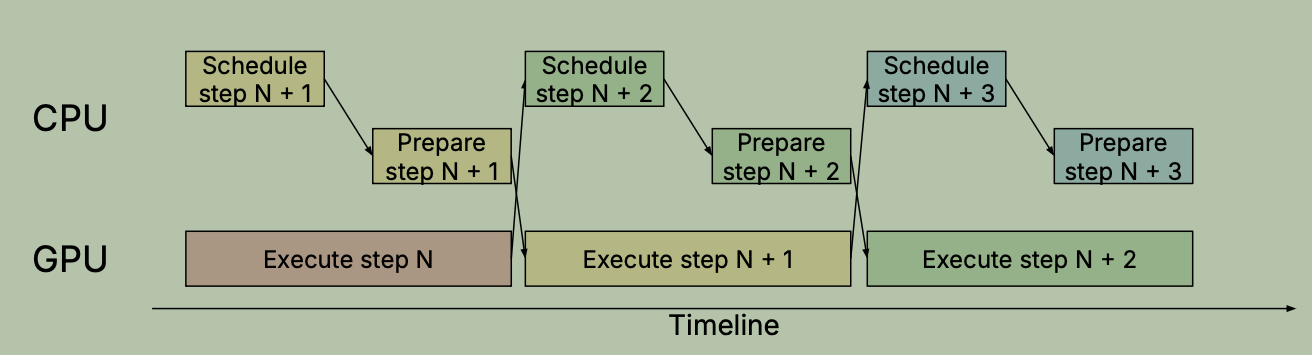
- 异步调度的核心思想:“提前一步调度与准备下一批次(Schedule & prepare one step ahead)”。
- 重叠执行:当 GPU 正在执行第 N 步模型前向计算时,CPU 在后台并行完成第 N+1 步的批次调度与数据准备。这一机制确保了 零同步阻塞(Zero Synchronization),GPU 永远不会停下来等待 CPU。
Reference
- NanoFlow: Towards Optimal Large Language Model Serving Throughput
2.2.1.2 GPU-Native Input Preparation
- 离散算子替换:过去处理 PagedAttention 状态、Batch 维护和采样参数等复杂的 Bookkeeping 逻辑时,依赖大量运行在 CPU 上的 PyTorch 小算子,既慢又繁琐。
- Triton 内核重构:vLLM 将这部分输入准备逻辑重构为自定义的 Triton Kernels,直接在 GPU 端完成准备计算。
- 兼容投机解码(Speculative Decoding):输入准备内核运行在 GPU 上,可以直接读取上一步拒绝采样(Rejection Sampling)的结果,使得异步调度与投机解码无缝兼容。
2.2.1.3 CUDA Graph for Minimizing CPU Overheads
示意图:
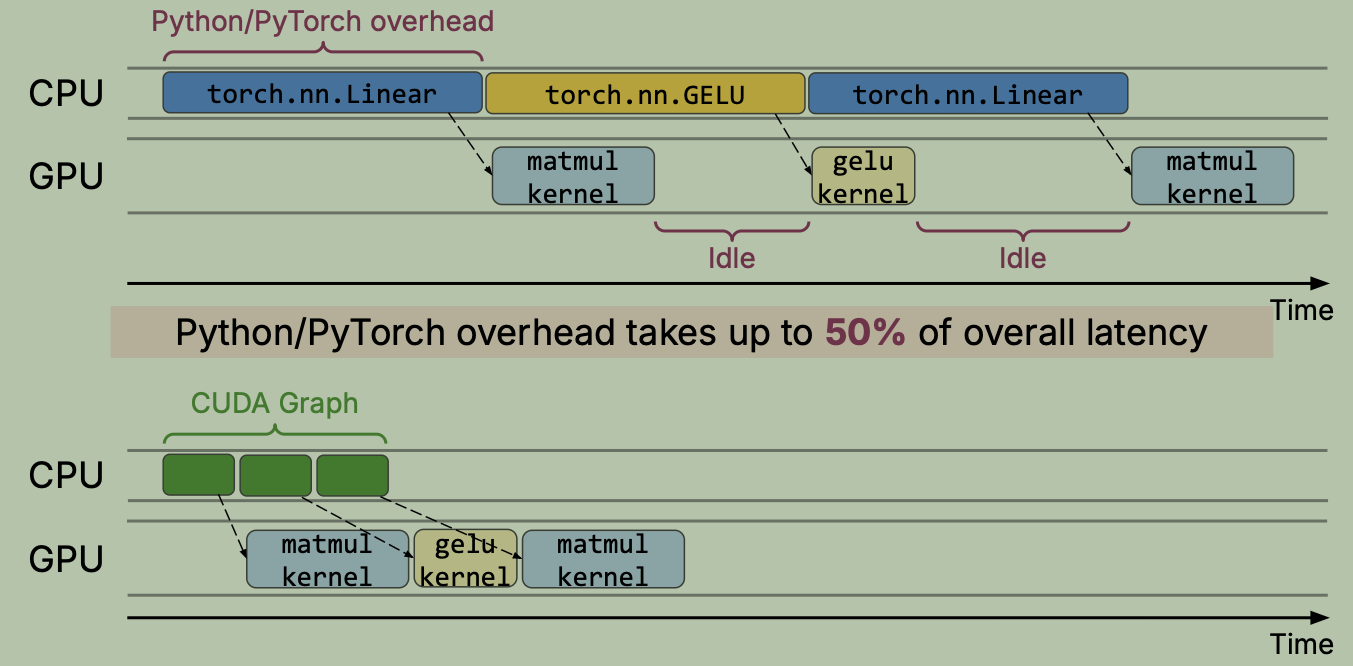
Full CUDA Graph
- 整个模型 forward 流程 capture 到一个 CUDA Graph 内。
- 优点:最小化 CPU 执行开销。
- 缺点:灵活性有限,导致它无法灵活处理动态 Prefill/Decode
混合批次、运行时启发式内核(如 Cascade Attention)以及 CPU Offloading
等动态需求。
- 需要静态 shape
- 不允许 CPU 操作
Piecewise CUDA Graphs
示意图:
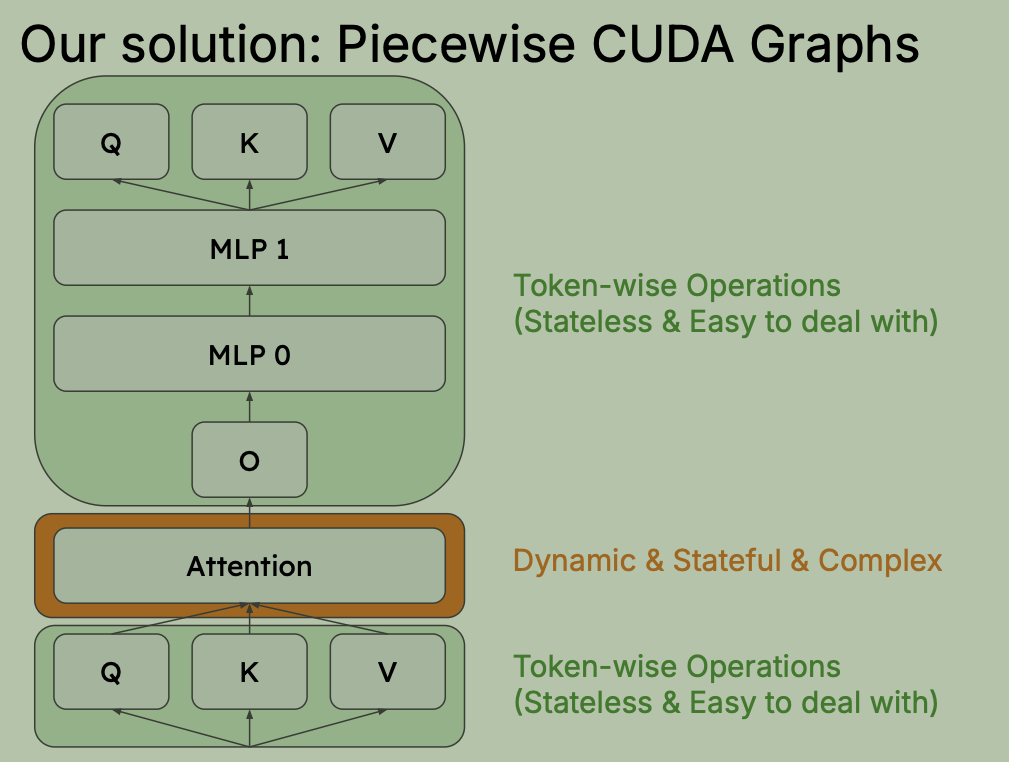
- 将模型切片:
- Token-wise 操作(如 Linear、MLP、LayerNorm 等无状态静态层):捕获并封装在 CUDA Graph 中,享受零 CPU 开销。
- Attention 操作(有状态、Shape 动态变化):保持在 PyTorch Eager 模式下运行,保留极高灵活性。
- 优点:
- 无 shape 限制。
- 允许 CPU 操作。
- 缺点:
- Attention 运算需要 CPU 参与可能成为性能瓶颈。
2.2.2 Efficient GPU kernels
- 对于复杂的/性能关键的算子,采用 FlashInfer 或其他库。
- 模块化抽象接口:设计了 AttentionBackend 和 FusedMoE 两个核心抽象层。通过抽象接口,vLLM 可以灵活地集成 FlashInfer、DeepGeMM 等高效的第三方 Kernels,在不同的硬件环境和模型结构下自动选用最优内核实现
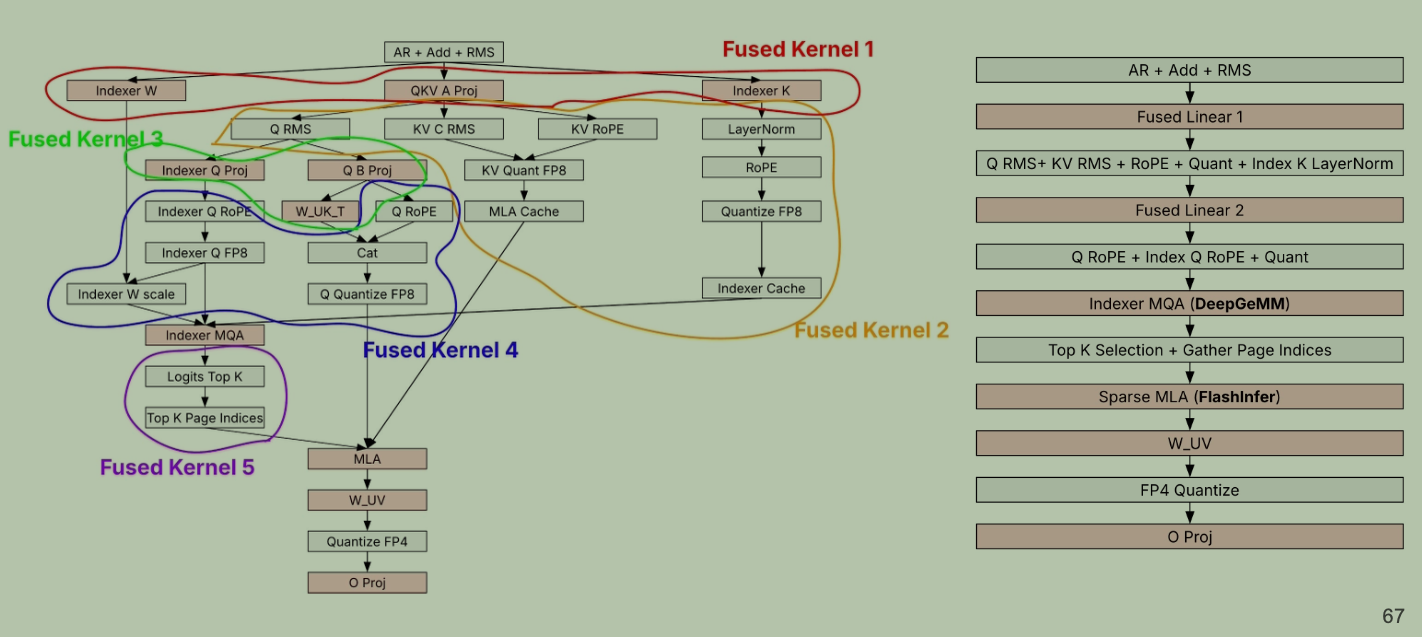
- 对于内存带宽受限算子(如:RMS norm, RoPE),采用以下方法:
- 自动融合生成:利用
torch.compile自动分析计算图,自动融合相邻的算子并生成优化后的 Triton/CUDA 内核。 - 手动融合实现:针对极其关键或通用的计算模式,手动编写高度优化的 Fused Kernels。
- 自动融合生成:利用
DeepSeek V3.2 算子融合情况示例
2.2.3 Model parallelisms
必要性
- 模型规模越来越大,单卡无法推理。
- 利用多 GPU 扩展计算 FLOPS 和显存带宽,从而降低推理延迟(Latency)并提升系统吞吐量(Throughput)。
目标与需要考虑的问题
- 最小化通信开销:
- 减少节点间数据传输。
- 通过计算与通信重叠(Overlap)掩盖延迟。
- 适配异构网络(如 NVLink 1.8 TB/s 与 InfiniBand 50 GB/s 的巨大带宽差异)。
- 最小化负载不均(Load Imbalance):
- 防止系统整体性能被最慢的计算节点所拖累。
2.2.3.1 Data parallelism
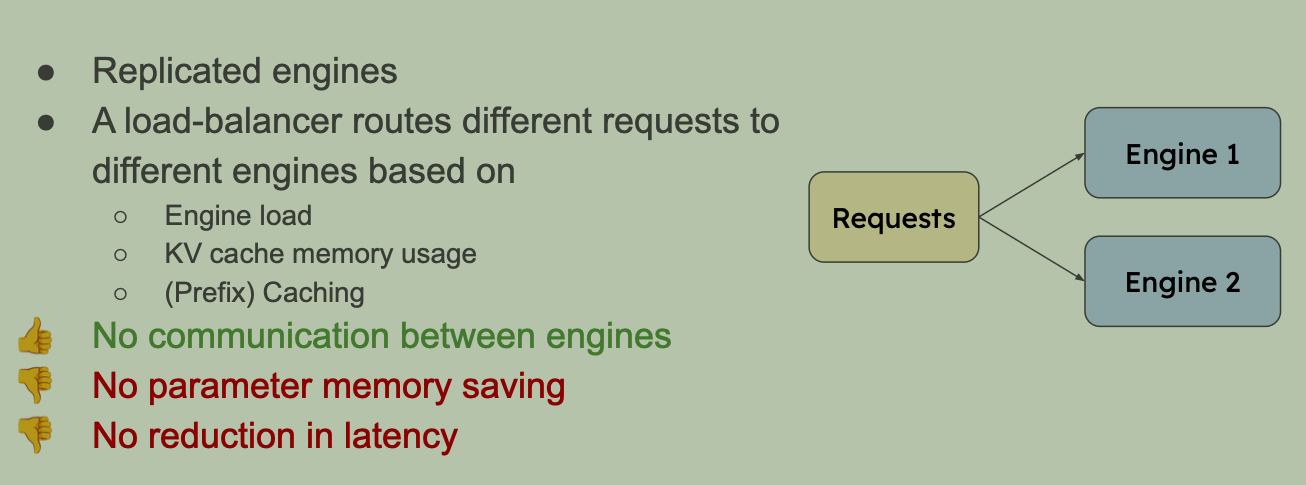
- 在不同 GPU 上完全复制推理引擎。
- 负载均衡器基于以下指标分发请求:
- Engine 负载;
- KV Cache 内存使用情况;
- 前缀匹配(KV Cache 复用)情况;
- 优点:
- engine 间无通信。
- 缺点:
- 不能减少参数内存占用。
- 无法降低单请求延迟。
2.2.3.2 Tensor parallelism
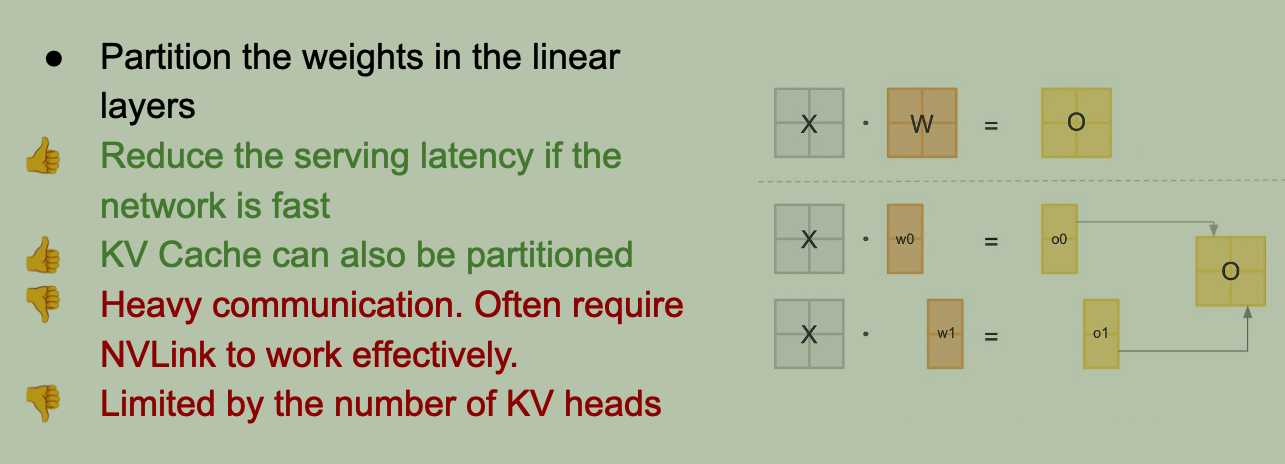
- 切分 Linear 层权重。
- 优点:
- 降低单请求推理延迟(如果网络足够快)。
- KV Cache 也随之切分。
- 缺点:
- 通信开销极大(通常强依赖 NVLink 才能高效运行)。
- 扩展性受限于 KV Head 的数量。
2.2.3.3 Expert parallelism
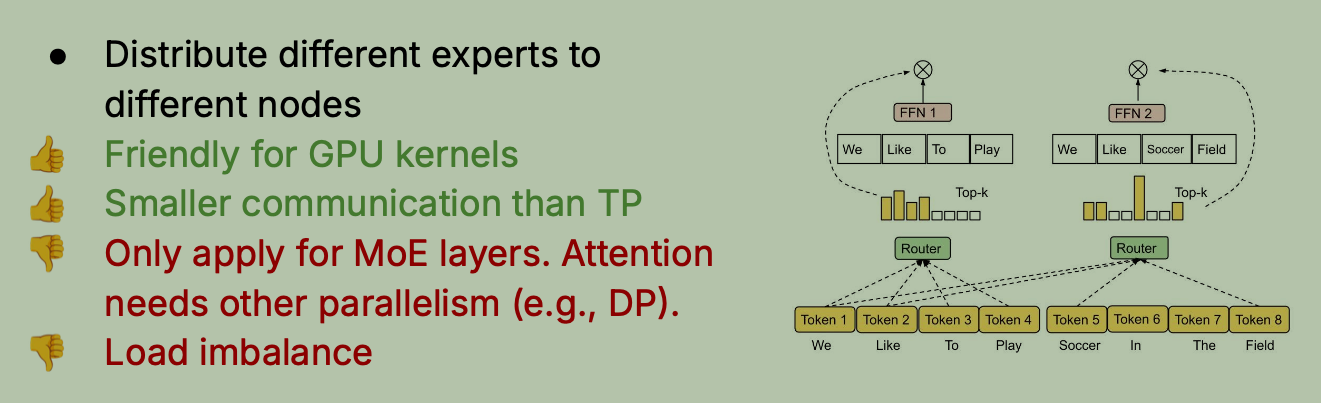
- 将 MoE 模型 experts 分布在不同 device。
- 优点:
- 对 GPU 内核友好。
- 通信量显著低于 TP。
- 缺点:
- 仅适用于 MoE 层(Attention 层仍需搭配 DP 等其他并行方式)。
- 容易产生 Expert 之间的路由负载不均。
2.2.3.4 Context parallelism
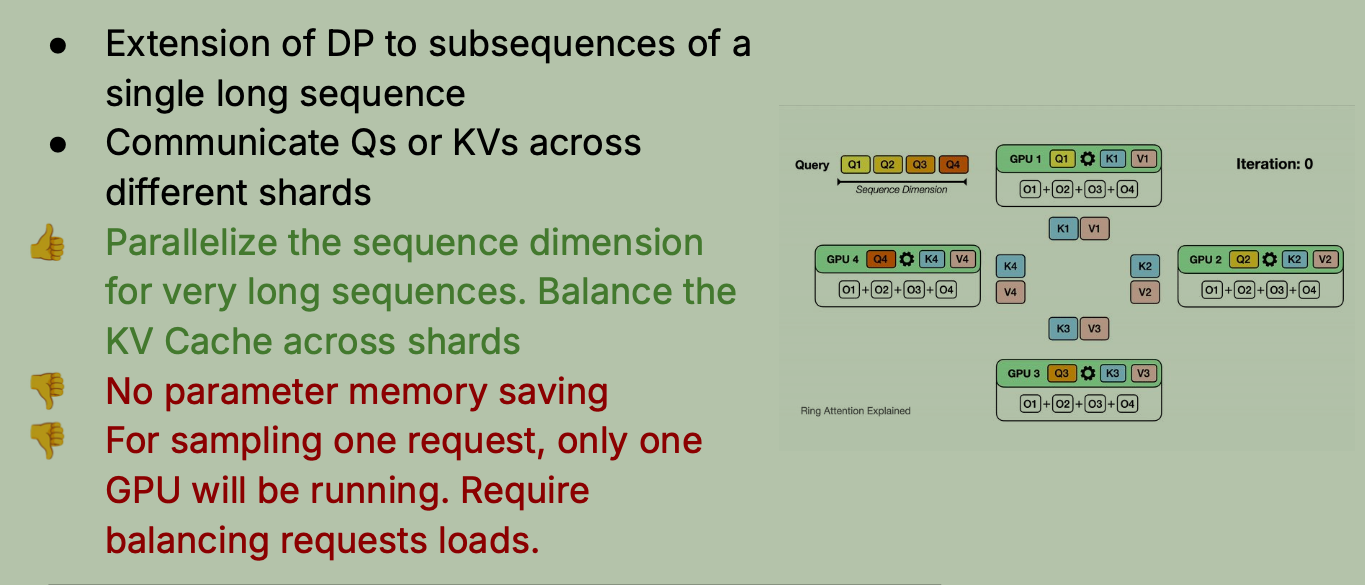
- 将单条超长序列在序列维度上切分,并在切分块之间循环传输 Q 或 KV。
- 优点:
- 专为超长文本设计,平衡各 GPU 间的 KV Cache 内存占用。
- 缺点:
- 无法节省模型参数显存。
- 在采样单条请求时同一时间仅有一张 GPU 在计算,需要请求间负载均衡。
2.2.3.5 Pipeline parallelism
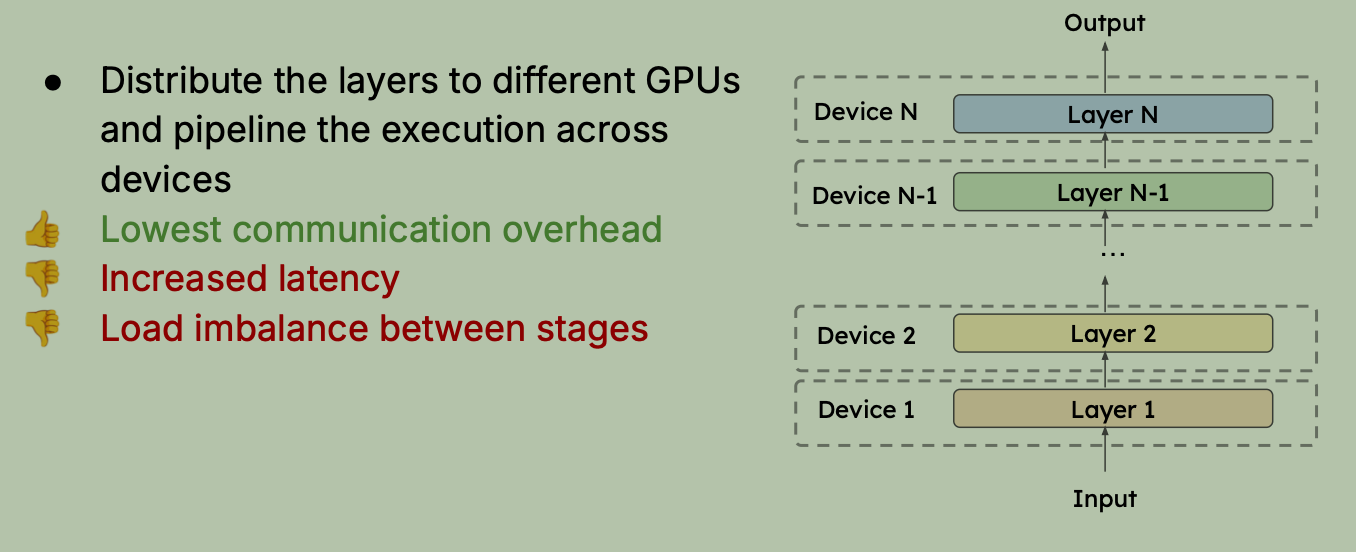
- 将模型不同层放在不同 device。
- 优点:
- 通信开销最小。
- 缺点:
- 会增加整体响应延迟。
- 各 Stage 之间容易产生负载不均。
2.2.3.6 Prefill Disaggregation (PD)
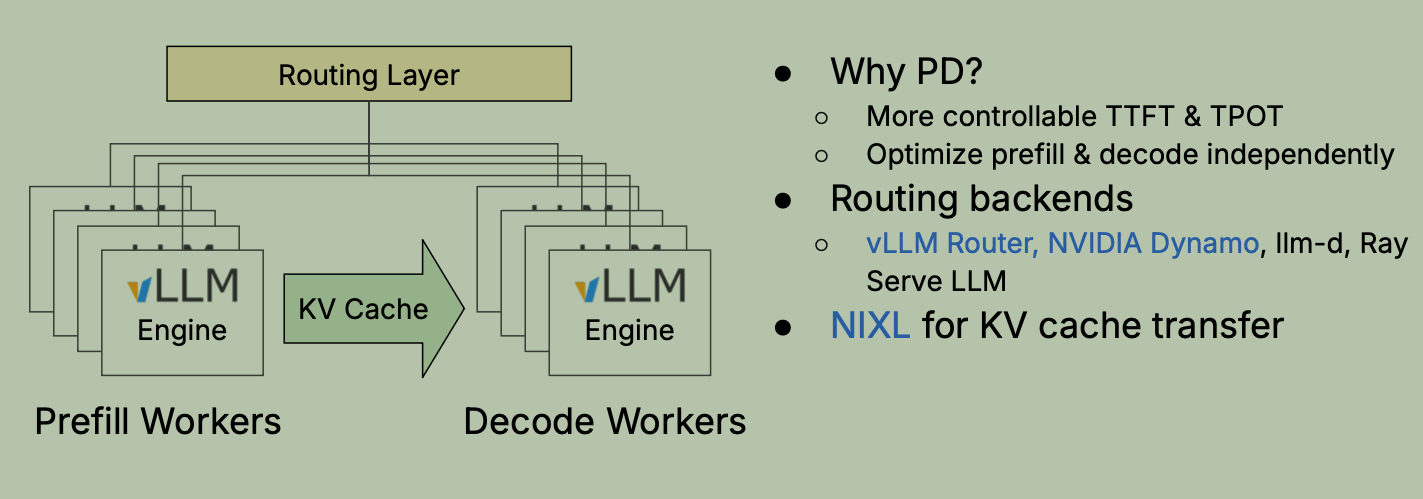
- 解耦部署:Prefill(首字计算/计算密集型)与 Decode(逐字生成/访存密集型)的运行特性差异巨大。通过将两者的 Worker 独立部署与优化,可以获得更可控的 TTFT(首字延迟)和 TPOT(输出 Token 间隔延迟)。
- 生态兼容:支持 vLLM Router、NVIDIA Dynamo、llm-d、Ray Serve LLM 等多种路由后端。
- 跨节点传输:使用 NIXL RDMA P2P 通信库实现 Prefill Worker 向 Decode Worker 的高性能跨节点 KV Cache 传输。
2.2.3.7 Mixed Parallelism
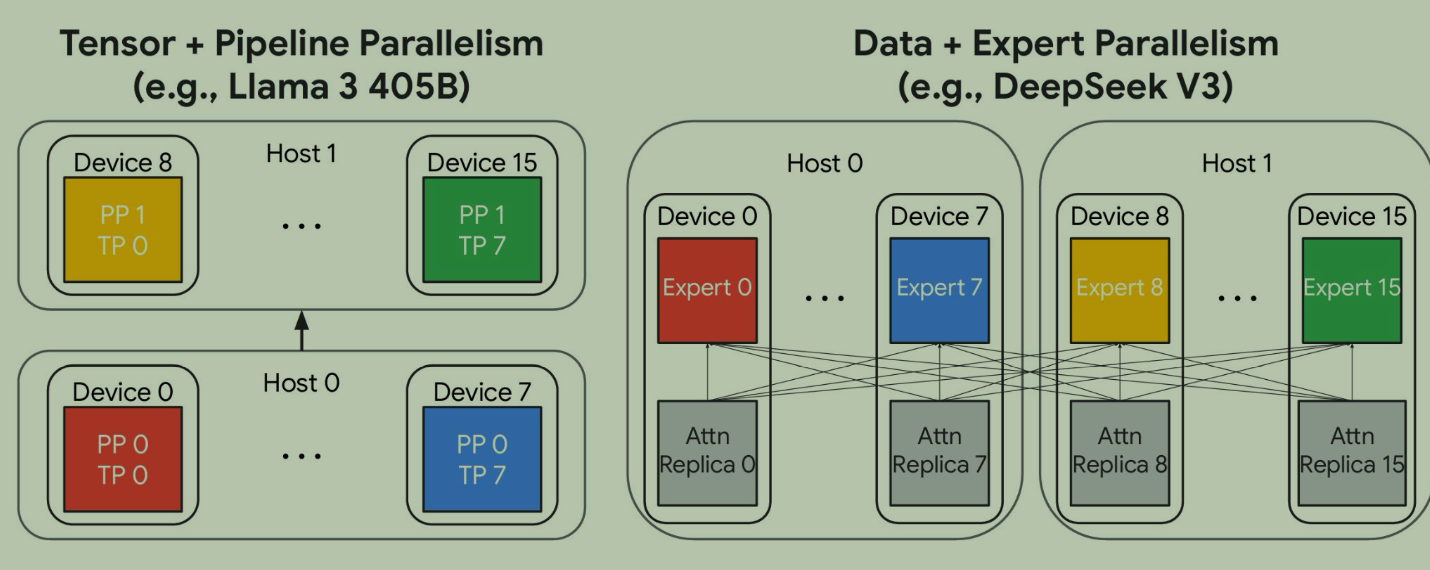
- 左图:TP=8 PP=2
- 右图:EP/DP = 16
2.2.4 Efficient memory management & caching
Hybrid Memory Allocator
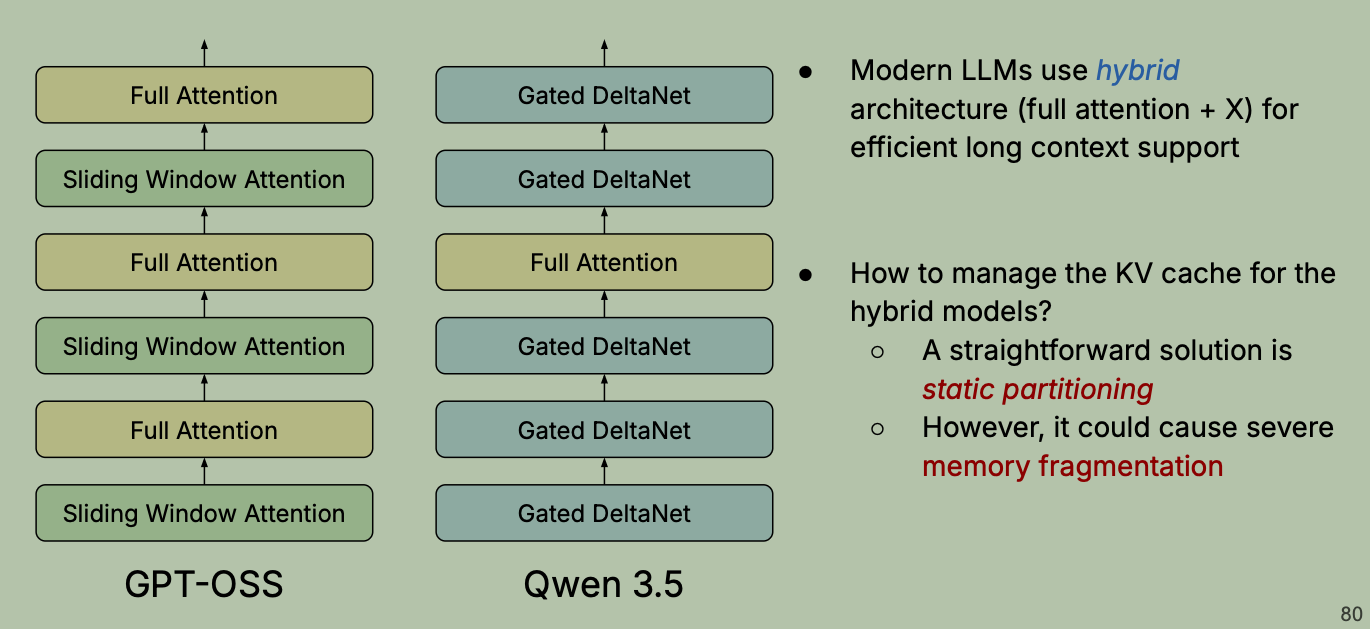
- 背景:为了高效支持超长上下文(Long Context),许多现代开源 LLM
放弃了单一的 Full Attention 架构,转而引入混合架构(Hybrid
Architecture):
- GPT-OSS:采用 Full Attention + 滑动窗口注意力(Sliding Window Attention)。
- Qwen 3.5:采用 Full Attention + Gated DeltaNet。
- 管理这类混合架构模型 KV Cache 的方法:
- 静态切分(Static Partitioning):给 Full Attention
和其他机制分别预留固定的显存空间。
- 导致内存碎片。
- vLLM 解决方法:Hybrid Memory Allocator
- 静态切分(Static Partitioning):给 Full Attention
和其他机制分别预留固定的显存空间。
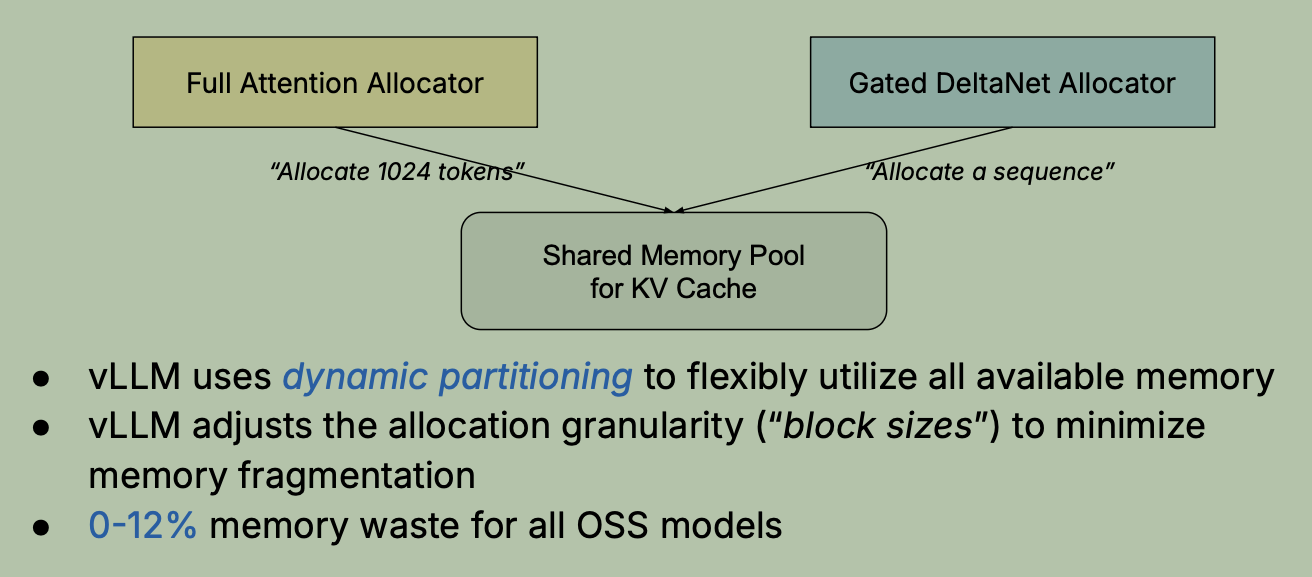
- 统一共享显存池(Shared Memory Pool):将所有 KV Cache 显存统一放入一个共享池中,由不同的分配器(如 Full Attention Allocator 与 Gated DeltaNet Allocator)共同申请。
- 动态切分机制(Dynamic Partitioning):弃用静态隔离,采用动态切分来灵活调度和利用所有可用显存。
- 自适应分配粒度(Block Sizes):根据不同层或算子的需求调整分配粒度(例如 Full Attention 按“分配 1024 Token”,而 Gated DeltaNet 按“分配一个 Sequence”)。
3. Conclusion
- PagedAttention: store the KV cache in fixed-size blocks, mapped by a
per-request block table (like OS paging)
- Waste only in each request's last block → larger batches → 2–4× higher throughput
- Ref counts + copy-on-write share KV blocks across samples (parallel sampling, beam search)
- Out of KV blocks → preempt a request, then swap it back in or recompute it
- vLLM
- vLLM provides a clean core that modularizes models and enables various features with zero CPU overhead.
- vLLM provides full-stack performance optimizations for state-of-the-art models from kernels to model parallelisms.
- vLLM engine
- hides CPU overhead (async scheduling, CUDA graphs)
- fast kernels
- model parallelism
LLM Systems 24: Efficient LLM Inference with PagedAttention and vLLM
https://arcsin2.cloud/posts/2026/11/4214254391/