PagedAttention: Efficient Memory Management for Large Language Model Serving with PagedAttention
- Efficient Memory Management for Large Language Model Serving with PagedAttention
- arXiv 提交日期:12 Sep 2023(发表于 SOSP 2023)
- 代码:vllm
- 作者:
摘要
大语言模型(LLM)的高吞吐量服务需要一次性对足够多的请求进行批处理(Batching)。 然而,由于每个请求的键值缓存(KV Cache)占用显存巨大且动态增减,现有系统在处理时面临巨大挑战。如果内存管理效率低下,显存会因碎片化和冗余复制而被严重浪费,进而限制了批次大小(Batch Size)。
为了解决这一问题,我们提出了 PagedAttention——一种受操作系统中经典虚拟内存与分页技术启发的注意力算法。在此基础之上,我们构建了 LLM 推理服务系统 vLLM,它实现了:1)KV Cache 显存近乎零浪费;2)请求内部及跨请求间灵活共享 KV Cache,以进一步降低显存占用。
实验评估表明,与 FasterTransformer 和 Orca 等现有最先进系统相比,vLLM 在保持相同延迟水平的情况下,将主流 LLM 的吞吐量提升了 2–4 倍。在更长序列、更大模型以及更复杂的解码算法场景下,这一性能提升尤为显著。
vLLM 的源代码已开源:https://github.com/vllm-project/vllm。
1. Introduction
- 背景:
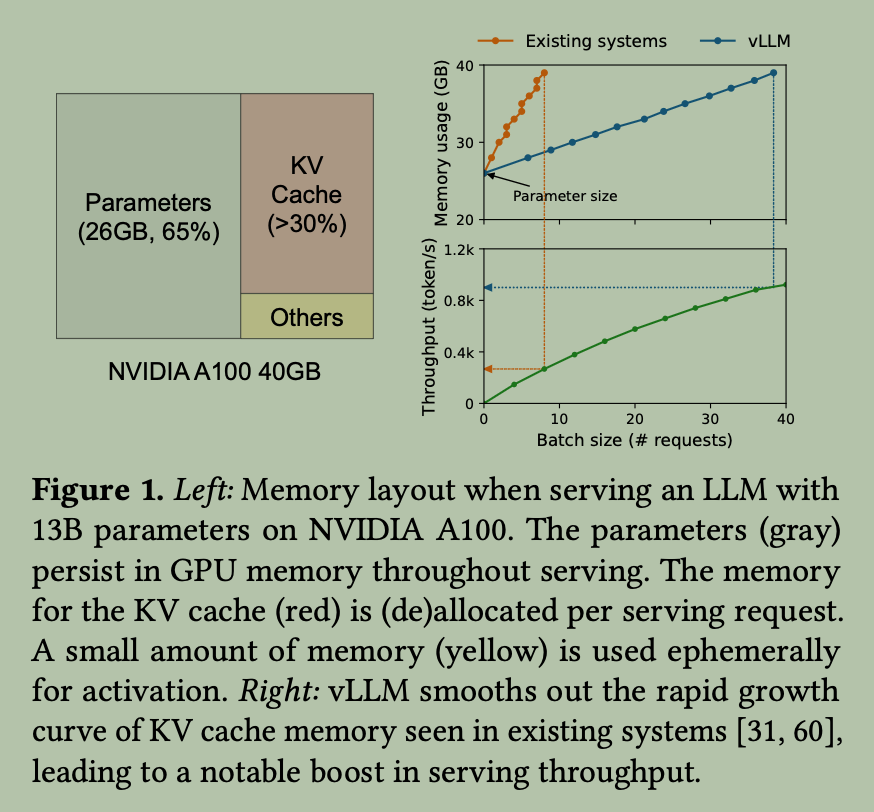
- LLM 推理吞吐/成本与 batch 紧密相关,提升 batch 能够提升吞吐并降低单个 request 推理成本,但是也在内存管理方面带来挑战。如上述图 1 所示,模型参数和激活值内存占用相对静态/固定,因此推理的主要挑战在于如何高效管理 KV Cache 内存。
- 已有系统存在问题:已有系统通常采用根据请求最大
token 长度,预先为每个 request分配 KV Cache 存储空间,这导致了:
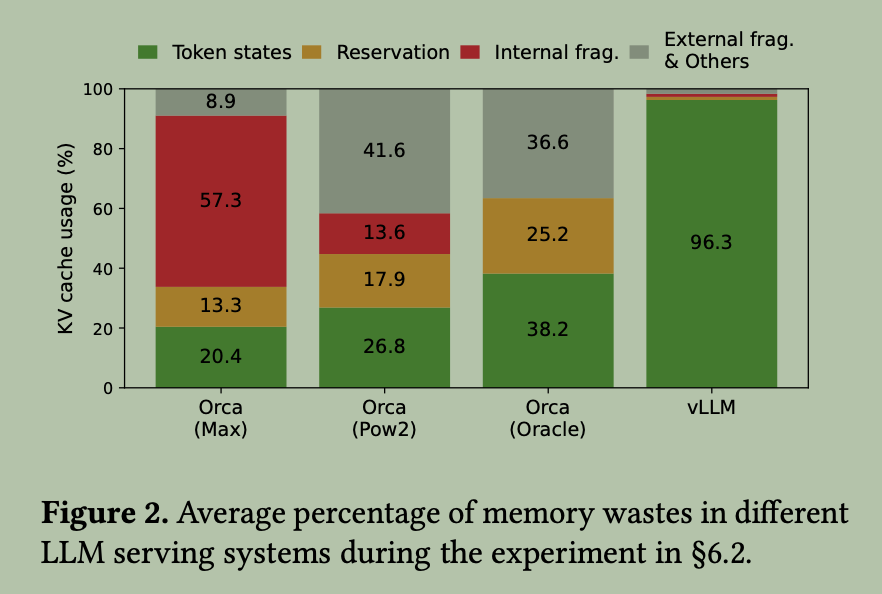
- 内部与外部内存碎片。如上面图 2 所示。
- 跨请求或者进行采样时,无法共享 KV Cache。
- 本文提出的方法:PagedAttention
- 解耦逻辑与物理空间:将 KV Cache 划分为固定大小的 KV Blocks(显存页/块),允许逻辑上连续的 token 向量存储在物理上离散的显存空间中。
- 按需分配与近零浪费:通过页表(Block Table)进行映射,新生成 token 时按需动态申请物理 Block,将外部碎片彻底消除,并把内部碎片控制在单块内。
- Block 粒度的物理共享:在并行采样、Beam Search 或系统前缀(System Prompts)场景下,不同请求或分支可以直接映射到相同的物理 Block,仅在写入新 token 时触发写时复制(Copy-on-Write)。
- 效果:
- 基于 PagedAttention 算法构建了 vLLM 推理系统。
- 在保持相同延迟前提下,vLLM 将主流 LLM 的推理服务吞吐量提升了 2–4 倍。
2. Memory Challenges in LLM Serving
KV Cache 管理存在的挑战:
- KV Cache 体积巨大(Large KV Cache)
- 定量计算:以 13B 参数的 OPT 模型为例,存储单个 token 的 KV Cache 需要 800 KB 显存(计算逻辑为 2 个向量 × 5120 隐层维度 × 40 层 × 2 字节 FP16)。当序列长度达到模型上限 2048 时,单请求的 KV Cache 高达 1.6 GB。在 40GB 或 80GB 显存的 GPU 上,哪怕把所有剩余显存全部分配给 KV Cache,也仅能容纳几十个并发请求。
- 硬件瓶颈加剧:GPU 算力的增长速度远快于显存容量的增长(例如 NVIDIA A100 到 H100 算力提升超过 2 倍,但最大显存依然维持在 80GB)。这导致显存容量成为日益严峻的性能瓶颈。
- 复杂的解码算法与动态共享(Complex Decoding
Algorithms)
- 不同的采样策略对内存共享提出了截然不同的动态需求。在并行采样(Parallel Sampling)中,单 Prompt 生成多条分支,Prompt 阶段的 KV Cache(占实验中总 KV Cache 的 12%)可以被共享。
- 在 Beam Search(束搜索)中,不同 Candidate 之间可共享高达 55% 的 KV Cache。更复杂的是,这种共享拓扑随着解码推进在动态演化(类似于进程树的分叉与收缩),传统静态内存分配完全无法适应。
- 输入与输出长度未知带来的调度难题(Scheduling for Unknown
Input & Output Lengths)
- 用户请求的 Prompt 长度千差万别,且自回归生成阶段的输出长度在开始前完全无法预测。
- 随着输出逐 token 增长,动态膨胀的 KV Cache 极易撑爆 GPU 显存,迫使系统必须做出抢占调度策略(如换出 Swapping 或重算 Recomputation)。
2.1 Memory Management in Existing Systems
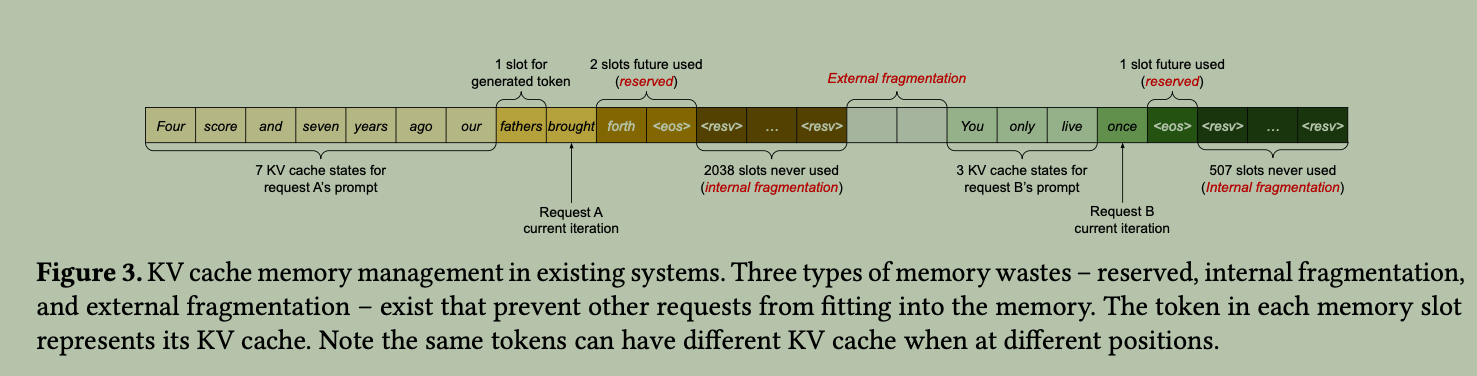
- 上图展示了现有系统按照 request 最大 token 长度进行 KV Cache
预分配导致了内存浪费:
- 预留浪费(Reserved Slots):为未来自回归生成预留的槽位。虽然这些槽位未来可能会被填入,但在整个请求生命周期内被长期锁定,无法借给其他短请求使用。
- 内部碎片(Internal
Fragmentation):当请求实际生成的序列长度远小于预分配的最大长度(例如遇到
<eos>提前结束)时,过量预留的后半段显存完全闲置。 - 外部碎片(External Fragmentation):内存分配器(如 Buddy Allocator)在分配不同尺寸请求时,由于分配粒度对齐产生的不可用物理空洞。
3. Method
vLLM 整体架构:
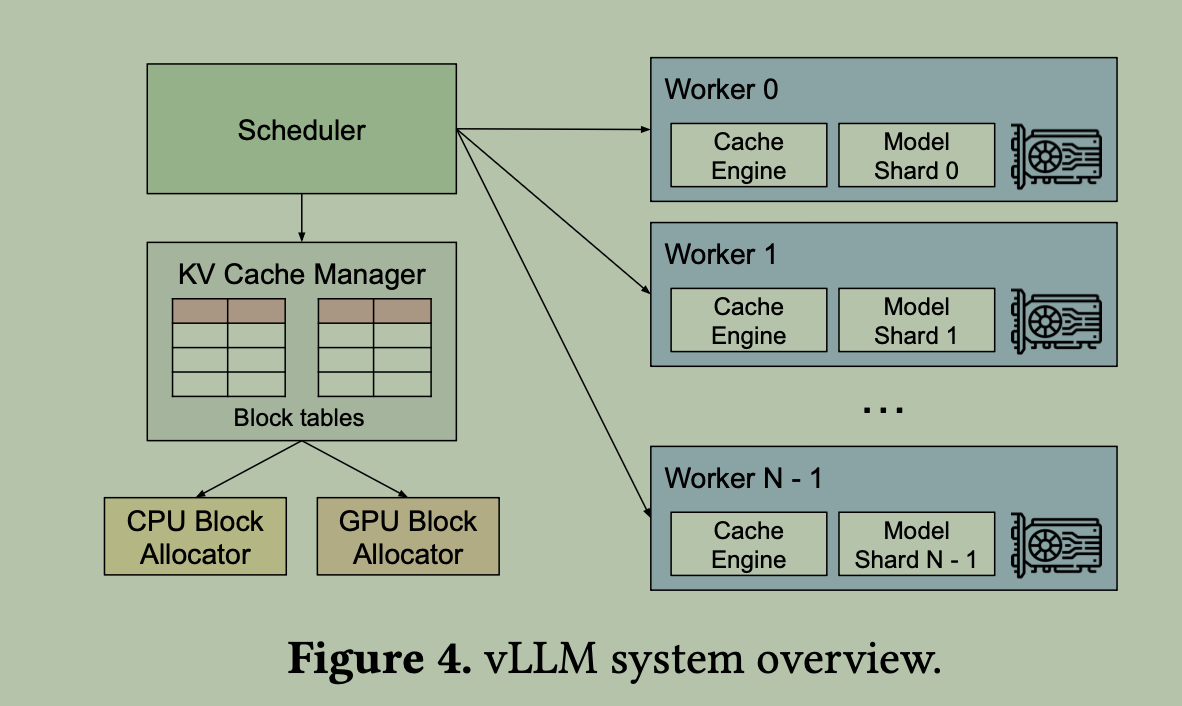
vLLM 系统采用 集中式调度器(Centralized Scheduler) 与 分布式 GPU Worker 配合的架构:
- 物理显存管理者:调度器中内置 KV Cache Manager,维护全局逻辑块到物理块的页表映射;GPU Worker 上运行 Block Engine,负责实际 GPU/CPU 显存池的物理分配。
- 操作系统概念映射:
- 请求(Request / Sequence) \(\rightarrow\) 进程(Process)
- Token 向量 \(\rightarrow\) 内存字节(Byte)
- 逻辑 KV 块(Logical KV Block) \(\rightarrow\) 虚拟页(Virtual Page)
- 物理 KV 块(Physical KV Block) \(\rightarrow\) 物理页框(Physical Frame)
- Block Table \(\rightarrow\) 页表(Page Table)
3.1 PagedAttention
- 核心思想:
- 在 sequence 维度对逻辑上连续的 KV Tensor 进行切分,固定 block 大小 \(B\) 个 token 的 KV Cache 存放在一个 block(page)内。如下图所示:
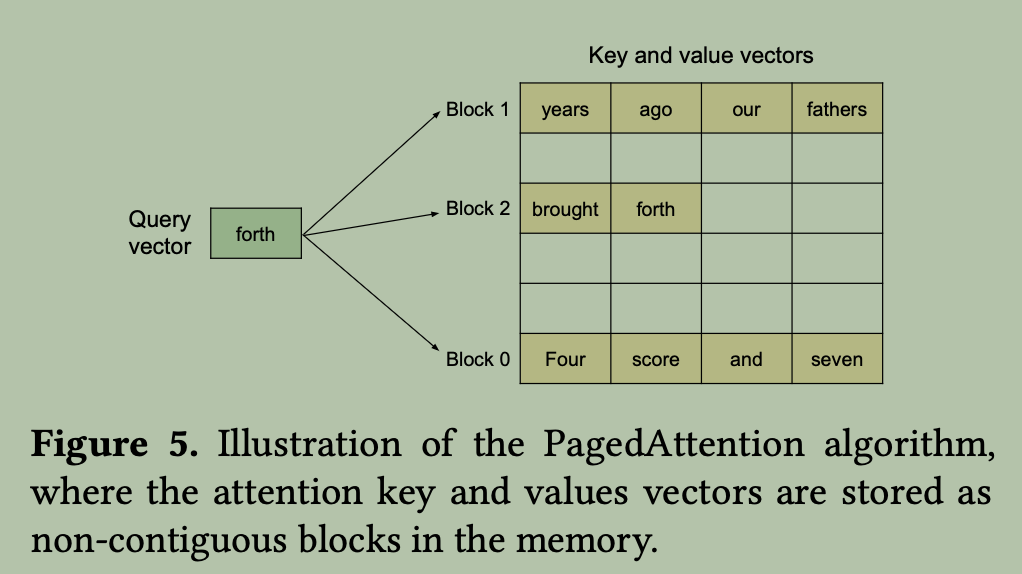
- 块化分割: 将序列的 KV Cache 划分为固定大小 \(B\)(如 \(B=16\))的 Block。第 \(j\) 个 Key 块表示为 \(K_j = (k_{(j-1)B+1}, \dots, k_{jB})\),Value 块表示为 \(V_j = (v_{(j-1)B+1}, \dots, v_{jB})\)。
- 分块注意力计算: 当前 Query 向量 \(q_i\) 与第 \(j\) 个 Key 块计算局部注意力得分行向量 \(A_{ij} \in \mathbb{R}^{1 \times B}\): \[A_{ij} = \frac{\exp(q_i K_j^\top / \sqrt{d})}{\sum_{t=1}^{\lceil i/B \rceil} \sum_{s=1}^B \exp(q_i k_{ts}^\top / \sqrt{d})}\] 最终输出 \(o_i\) 为各物理块 Value 矩阵与局部得分的加权和:\(o_i = \sum_{j=1}^{\lceil i/B \rceil} A_{ij} V_j\)。
- CUDA Kernel 执行逻辑:在注意力计算时,自定义的 CUDA Kernel 接收当前序列的物理 Block ID 列表,直接根据页表索引跳转到离散显存位置读取数据,无需在计算前做任何显存拼凑。
3.2 KV Cache Manager
- 基于 PagedAttention,将显存按照 OS 虚拟内存的 page/block 粒度进行管理,实现按需分配 & 映射连续的逻辑地址到不连续的真实内存地址。
- 每个 request 的 KV Cache 由一系列的逻辑 blocks 表示(logical block ids list),随着 request 的序列长度增长而动态分配。
3.3 Decoding with PagedAttention and vLLM
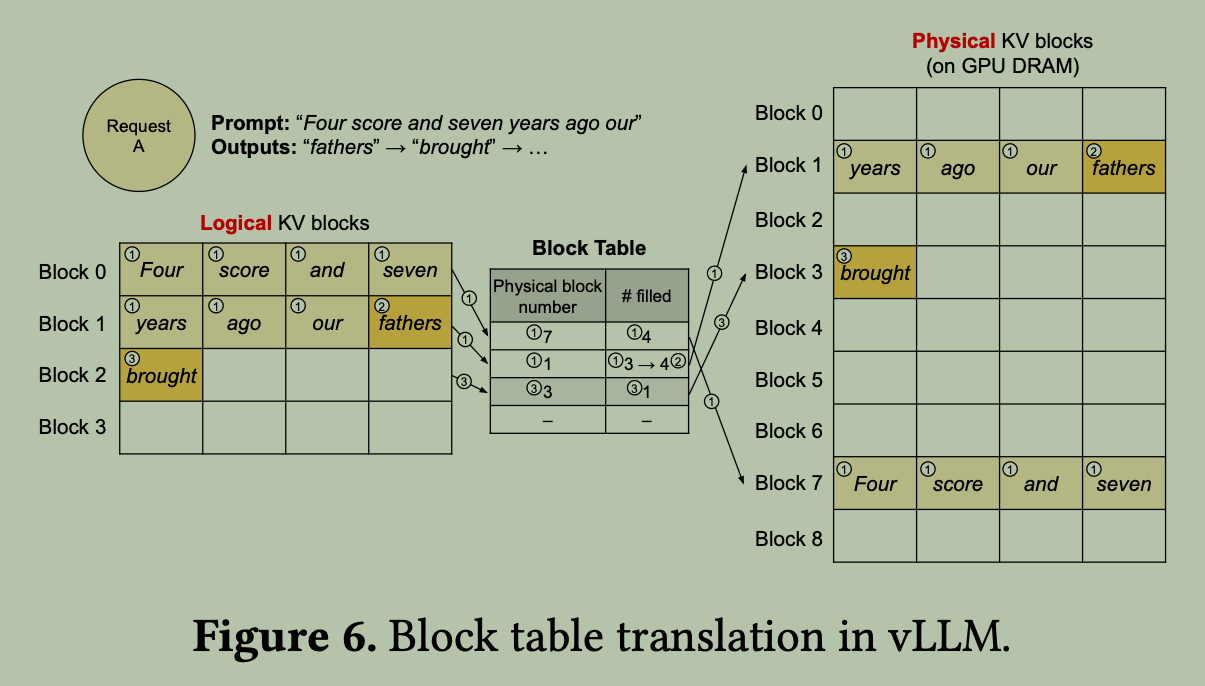
上图对应一个 request prefill + decode 执行过程以及 KV Cache block 分配过程:
- Prefill 阶段:7 个 token 只需要 2
个逻辑块。调度器映射
Logical Block 0 -> Physical Block 7(填满 4/4),Logical Block 1 -> Physical Block 1(填 3/4,预留 1 个空位)。 - Decode Step 1:生成新 token,直接写入 Physical
Block 1 的最后一个槽位,页表的
#filled字段更新为 4。 - Decode Step 2:再次生成新 token 时,发现 Logical
Block 1 已满,调度器动态申请一个新的物理块
Physical Block 3赋给Logical Block 2,并将新 token 存入其第 0 个位置。
3.4 Application to Other Decoding Scenarios
3.4.1 Parallel sampling
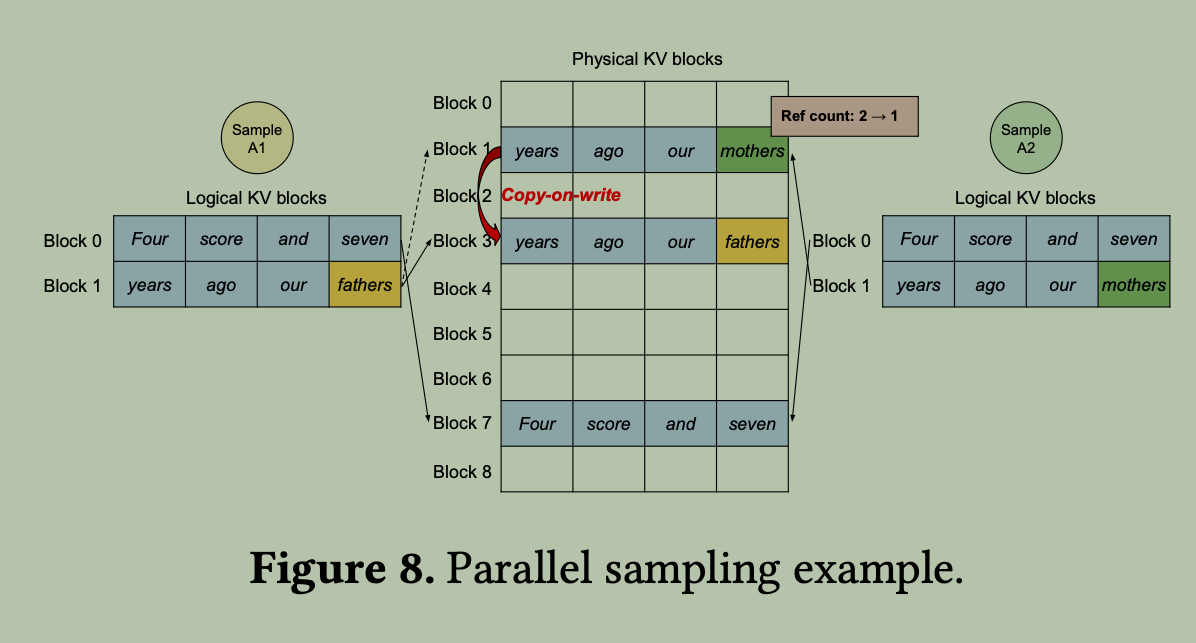
- 并行采样(Parallel Sampling): 当一个 Prompt
需要生成多个独立 Sample(如代码生成)时,所有 Sample
序列的初始逻辑块都直接指向同一个 Prompt 物理块,该物理块的引用计数设为
2。
- 写时复制(Copy-on-Write, CoW):当某个 Sample
需要向该共享 Block 写入新 token 时,系统检测到
Ref Count > 1,立即触发 Block 级别的拷贝:分配一个新的物理 Block,复制原数据,将旧物理 Block 的引用计数减 1,随后在新 Block 上独立写入。
- 写时复制(Copy-on-Write, CoW):当某个 Sample
需要向该共享 Block 写入新 token 时,系统检测到
3.4.2 Beam search
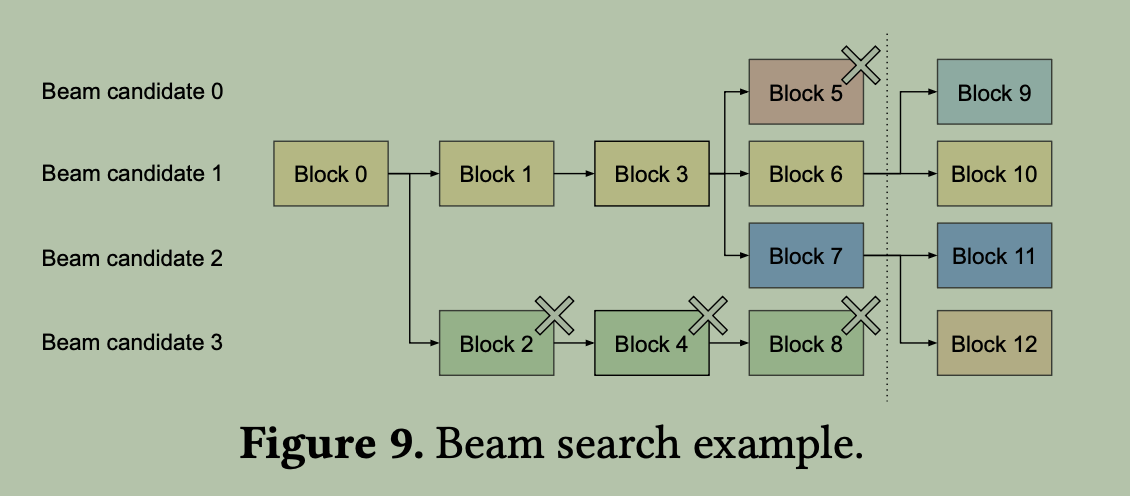
- 束搜索(Beam Search): 在 Beam Search 中,候选
Beam 之间不仅共享 Prompt,还会共享中间生成的公共上下文 Block。
- 当某条 Beam 分支因概率较低被剪枝(Prune)时,系统将其对应的物理 Block 引用计数减 1;一旦引用计数归零,该物理 Block 归还显存池。
- 这避免了传统 FasterTransformer 在 Beam 发生分化时高频复制整个连续 KV Tensor 的开销。
3.4.3 Shared prefix
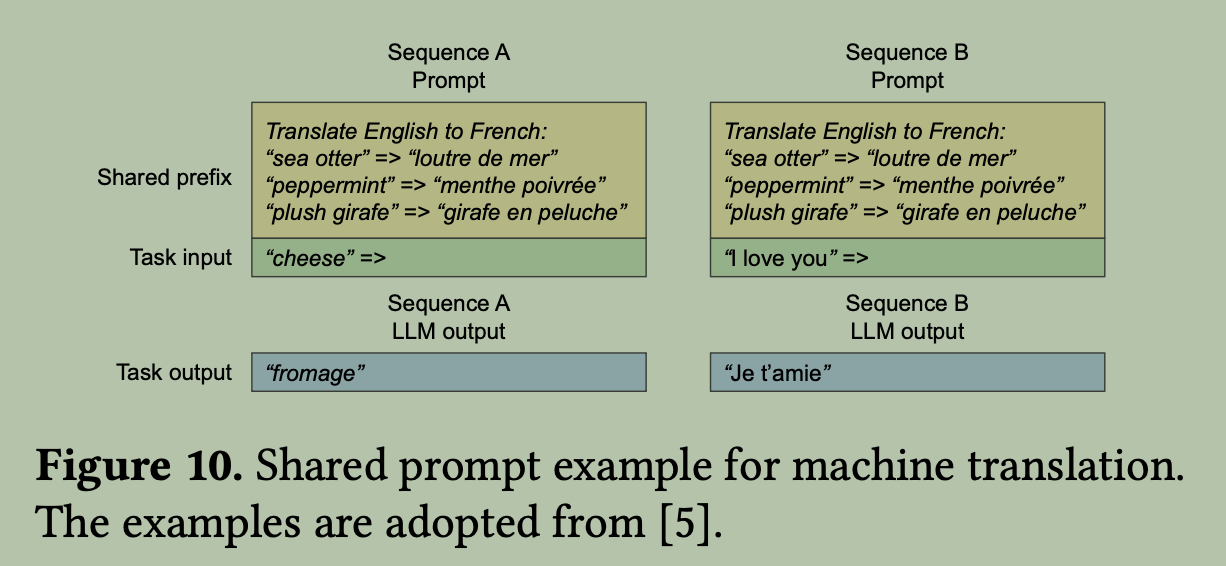
- 系统提示词共享(Shared System Prompt): 类似于 OS 中的共享动态链接库(Shared Library),常用的 Task Instruction 或 Few-shot 示例的 KV Cache 可以作为全局常驻物理 Block 提前缓存,所有新到请求只需把逻辑 Block 0 映射过去即可,实现零 Prefill 开销。
3.5 Scheduling and Preemption
当高并发流量涌入导致 GPU 物理 Block 耗尽时,vLLM 采用 FCFS(先到先服务) 调度策略与全有或全无(All-or-Nothing) 的抢占机制:
- Gang Scheduling:同一请求组(如 Beam Search 的多条分支)作为一个整体被调度或抢占。
- 被抢占请求的恢复机制:
- Swapping(换页):通过 CPU Block Manager 在主机内存中开辟 Swap 空间,将被抢占请求的 GPU Block 完整移到 CPU RAM。待 GPU 显存空闲后再 Swap In 恢复。
- Recomputation(重算):直接丢弃该请求已有的 KV Cache;等重新调度时,把之前已生成的输出 token 追加到 Prompt 后,重新跑一次 Prefill 批量生成 KV Cache。
3.6 Distributed Execution
在张量并行(Tensor Parallelism,如 Megatron-LM)多 GPU 环境下:
- 集中管理,分布式物理存储:GPU Worker 沿 Attention Head 维度切分模型。调度器只运行一个全局 Centralized KV Cache Manager,所有 GPU Worker 共享完全相同的逻辑到物理 Block Table 映射。
- 零内存同步开销:在每一个 Decode Step
开始时,调度器只需把统一的
Block Table广播给所有 Worker。每个 Worker 使用相同的物理 Block ID 存取各自负责的那部分 Attention Head 的 KV Cache,计算过程中只需通过 All-Reduce 同步激活值,无需在内存管理逻辑上做任何跨卡通信。
4. Implementation
- vLLM
- FastAPI 前端
- 代码实现:
- Python:控制面。
- C++/CUDA:PagedAttention 等核心操作实现。
- 基于 PyTorch/Transformers 实现常用模型。
- 使用 NCCL 进行 GPU worker 间 Tensor 通信。
4.1 Kernel-level Optimization
自定义 kernel 实现并优化 PagedAttention:
- Fused Reshape & Block Write(融合变形与写入算子) 在每个 Transformer 层中,新生成的 KV Cache 向量需要切分为块、重新塑造为适合 Block 访问的物理内存布局(Memory Layout),并写入页表指定的物理 Block 中。将切片、Reshape 和寻址写入融合为一个 CUDA Kernel,避免了多次 Kernel 启动的开销。
- Fused Block Read & Attention(融合读取与注意力计算算子) 基于 FasterTransformer 的 Attention Kernel 进行改写,使其能够直接根据页表列表在计算过程中“在线”读取离散物理 Block 里的 KV Cache。为了保证显存合并访问(Coalesced Memory Access),系统为每个 Block 分配一个 GPU Warp 来进行数据读取;同时支持单 Batch 内不同请求拥有可变序列长度。
- Fused Block Copy(融合块拷贝算子)
在触发写时复制(Copy-on-Write)或抢占换页时,需要对离散物理 Block
进行内存复制。如果直接调用异步拷贝 API(如
cudaMemcpyAsync),会导致大量微小数据块拷贝指令的频繁启动。作者实现了一个融合拷贝 Kernel,把不同 Block 的拷贝请求打包(Batch)在一次 Kernel Launch 中批量完成,降低了 PCIe / 显存搬运指令的 launch overhead。
4.2 Supporting Various Decoding Algorithms
为了统一支持各种复杂的解码策略(如 Parallel Sampling、Beam Search、Shared Prefix 等),vLLM 在逻辑层将所有解码算法的内存操作高度抽象为了 3 个核心方法(Primitives):
fork:从现有序列克隆创建一条新序列,内部逻辑为继承页表并增加物理 Block 的引用计数(Ref Count)。append:为指定序列追加新生成的 token,触发 PagedAttention 计算并按需写入或申请新 Block。free:当序列遇到终止符或被 Beam Search 剪枝时,释放该序列,将其页表对应物理 Block 的引用计数减 1,引用计数归 0 时收回物理 Block。
任何复杂的解码算法,在 vLLM 内部都可以看作是这 3 种基本原语的组合序列。这种设计隐藏了复杂的底层物理共享细节,使得上层调度器能够极其优雅地支持混合解码算法请求的同 Batch 处理。
5. Conclusion
- vLLM
- PagedAttention:logic block id -> physical block id