SGLang: Efficient Execution of Structured Language Model Programs
- SGLang: Efficient Execution of Structured Language Model Programs
- arXiv 提交日期:12 Dec 2023
- 代码:SGLang
- 作者:
摘要
大语言模型正越来越多地被用于处理复杂任务,这些任务往往需要多次生成调用、高级提示(Prompt)技术、控制流以及结构化输入/输出。然而,目前尚缺乏高效的系统来对这类应用进行编程与执行。为此,我们提出了 SGLang——一个用于高效执行复杂大语言模型程序的系统。
SGLang 由前端语言和后端运行时组成。前端通过提供用于生成与并行控制的原语简化了编程逻辑;后端运行时则通过创新性的优化技术来加速执行,包括用于键值缓存(KV Cache)复用的 RadixAttention,以及用于更高速结构化输出解码的压缩有限状态机(Compressed Finite State Machines)。
实验表明,在涵盖 Agent 控制、逻辑推理、Few-shot 学习基准、JSON 解码、检索增强生成(RAG)流水线和多轮对话等多种大语言模型及多模态模型任务中,SGLang 相比现有最先进的推理系统实现了最高 6.4 倍 的吞吐量提升。
项目代码已开源:https://github.com/sgl-project/sglang。
1. Introduction
- LM Program:
- 定义:指使用程序来调度和控制大语言模型(LLM)生成过程的编程范式(Language Model Programs,LM Programs)。它将多轮规划、推理、工具调用以及各种高级 Prompt 技术(如 Few-shot、Self-consistency、Tree-of-thought 等)统一封装为结构化的多调用生成序列。
- 特点:
- 多调用与控制流交织:通常包含多次存在依赖关系的 LLM 生成调用,并穿插分支、循环等控制流,以完成复杂任务并提升生成质量。
- 结构化输入与输出:接收结构化输入并产生结构化输出(如 JSON 格式),从而支持 LM Program 的模块化组合以及与现有软件系统的无缝整合。
- LM Program 存在的问题:
- 前端开发繁琐且困难:由于 LLM 输出的非确定性,开发人员需要编写大量复杂的字符串拼接、手动的 Prompt 调优、脆弱的输出解析以及并发控制逻辑,导致代码可读性极差且容易出错。
- 后端执行严重低效:现有主流推理引擎(如
vLLM、TGI、TensorRT-LLM)由于无法直接感知上层程序的 Workload
结构,导致严重的计算与显存浪费:
- KV Cache 重复计算:复杂工作流中存在大量共享前缀,但现有系统在单个请求结束后直接丢弃 KV Cache,无法在多个调用间自动复用。
- 结构化解码速度受限:在 JSON 等规则约束解码时,现有系统与语法自动机解耦,仅能逐 Token 掩码过滤并预测,无法一次性批量解码多 Token 的确定性字符串。
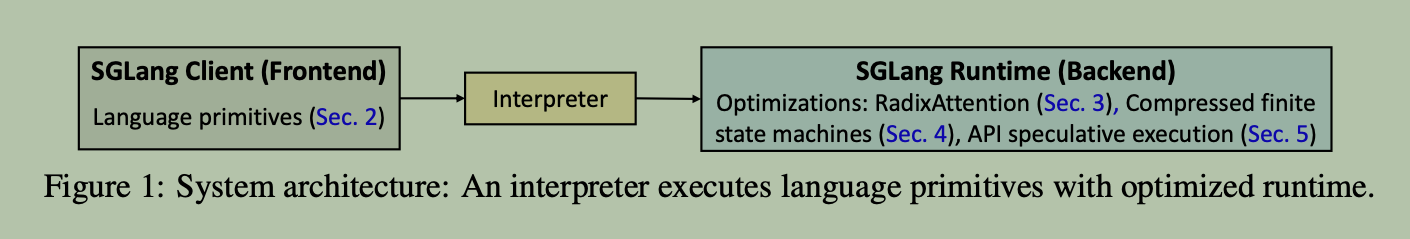
- 本文提出的解决方法:SGLang(Structured
Generation Language for LLMs)
- front-end language
- 作为嵌入在 Python 中的领域特定语言(DSL),提供了用于文本生成(如
extend、gen、select)和并行控制(如fork、join)的语言原语。 - 兼容 Python 的控制流和第三方库;其异步流解释器将 Prompt 状态管理为数据流,实现程序内的高效并发与同步控制。
- 作为嵌入在 Python 中的领域特定语言(DSL),提供了用于文本生成(如
- back-end runtime
- RadixAttention:利用 Radix Tree 在显存中管理所有请求的 KV Cache,配合 LRU 淘汰策略与缓存感知调度算法,实现跨请求、跨分支前缀复用。
- Compressed FSM(压缩有限状态机):分析正则约束,将单向确定转移路径压缩为单边,实现多 Token 一次性批量解码(Jump-Forward)。
- API Speculative Execution(API 推测执行):针对 GPT-4 等黑盒 API 节点,通过 APT 推测执行优化多轮调用 LLM 程序的效率。
- front-end language
- 效果:
- 在 Agent 控制、逻辑推理、Few-shot 基准、JSON 解码、RAG 和多轮对话等多种开源大语言模型及多模态模型(如 LLaVA)任务中,相比 Guidance、vLLM、LMQL 等最新系统,SGLang 实现了最高 6.4× 的吞吐量提升。
2. Programming Model
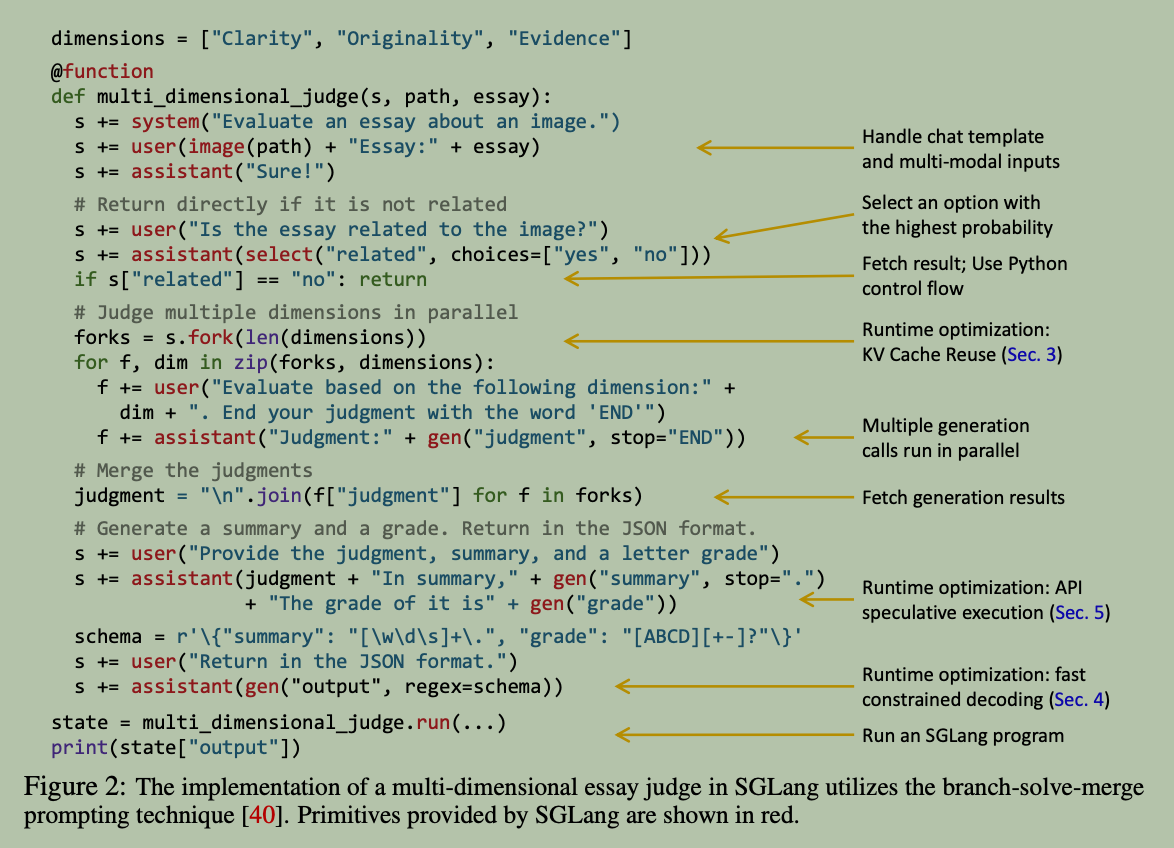
- 上图展示了使用 SGLang DSL 实现:使用 LLM 进行看图写论文评分。
- 函数参数含义:
- 状态
s:使用+=将系统提示词、图片路径path和文章essay追加到 Prompt 状态。 - 图片路径
path - 论文文本:
essay
- 状态
- 函数流程:
- 先判断图片与论文是否相关,不相关直接返回;
- 相关的话从三个维度进行打分;
- 输出总结并进行最终打分。
- 函数参数含义:
- 语言原语(Language Primitives):
- 生成控制:
gen:调用模型生成文本,结果存入指定变量名中;支持regex参数提供正则表达式约束(如 JSON Schema)。select:计算并选择候选列表中概率最高的选项。+=/extend:将新文本、变量或原语追加到当前 Prompt 状态流中。[variable_name]:提取指定生成变量的结果(如s["related"])。
- 并发与分叉:
fork:基于当前 Prompt 状态创建多个并发分支(Forks)。join:阻塞并归并多个分支的 Prompt 状态。
- 多模态扩展:
image/video:直接接收并处理图像与视频输入。
- 生成控制:
- 运行时优化切入点(Runtime Opportunities):
- RadixAttention:利用
fork原语透传的前端 Hint,自动捕获并复用跨请求/跨分支的 KV Cache。 - Compressed FSM:针对
gen(regex=...)的确定性路径,压缩转移状态实现 Jump-Forward 批量解码。 - API Speculative Execution:针对 GPT-4 等黑盒 API 节点,通过推测执行减少重复 Prompt 发送与计费。
- RadixAttention:利用
3. Efficient KV Cache Reuse with RadixAttention
RadixTree 随着 requests 变化而变化示意图如下:
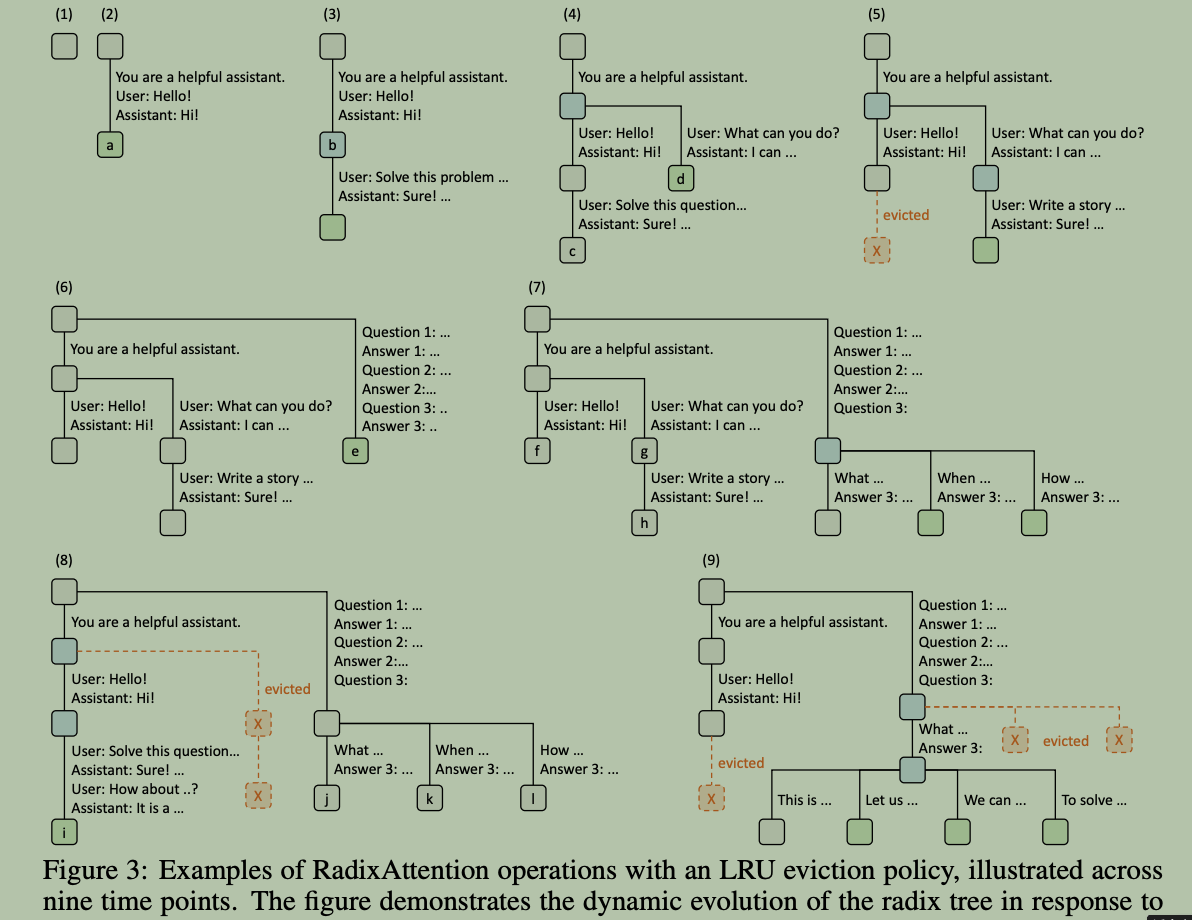
上图展示的流程解释如下:
- Step (1) — 初始状态:Radix Tree 初始状态为空。
- Step (2) — 首次对话处理:服务器处理传入的用户消息
"Hello!"并生成回复"Hi!"。系统提示词("You are a helpful assistant")、用户消息("Hello!")和模型回复("Hi!")被合并为一条单边并连接到一个新节点(节点 a)。 - Step (3) — 对话延续与缓存复用:接收到同一对话的新 Prompt。服务器在 Radix Tree 中成功匹配到该 Prompt 的前缀(即第一轮对话历史),直接复用已有的 KV Cache,并将新一轮对话作为新节点(节点 b)追加到树中。
- Step (4) — 新会话开启与节点拆分:开启一个新的 Chat
会话。为了让两个不同的 Chat 会话能够共享公共的系统提示词前缀,步骤 (3)
中的节点
b被拆分为两个节点(节点 c 和节点 d)。 - Step (5) — 显存限制与 LRU 淘汰:第二个 Chat
会话继续进行。但由于达到了显存容量上限,步骤 (4) 中的节点
c被 LRU 策略驱逐(Evict);新一轮对话被追加在节点d之后。 - Step (6) — 无共享前缀请求与根节点分裂:服务器收到一个 Few-shot 学习查询。由于该新查询与现有树节点没有任何公共前缀,根节点发生分裂并插入新节点(节点 e)。
- Step (7) — 批量 Few-shot
请求与多路共享:服务器收到一批额外的 Few-shot
学习查询。由于这些查询共享同一组 Few-shot 示例,系统将步骤 (6) 中的节点
e进行拆分,使这组示例可以被多个并发请求共享(生成节点 f, g, h)。 - Step (8) — LRU 驱逐非活跃会话:第一个 Chat
会话收到新消息。由于第二个 Chat 会话的节点(节点
g和h)属于最久未使用的节点,系统将其驱逐以腾出显存空间,并追加新对话节点(节点 i)。 - Step (9) — Self-consistency
采样与空间清理:服务器收到对步骤 (8) 中节点
j所含问题进行多答案采样的请求(常用于 Self-consistency 提示)。为了给这批并发采样请求腾出显存,系统驱逐了步骤 (8) 中的节点i、k和l。
RadixAttention
- Radix Tree(基数树)数据结构:
- 系统在 CPU 侧维护一棵 Radix Tree,树的边(Edge)标记为连续的 Token ID 序列,节点(Node)映射到 GPU 中非连续的、以页(Page)为单位存储的 KV Cache 张量指针。
- 相较于传统 Trie 树,Radix Tree 允许单条边包含变长的 Token 序列,降低了内存占用。
- 统一内存池(Unified Memory Pool)与动态分配:
- 系统不预先划分固定大小的专用 Cache 显存池,而是让“已缓存的历史 Token”与“当前正在运行的 Request”共享同一个 GPU 物理显存池。
- 当等待队列中待处理的请求增多时,系统会自动驱逐历史缓存以扩大 Batch Size;在空闲时则尽可能保留缓存。
- 引用计数(Reference Counter)与 LRU 叶子节点驱逐:
- 在 Continuous Batching 动态批处理中,每个树节点维护一个引用计数,记录当前有多少个正在运行的请求在使用该节点。引用计数大于 0 的节点不可被驱逐。
- 当显存不足需要回收时,系统执行 LRU(Least Recently Used)淘汰策略,且严格优先驱逐叶子节点(Leaf Nodes)。驱逐叶子节点可以保留它们的公共祖先节点,使公共前缀继续留在显存中供后续请求复用。
Cache-aware scheduling
如果调度器随机或仅按先到先服务(FCFS)顺序处理请求,会导致在无关请求间频繁切换,触发严重缓存抖动(Cache Thrashing)。
- 最长共享前缀优先(Longest-Shared-Prefix-First):
- 在调度等待队列中的请求时,系统计算各请求与当前 Radix Tree 中已知节点的匹配前缀长度,优先将匹配共享前缀最长的请求打包打入下一个 Batch。
调度算法伪代码如下:
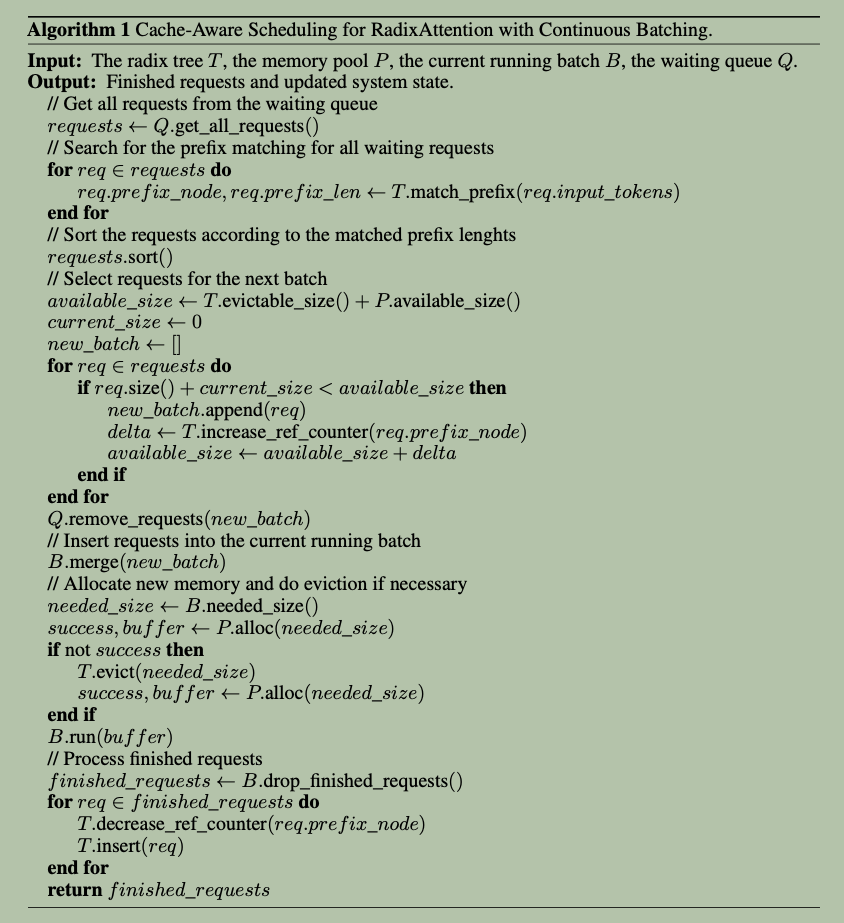
- 需要遍历 waiting queue 做 RadixTree 前缀匹配,以实现最高理论 KV Cache 命中率;在线 serving 场景还需要同时考虑 request 排队时延 & 饥饿问题。
Distributed Cases
- 张量并行(TP):各 GPU Worker 分片存储物理 KV Cache,而 CPU 侧的 Radix Tree 逻辑完全一致,树操作无需额外的 CUDA 跨卡同步。
- 数据并行(DP): Router 维护全局 Meta-Tree(元树),各 Worker 维护本地 Sub-tree。Router 根据请求与 Worker 的前缀亲和度(Affinity)做负载均衡分发,并在后台异步低峰期弱一致同步驱逐状态。
4. Efficient Constrained Decoding with Compressed Finite State Machine
问题
在此之前的框架(如 Outlines、Guidance、vLLM 早期)处理结构化输出(如:JSON 等)的方法是:
- 将正则表达式或 JSON 语法转化为有限状态机(Finite State Machine, FSM)。
- 在模型解码时,维护当前的 FSM 状态。每生成下一个 Token 前,查询 FSM 找出所有合法的候选 Token,把非法 Token 的 Logits 概率设为 \(-\infty\)(即 Logits Mask 过滤)。
- 缺陷:这种做法必须逐
Token(One-token-at-a-time)预测。但在 JSON
等语法中,存在大量结果绝对确定的常量字符串(例如
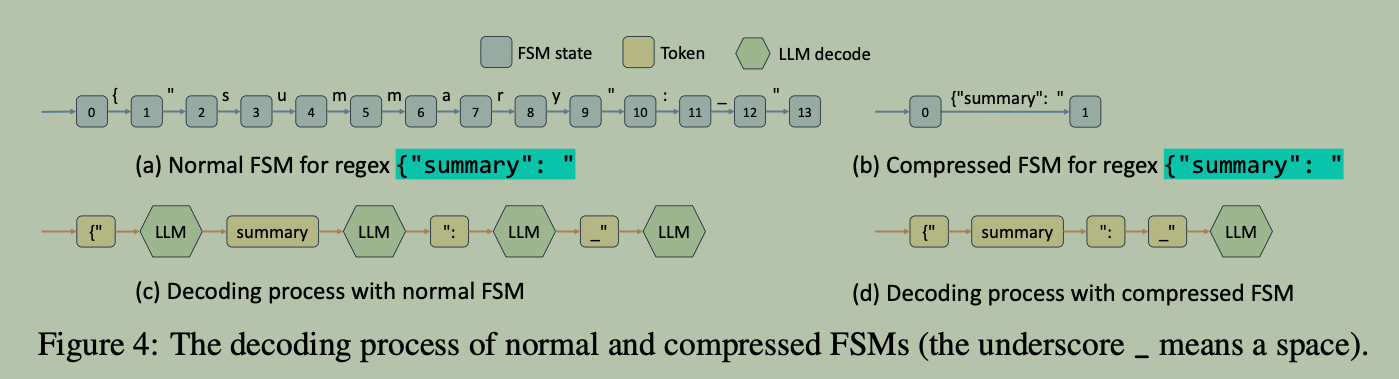
{"summary": ")。在 FSM 图中,这些节点之间的转移路径是唯一的(Singular Transition)。传统系统因为 FSM 与模型推理引擎解耦,依然让 GPU 跑多次昂贵的自回归前向传播(Forward Pass)来一次产生一个 Token,造成极大的延迟与算力浪费。
SGLang 解决方法
SGLang 提出了压缩有限状态机(Compressed FSM),打破了 FSM 与推理引擎之间的壁垒:
- 边压缩(Edge Compression):分析 FSM
图结构,将连续的“单向确定转移边(Singular-transition
edges)”压成一条“压缩边(Compressed
Edge)”。例如将单字符转移的
{',s,u,m,m,a,r,y,",:, } 直接合成一整条字符串边{"summary": "。 - 跳跃解码(Jump-Forward Decoding):当 FSM 处于压缩边时,系统完全跳过 GPU 的自回归采样与 Logits Mask 计算,直接把这段确定的字符串一次性追加到输入中,跑单次 Prefill(Forward Pass)。这相当于将数十步自回归解码压缩为 1 次 Forward。
- 处理分词失配(Retokenization
Artifacts):直接追加字符串可能会破坏模型 Tokenizer
的分词对齐(如
{"和summary连在一起可能会被切成不同的 Token)。SGLang 在进行 Jump-Forward 时,会把前文与压缩字符串一起用原生 Tokenizer 重新分词(Retokenize),确保模型输入状态严格一致。
5. Efficient Endpoint Calling with API Speculative Execution
问题
在前文的第 3 节(RadixAttention)和第 4 节(Compressed FSM)中,针对的都是开源权重模型(Open-weight Models),系统可以通过直接控制 GPU 显存中的 KV Cache 或修改模型前向传播时的 Logits Mask 来实现加速。
但在面对 GPT-4 等闭源模型时,开发者只能调用黑盒 API Endpoint:
- 重复计费与高延迟:在一个包含多次
gen的程序中(例如:先生成姓名gen("name", stop="\n"),再生成职业gen("job", stop="\n")),朴素的实现方式必须发起两次独立的 API 请求。 - 重复 Context:在第二次调用时,用户必须将前面的长上下文(Context)以及第一次生成的内容重新发送给 API,导致用户为相同的上下文反复支付昂贵的 Input Token 费用,同时也增加了多次 HTTP 网络往返的延迟。
SGLang 解决方法
- 忽略 Stop 条件多生成(Over-generation):
在发起第一次
gen调用时,SGLang 解释器会开启推测模式,故意忽略当前的 stop 终止符约束,让闭源 API 在生成完第一个目标字段后,顺着模版继续多生成若干个 Token。 - 前端匹配与截断(Client-side Matching): 前端解释器接收到这串较长的输出后,会自动拦截并暂存后续推测多生成的 Token,然后对其进行模式匹配。
- 跳过后续 API 调用(Hit & Reuse):
当程序执行到接下来的
gen原语时,如果推测出来的 Token 内容恰好匹配了后面的 Prompt 模版与生成需求,解释器就直接使用推测结果,彻底取消下一次 API HTTP 请求。
当前并无实际应用。
6. Conclusion
- SGLang
- RadixAttention
- KV Cache Reuse
- Compressed Finite State Machine
- Improve decode speed
- RadixAttention