LoRA: Low-Rank Adaptation of Large Language Models
- LoRA: Low-Rank Adaptation of Large Language Models
- arXiv 提交日期:17 Jun 2021
- 代码:LoRA
- 作者:
摘要
自然语言处理的一个重要范式是在通用领域数据上进行大规模预训练,随后针对特定任务或领域进行适配。随着预训练模型规模的不断增大,重新训练所有模型参数的全参数微调(Full Fine-Tuning)变得越来越不可行。以 1750 亿参数的 GPT-3 为例,为每个下游任务独立部署一套拥有 1750 亿参数的微调模型实例,其成本高昂到难以承受。
为此,我们提出了低秩适应(Low-Rank Adaptation,简称 LoRA)。该方法通过冻结预训练模型的权重,并在 Transformer 架构的每一层注入可训练的秩分解矩阵,大幅减少了下游任务的可训练参数量。与使用 Adam 优化器全微调的 GPT-3 175B 相比,LoRA 可将可训练参数量减少 10,000 倍,并将 GPU 显存需求降低 3 倍。
尽管可训练参数更少且训练吞吐量更高,LoRA 在 RoBERTa、DeBERTa、GPT-2 和 GPT-3 上的模型表现仍与全微调持平甚至更优。此外,与传统 Adapter 不同,LoRA 不会引入任何额外的推理延迟。我们还对语言模型适配中的“秩亏缺”(Rank-Deficiency)现象进行了实证研究,揭示了 LoRA 有效性的内在原因。
我们发布了一个便于将 LoRA 集成到 PyTorch 模型中的工具包,并在 https://github.com/microsoft/LoRA 开源了针对 RoBERTa、DeBERTa 和 GPT-2 的具体实现与模型检查点(Checkpoints)。
1. Introduction
- NLP 任务范式:大规模预训练 + 下游特定任务微调。
- 存在的问题:
- 微调需要重新训练全部参数,成本高昂。
- 每个下游任务对应一个大模型 checkpoint,给推理部署也带来困难。
- 已有方法及优缺点:
- 已有方法:仅微调部分参数或者增加新的可学习参数。
- 优点:仅需要保存/加载修改的部分参数,降低 checkpoint 存储和模型部署成本。
- 缺点:
- 带来了额外的推理时延:通常由增加模型深度或减少了模型可用上下文长度带来。
- 对比全量微调效果一般有 loss。
- 本文方法:
- Motivation:
- 已有工作证明了模型的参数是过度参数话的,其内在维度其实较低。
- 作者认为在模型针对特定任务微调时,参数变化也满足内在维度较低这一特性。
- 方法:Low-Rank Adaptation (LoRA)
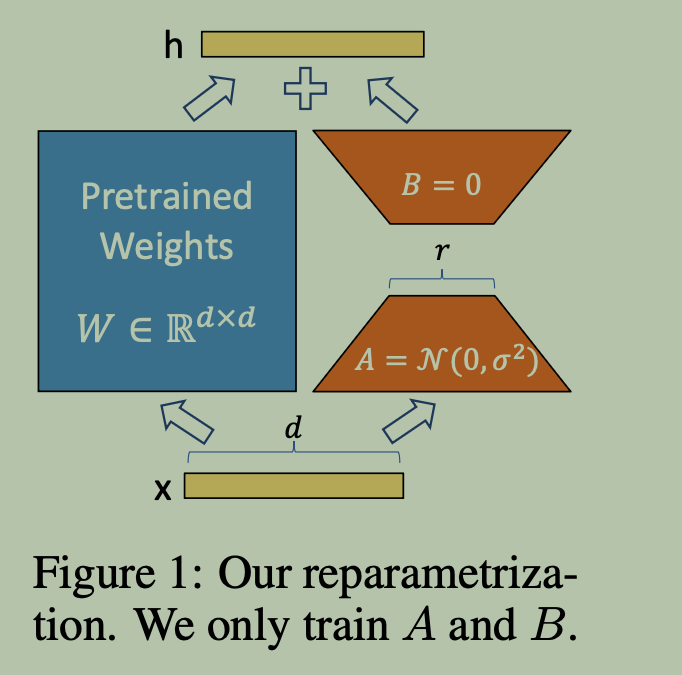
- 如下图所示:冻结预训练参数,使用低秩分解矩阵作为可学习参数进行微调。
- Motivation:
- 效果:
- 减少微调模型显存/计算成本。
- 低秩分解矩阵在推理时可融合到预训练参数,无额外推理时延。
2. Problem Statement
假设给定一个由参数 \(\Phi\) 参数化的预训练语言模型 \(P_{\Phi}(y \mid x)\),下游特定任务的训练集由上下文-目标序列对 \(Z = \{(x_i, y_i)\}_{i=1..N}\) 组成。
在传统的全参数微调范式中,模型参数从预训练权重 \(\Phi_0\) 开始初始化,通过在训练集上最大化条件语言模型对数概率更新至 \(\Phi_0 + \Delta\Phi\):
\[ \max_{\Phi} \sum_{(x,y) \in Z} \sum_{t=1}^{|y|} \log P_{\Phi}(y_t \mid x, y_{<t}) \]
全参数微调的核心瓶颈在于:针对每个不同的下游任务,都会训练并产生一套独立的增量参数 \(\Delta\Phi\),且其参数维度与原始预训练模型一致,即 \(|\Delta\Phi| = |\Phi_0|\)。对于像 GPT-3(1750 亿参数)这样的超大模型,独立存储和部署多个针对不同任务的微调检查点极其昂贵甚至不可行。
为了解决存储与部署难题,论文提出使用一组规模远小于原始模型参数的参数集 \(\Theta\)(满足 \(|\Theta| \ll |\Phi_0|\))来隐式编码任务特定的参数增量 \(\Delta\Phi(\Theta)\)。训练过程从全参数优化转化为对参数集 \(\Theta\) 的极大似然估计:
\[ \max_{\Theta} \sum_{(x,y) \in Z} \sum_{t=1}^{|y|} \log P_{\Phi_0 + \Delta\Phi(\Theta)}(y_t \mid x, y_{<t}) \]
LoRA 正是这一重构下的具体实现方法,本文通过低秩分解(Low-Rank Representation)来构造 \(\Delta\Phi(\Theta)\),成功将 GPT-3 175B 的可训练参数量 \(|\Theta|\) 压缩至原始参数量的 0.01%。
3. Aren't Existing Solutions Good Enough?
已有的 LLM 微调方法主要分为两类:
- 增加适配器层。
- 虽然适配器层参数量 & FLOPS
都很小,但是还是会对推理时延产生明显影响。
- 串行处理新增 adapter 层,且 dim 一般较小,无法利用 GPU 的并行计算能力。
- 在线服务 batch size 较小时,此时硬件并行度受限,串行延迟被显著放大。在 GPT-2 Medium 上的测试显示,在 Batch Size = 1、序列长度 128 的条件下,引入 Adapter(Adapter L 或 Adapter H)会导致单次前向传播延迟增加 20.7% 至 30.3%。
- 当超大模型需要跨多张 GPU 进行分片部署(Model Parallelism / Sharding)时,增加的网络深度要求更多的跨卡同步节点(如 AllReduce 和 Broadcast 操作),进一步拉高了延迟,除非在每张卡上冗余存储 Adapter 参数。
- 虽然适配器层参数量 & FLOPS
都很小,但是还是会对推理时延产生明显影响。
- 优化输入层激活值的某种形式。
- 优化非常稳定(非单调性):Prefix-Tuning 对超参数极其敏感,模型表现随可训练参数量的增加呈现非单调变化(Non-monotonic),过量增加前缀 Token 甚至会导致性能骤降。
- 挤占有效上下文序列长度:Prefix-Tuning 必须显式占用 Transformer 的输入序列位置来放置可训练的前缀向量。由于模型的最大序列长度固定,这必然减少了实际可用于处理 downstream 任务输入 Token 的有效上下文空间。
4. Our Method
4.1 Low-Rank-Parametrized Update Matrices
- 核心参数化公式:对于预训练模型中的任意全秩矩阵 \(W_0 \in \mathbb{R}^{d \times k}\),LoRA 将其适应下游任务时的累积梯度更新量 \(\Delta W\) 约束为低秩分解结构 \(\Delta W = BA\)。其中 \(B \in \mathbb{R}^{d \times r}, A \in \mathbb{R}^{r \times k}\),且秩 \(r \ll \min(d, k)\)。
- 前向传播与初始化:在前向传播中,\(W_0\) 保持冻结不接收梯度更新,仅优化 \(A\) 和 \(B\)。两路径输出逐坐标相加:
\[ h = W_0 x + \Delta W x = W_0 x + BAx \]
矩阵 \(A\) 采用高斯分布 \(\mathcal{N}(0, \sigma^2)\) 初始化,矩阵 \(B\) 初始置为 0,确保训练开始时 \(\Delta W = BA = 0\),模型输出与预训练状态完全一致。
- 缩放因子 \(\frac{\alpha}{r}\):在前向计算中对 \(\Delta W x\) 乘以常数因子 \(\frac{\alpha}{r}\)。将 \(\alpha\) 设定为常数后,在调整不同的秩 \(r\) 时,学习率的缩放基本无需重新调参,简化超参数搜索。
- 全微调的泛化:LoRA 是全参数微调的一般化扩展。当逐步增大 \(r\) 直至达到原始矩阵 \(W_0\) 的秩时,LoRA 的表达能力收敛于全微调。相比之下,Adapter 方法收敛至 MLP,而 Prefix 方法则受限于序列长度。
- 零额外推理延迟:在生产部署时,可以直接显式计算合并矩阵 \(W = W_0 + BA \in \mathbb{R}^{d \times k}\),维持原有的推理速度,没有任何结构性延时。当需要切换任务时,只需减去 \(BA\) 并加回新的 \(B'A'\) 即可。
4.2 Applying LoRA to Transformer
- 重点作用模块: Transformer 的自注意力模块包含 4 个权重矩阵(\(W_q, W_k, W_v, W_o\)),MLP 模块包含 2 个矩阵。
- 实验裁剪范围:为了保持参数极简洁与高效,论文将研究范围限制在仅对自注意力层的权重矩阵施加 LoRA,而将 MLP 模块、LayerNorm 及偏置项完全冻结。
优缺点
- 优点::
- 显存与存储剧降:以 GPT-3 175B(Adam 优化器)为例,训练阶段的 GPU 显存消耗从 1.2TB 降至 350GB(降低约 2/3),因为无需为 99.99% 的冻结参数维护优化器状态。在 \(r=4\) 且仅作用于 \(W_q, W_v\) 时,检查点体积从350GB 压缩至 35MB(缩小约 10,000 倍)。
- 训练吞吐量提升:由于绝大部分参数无需计算梯度,GPT-3 175B 的训练吞吐量比全微调提升了约 25%。
- 便捷的在线多任务切换:在云端部署时,只需将 350GB 的主干模型常驻 GPU 显存,即可在毫秒级内动态切换不同任务的几十兆 LoRA 模块。
- 缺点::
- 若为了消除推理延时而将 \(W_0 + BA\) 合并为单个矩阵,在单次前向传播中混杂处理不同任务(不同 \(A, B\))的并发请求(Multi-task Batching)变得不够直接。如果不合并权重以支持动态 Batch 处理,就必须保留旁路计算。
5. Understanding the Low-Rank Updates
5.1 Which Weight Matrices in Transformer Should We Apply LoRA to?
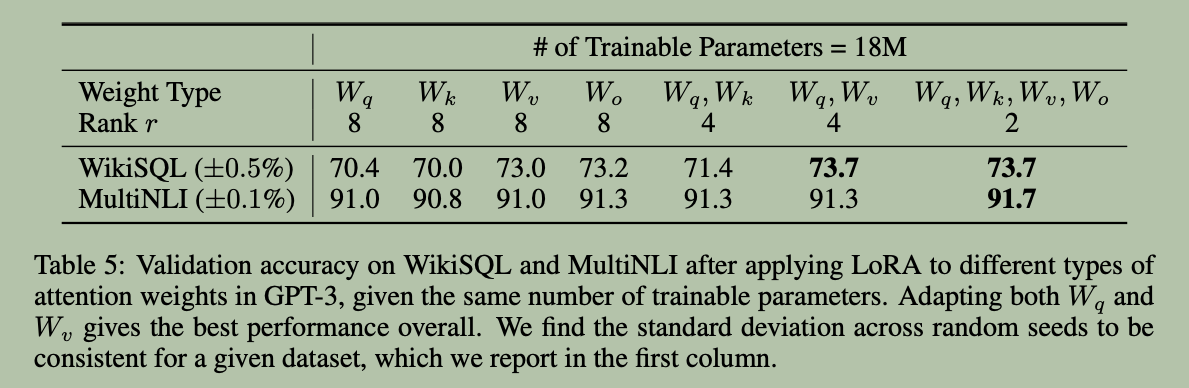
- 实验设计:在 GPT-3 175B 上固定 18M 参数预算(约
35MB FP16 显存开销)。对比两种策略:
- 集中策略:仅对单一类型的注意力矩阵施加较粗的秩(如仅对 \(W_q\) 或 \(W_k\) 施加 \(r=8\))。
- 分散策略:同时对多种类型的注意力矩阵施加较小的秩(如对 \(\{W_q, W_v\}\) 施加 \(r=4\),或对 \(\{W_q, W_k, W_v, W_o\}\) 施加 \(r=2\))。
- 实证结果:
- 将所有参数预算用在单一矩阵上(如仅微调 \(W_q\))表现最差(WikiSQL 准确率为 70.4%)。
- 同时微调 \(W_q\) 和 \(W_v\)(\(r=4\)),或同时微调全部 4 个注意力矩阵(\(r=2\)),表现显著提升(WikiSQL 准确率提升至 73.7%)。
- 核心结论:在固定参数预算的前提下,“分散对更多权重矩阵施加更小的秩”远比“集中对单一权重矩阵施加更大的秩”更为高效。
5.2 What is the Optimal Rank \(r\) for LoRA?
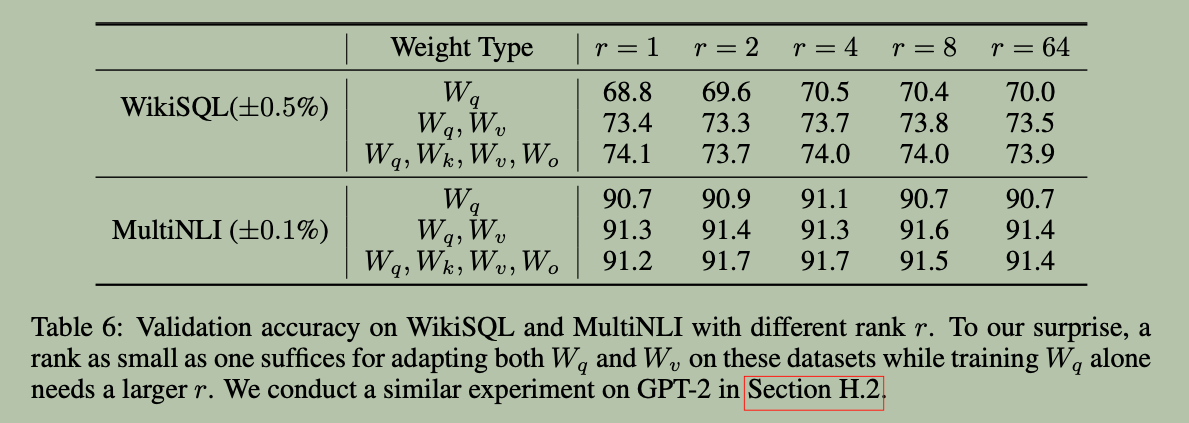
- 时延结果: 当同时对 \(\{W_q, W_v\}\) 施加 LoRA 时,极小的秩(\(r=1\) 或 \(r=2\))就已经能取得与 \(r=64\) 相当的性能(例如在 MultiNLI 上,\(r=1\) 为 91.3%,\(r=64\) 为 91.4%)。
- 基于 Grassmann 距离的子空间相似度分析: 为了解释为什么增大 \(r\) 无法带来额外收益,作者对不同秩(如 \(r=8\) 与 \(r=64\))学习到的更新矩阵进行奇异值分解(SVD),并利用基于 Grassmann 距离的归一化子空间相似度 \(\phi\) 来测量它们右奇异向量矩阵 \(U_{A_{r=8}}\) 和 \(U_{A_{r=64}}\) 之间的重合度:
\[ \phi(A_{r=8}, A_{r=64}, i, j) = \frac{\|U_{A_{r=8}}^{i\top} U_{A_{r=64}}^j\|_F^2}{\min(i, j)} \]
- 数学洞察:
- \(r=8\) 与 \(r=64\) 在最高阶的第 1 个主奇异向量方向上呈现出极高的重合度(归一化相似度 \(> 0.5\)),而在后续的高阶方向上迅速解耦。
- 对比不同随机种子训练出的模型亦验证了这一现象:特定任务的固有增量子空间极小,增大 \(r\)(如增至 \(r=64\))并没有覆盖更多有意义的表达空间,反而引入了更多在训练过程中累积的梯度噪声。
5.3 How Does the Adaptation Matrix \(\Delta W\) Compare to \(W\)?
将预训练矩阵 \(W\) 投影到增量矩阵 \(\Delta W\) 的 \(r\) 维主奇异向量空间上(即计算 Frobenius 范数 \(\|U^\top W V\|_F\)),测量 \(\Delta W\) 与 \(W\) 的空间重合度与能量放大效应:
- 选择性提纯与非重叠: \(\Delta W\) 与 \(W\) 的相关性显著高于随机矩阵,但 \(\Delta W\) 并没有重叠 \(W\) 中最强的主奇异向量方向。它专门挑选并强调那些在预训练阶段已经学到、但在通用任务中未被突出的特征方向。
- 巨额的“特征放大倍数”(Amplification Factor):
- 将特征放大系数定义为增量范数与投影范数的比值 \(\frac{\|\Delta W\|_F}{\|U^\top W V\|_F}\)。
- 对于 \(r=4\),该放大系数高达 21.5 倍(即 \(\frac{6.91}{0.32}\))。
- 对于 \(r=64\),放大系数剧降至约 2 倍。
- 几何本质总结: 在预训练模型庞大的特征空间中,每个 Transformer 层通常只需要挑选出约 4 个关键的下游特征方向,并将其强行放大 20 倍以上,即可完成向特定下游任务的精准迁移。当 \(r\) 过大时,多余的方向无法获得高倍率放大,验证了低秩结构的必然性。
6. Conclusion
- LoRA
- 训练:\(h = W_0 x + \Delta W x = W_0 x + BAx\) 。
- 推理:\(h = W_0 x + \Delta W x = W_0 x + BAx = (W_0 + BA)x\) ,参数 \(BA\) 融合进预训练权重,不带来额外推理时延。