GPT-2: Language Models are Unsupervised Multitask Learners
- Language Models are Unsupervised Multitask Learners
- OpenAI Technical Report,blog 链接:Better language models and their implications ,发布日期:February 14, 2019
- 官方 GitHub repo(TF 实现):gpt-2 ,仅公布了小模型权重
- transformers GPT-2 实现:modeling_gpt2.py
- 作者:
GPT-2 基本信息:
- 模型规模:1.5 B 参数。
- 训练数据集:WebText 数据集,800 万个网页构成,约 40 GB。
- 训练 loss:预测 next token。
- zero-shot 范式,预训练后无任何微调过程(只需要输入合适的 prompts)。
摘要:
自然语言处理任务,例如问答、机器翻译、阅读理解和摘要,通常采用针对特定任务数据集的监督学习来解决。我们证明,当在一个名为 WebText 的数百万网页的新数据集上训练时,语言模型开始在没有显式监督的情况下学习这些任务。当以文档加问题为条件时,语言模型生成的答案在 CoQA 数据集上达到 55 F1——在没有使用 127,000 多个训练样本的情况下,匹配或超过了 4 个基线系统中的 3 个。语言模型的容量对于零样本任务迁移的成功至关重要,增加容量会以对数线性方式提升跨任务的性能。我们最大的模型 GPT-2 是一个 15 亿参数的 Transformer,在零样本设置下,在 8 个被测试的语言建模数据集中的 7 个上取得了最先进的结果,但仍然欠拟合 WebText。该模型的样本反映了这些改进,并包含连贯的文本段落。这些发现为构建语言处理系统指明了一条有前景的道路,这些系统能够从自然出现的演示中学习执行任务。
1. Introduction
基于已有的预训练+微调范式,本文更进一步:仅使用预训练,无需任何模型参数或者架构的修改(zero-shot setting),语言模型即可在多种下游任务上取得与已有无监督方法取得的 SOTA 相当或者新的 SOTA。
2. Approach
语言建模任务是一个无监督学习任务,可以视作基于数据集 \(D = \{x^{(1)}, x^{(2)}, \dots, x^{(N)}\}\),其中每个样本 \(x = (s_1, s_2, \dots, s_T)\) 是一个长度为 \(T\) 的符号序列(token 序列)。建立语言模型建模其条件概率:
\[ p(x) = \prod_{t=1}^T p(s_t \mid s_1, \dots, s_{t-1}) \tag{1} \] 仅使用 next token 作为预训练 loss 的 Motivation:
- 任务条件化:单任务为 \(p(\text{output}|\text{input})\),通用系统应建模
\(p(\text{output}|\text{input},
\text{task})\)。语言可将任务、输入、输出统一为符号序列,如
(translate to french, english text, french text)。 - 无监督即隐式多任务:LM 无需显式指定输出符号。无监督目标与有监督目标相同,仅评估子集不同,故 无监督全局最小 = 有监督全局最小。问题变为能否优化到收敛。大模型可在此设定下多任务学习,但学习速度比显式监督慢。
- 突破对话限制:对话交互过于受限。互联网有海量被动数据。推测:容量足够的 LM 为更好预测下一 token,会学会推断并执行序列中的任务,即无监督多任务学习。
2.1 Training Dataset
使用已有的网络爬取数据集,如:Common Crawl,因为数据集质量问题,预训练效果并不好。
OpenAI 重新爬取数据创建一个新的数据集:
- 爬取规则:
- 质量优先:只抓取经过人工筛选/策展(curated/filtered by humans)的网页(强调文档质量)。
- Reddit 外链启发式:爬取 Reddit 上至少获得 3 个 karma(可以理解为:赞减去踩数量) 的所有外链。karma 作为启发式指标,表示其他用户认为该链接有趣、有教育意义或好笑。
- 文本提取:结合 Dragnet 和 Newspaper1 内容提取器从 HTML 中提取文本。
- 数据清洗与过滤:
- 去除重复数据并进行启发式清洗。
- 移除所有 Wikipedia 文档(避免作为常见数据源与测试评估任务重叠,导致分析复杂化)。
- 初步版本不包含 2017 年 12 月之后创建的链接。
- 数据规模:
- 初始抓取:4500 万个链接。
- 最终版本(初步):清洗去重后包含略超过 800 万篇文档,总计 40 GB 文本。
2.2 Input Representation
- 目标:通用 LM 应能计算并生成任意字符串的概率。
- 现有问题:大规模 LM 常做小写化、分词、OOV(out-of-vocabulary) 处理,限制可建模字符串空间;纯字节级 LM 在大规模数据上不如词级 LM。
- BPE 折中:
- 在字符级和词级之间插值:频繁序列用词级,不频繁序列用字符级。
- 但参考 BPE 实现常基于 Unicode 码点,基础词表 > 130,000,远大于常用 32k–64k,过大。
- GPT-2 方案:Byte-level BPE:
- 基础词表仅 256。
- 直接对字节序列做 BPE 会产生次优合并:常见词变体(dog.、dog!、dog?)占用大量词表槽,浪费容量。
- 解决:阻止 BPE 跨字符类别合并;空格例外,显著提升压缩效率,仅带来最小词碎片化。
- 优势:
- 结合词级 LM 的经验收益与字节级通用性。
- 可为任意 Unicode 字符串分配概率。
- 可在任意数据集上评估,不受预处理、分词、词表大小限制。
2.3 Model
Decoder-only Transformer 架构。与 GPT-1 类似,但是做了少量修改:
- LayerNorm 由 Post-Norm 变成 Pre-Norm。
- 最后一层 LM Head 前加了 LayerNorm。
- 预训练 seq len:1024。
- 词表大小:50,257。
模型架构具体取值: 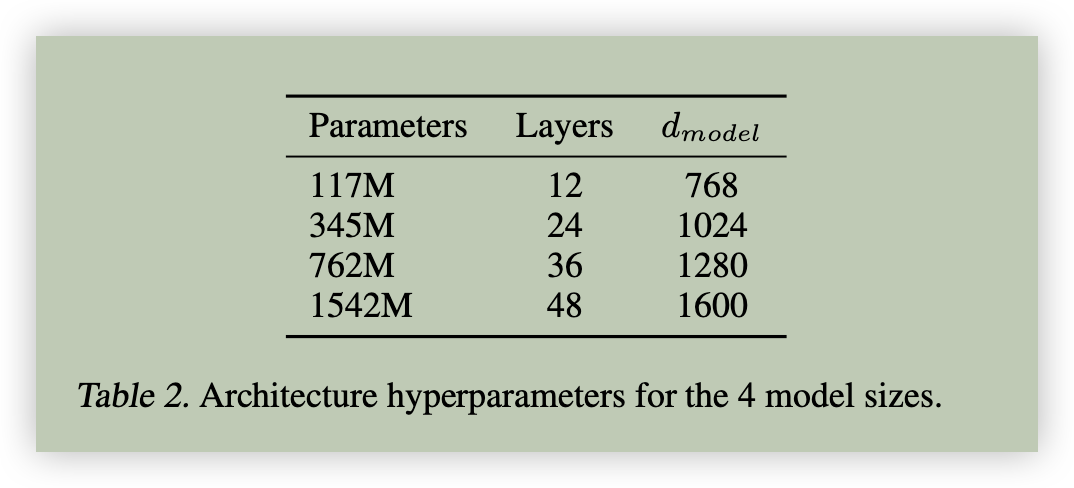
实验等后续内容略。