GPT-3: Language Models are Few-Shot Learners
- Language Models are Few-Shot Learners
- arXiv 提交日期:28 May 2020
- OpenAI blog:Language models are few-shot learners
- 作者:
摘要:
近期工作表明,通过在大规模文本语料上预训练,再针对特定任务进行微调,可以在许多 NLP 任务和基准上取得显著提升。虽然这种方法在架构上通常与任务无关,但仍需要数千或数万个样本的任务特定微调数据集。相比之下,人类通常只需几个示例或简单指令就能完成一项新的语言任务——而当前 NLP 系统在很大程度上仍难以做到这一点。在此,我们表明,扩大语言模型规模能极大提升任务无关的少样本性能,有时甚至能达到与先前最先进微调方法相竞争的水平。具体来说,我们训练了 GPT-3,一个拥有 1750 亿(175 B)参数的自回归语言模型,其参数量比以往任何非稀疏语言模型多 10 倍,并测试其在少样本设置下的性能。对于所有任务,GPT-3 均在没有任何梯度更新或微调的情况下应用,任务和少样本演示纯粹通过与模型的文本交互来指定。GPT-3 在许多 NLP 数据集上取得了强劲性能,包括翻译、问答和完形填空任务,以及一些需要即时推理或领域适应的任务,例如打乱单词、在句子中使用新词或进行三位数算术。同时,我们也发现了一些 GPT-3 少样本学习仍然困难的 dataset,以及一些 GPT-3 因在大规模网络语料上训练而面临方法论问题的数据集。最后,我们发现 GPT-3 能够生成人类评估者难以与人类撰写文章区分开的新闻文章样本。我们讨论了这一发现以及 GPT-3 更广泛的社会影响。
1. Introduction
背景
- NLP 趋势:预训练 + 微调,架构任务无关,但仍需每个任务数千到数十万标注样本。
- 人类只需少量示例或自然语言指令即可完成新任务。
问题
- 每个新任务都需要大量标注数据,限制适用性。
- 模型越大,越容易利用训练数据中的虚假相关性,泛化差。
- 人类不需要大规模监督数据集,现有 NLP 系统缺乏这种灵活性。
方法:上下文学习 / 元学习
- 模型在预训练中发展广泛技能,推理时通过上下文快速适应任务。
- 不更新参数,仅通过自然语言指令和少量演示指定任务。
- GPT-3:1750 亿参数自回归语言模型。
- 评估三种设置:零样本、单样本、少样本(10~100 个示例)。
关键结果
- 少样本有时与微调 SOTA 竞争甚至超越。
- CoQA:零样本 81.5 F1,单样本 84.0,少样本 85.0。
- TriviaQA:零样本 64.3%,单样本 68.0%,少样本 71.2%(闭卷 SOTA)。
- 能完成即时推理任务:打乱单词、算术、新词造句。
- 能生成人类难以区分的新闻文章。
- 部分任务仍困难:ANLI、RACE、QuAC。
- 性能随模型规模平滑提升,少样本增益更大。
数据污染
- 系统研究训练集与测试集重叠。
- 多数数据集影响小,少数需标注或剔除。
模型规模对比
- 训练 8 个模型,125M ~ 175B。
- 零/一/少样本性能随规模平滑提升,差距随规模扩大。
结论
- 大规模语言模型在少样本/零样本下表现强劲,是通用语言系统的重要方向。
2. Approach
整体预训练方法采用的模型、数据集、训练策略与 GPT-2 类似,但是扩展了模型规模、数据集规模与多样性、序列训练长度(2048)。
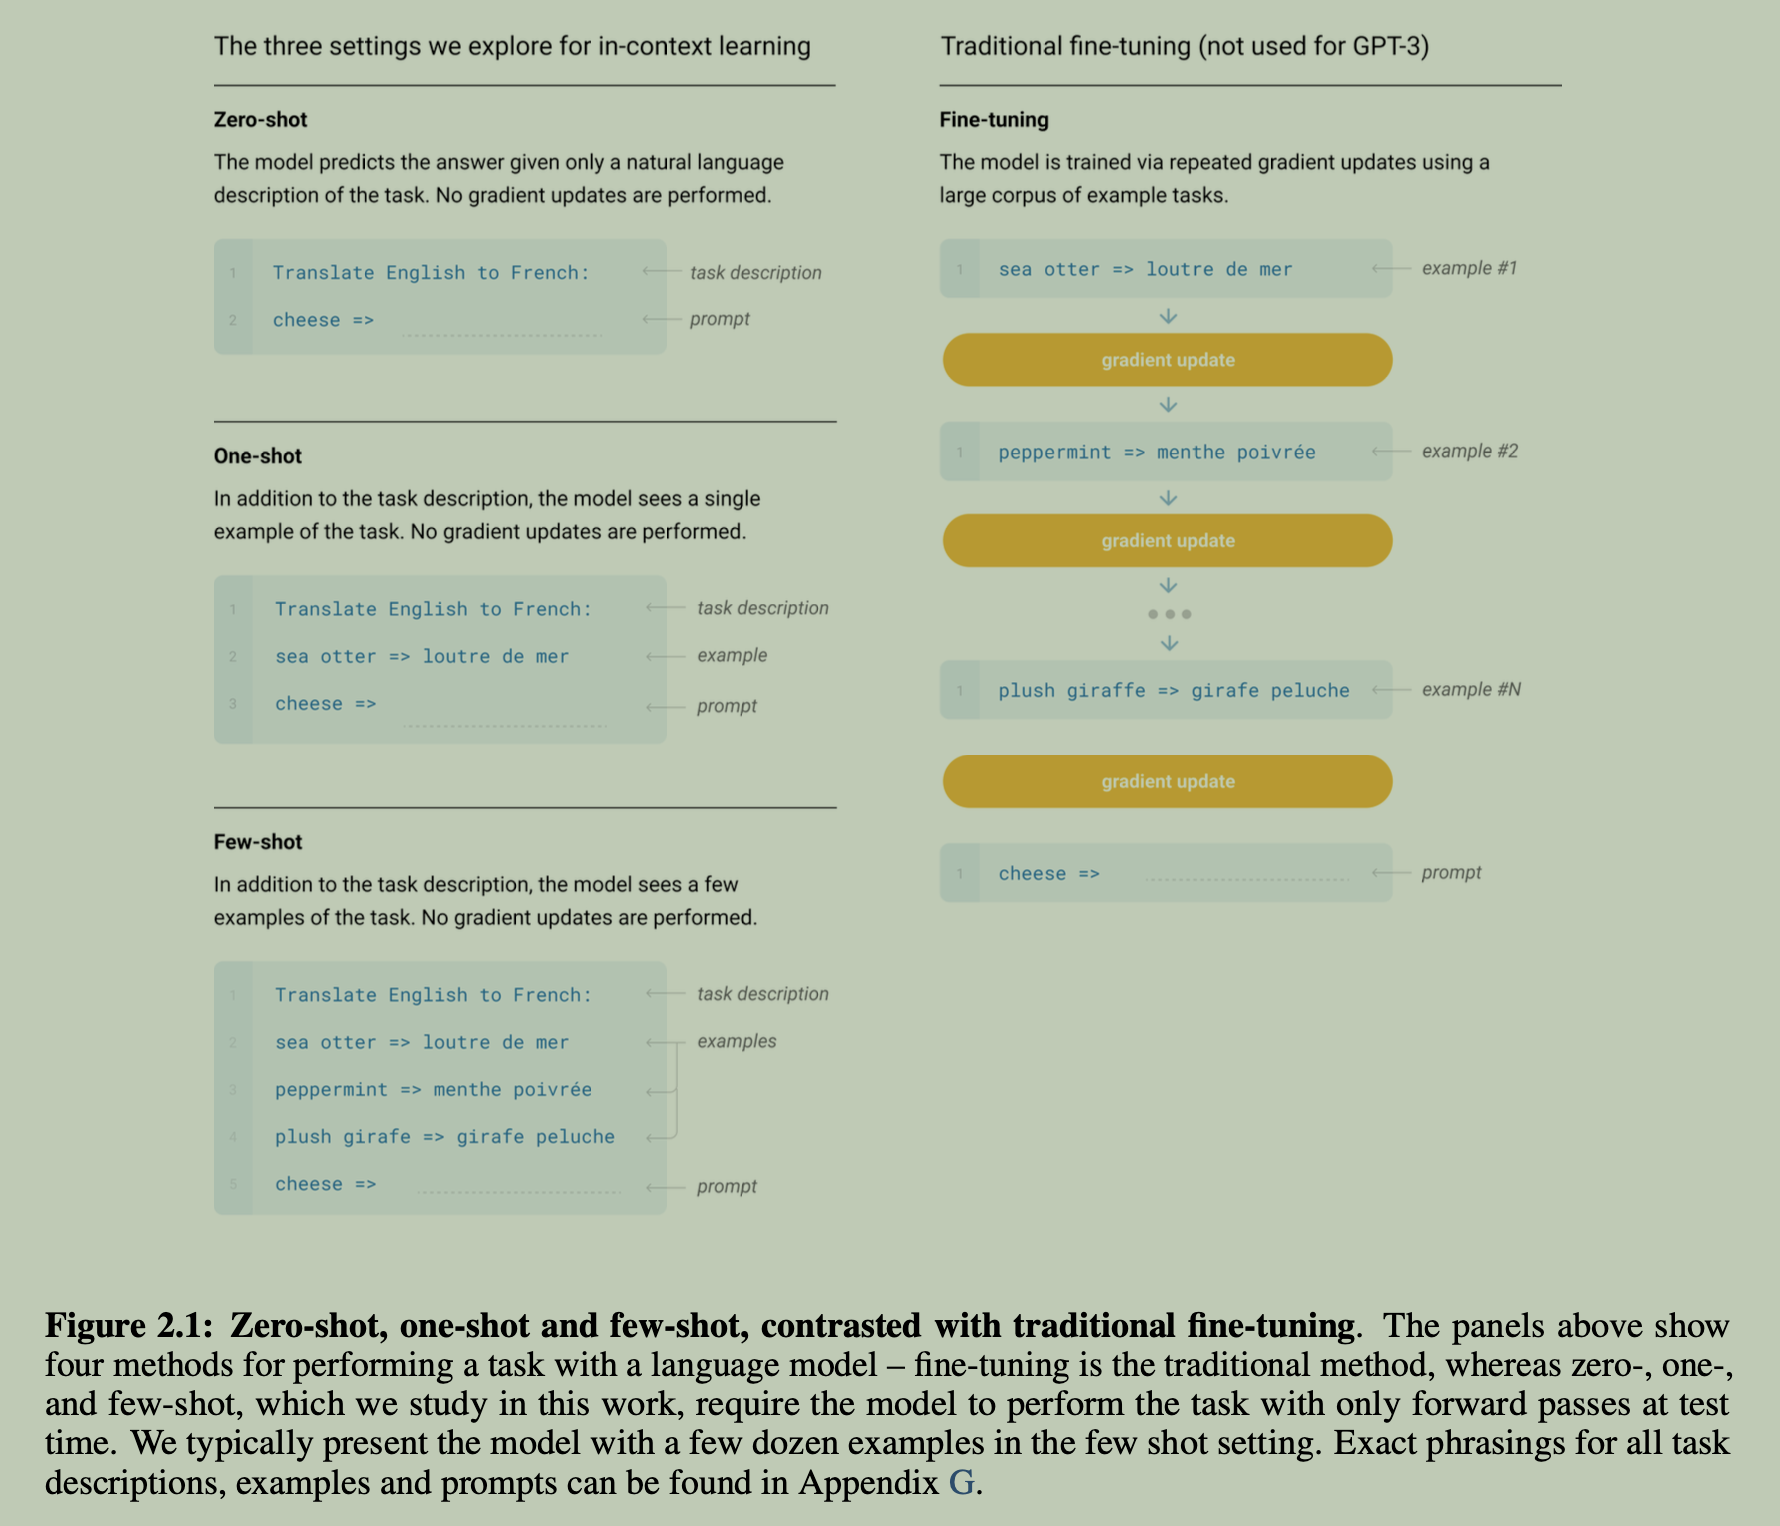
上下文学习的三种设置(zero-shot, one-shot,
few-shot)示例如上图所示。
- Fine- Tuning(FT):在特定任务有标签数据上对预训练好的模型进行微调。
- 优点:性能更好。
- 缺点:不同任务需要不同标注数据集;OOD 泛化性差。
- Few-Shot(FS):在推理时,模型被给予该任务的少量演示作为条件,但不允许进行权重更新。如上图左侧下方所示,在
prompts 中增加了几个翻译示例。
- 优点:对特定任务标注需求大幅下降。
- 缺点:迄今为止该方法的结果远差于最先进的微调模型。
- One-Shot(1S):类似 Few-Shot,但是只有一个 example 在推理时添加到 prompts。
- Zero-Shot(0S):推理时仅向模型提供任务描述的自然语言,不提供示例。
2.1 Model and Architectures
GPT-3 模型结构整体与 GPT-2 基本相同,不同之处在于:在 Transformer 各层中使用了交替的稠密和局部带状稀疏注意力模式(dense and locally banded sparse attention patterns)。
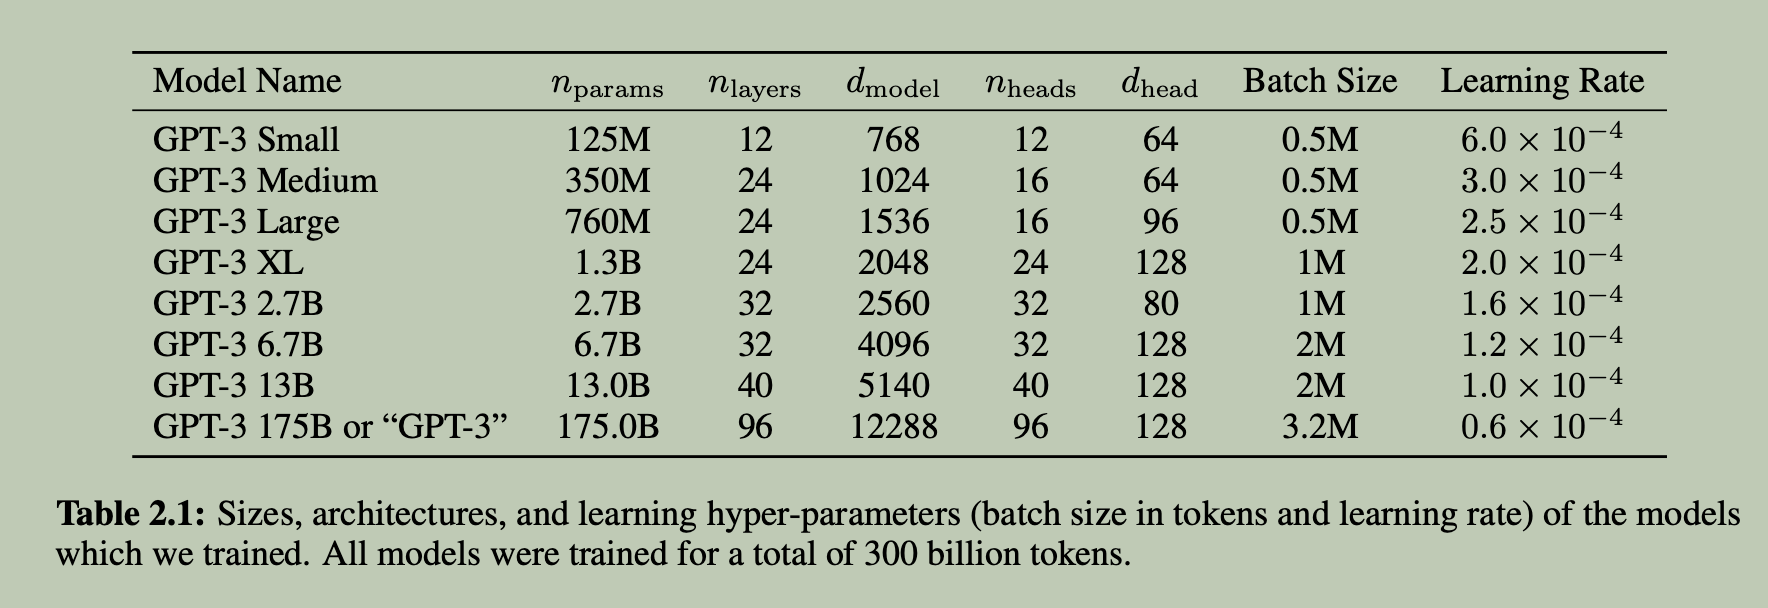
模型规模:
训练 Infra:
We partition the model across GPUs along both the depth and width dimension in order to minimize data-transfer between nodes. The precise architectural parameters for each model are chosen based on computational efficiency and load-balancing in the layout of models across GPU’s.
即: TP/PP,以通信最小的方式进行模型参数划分。
2.2 Training Dataset
基于 Common Crawl 数据集,并进行以下数据清洗流程:
- 基于与一系列高质量参考语料的相似性,对 Common Crawl 数据集进行过滤。
- 在文档级别进行了模糊去重,在数据集内部和跨数据集进行,以防止冗余并保持留出验证集的完整性,作为过拟合的准确度量。
- 将已知的高质量参考语料添加到训练混合中,以扩充 CommonCrawl 并增加其多样性。
训练数据集具体信息:
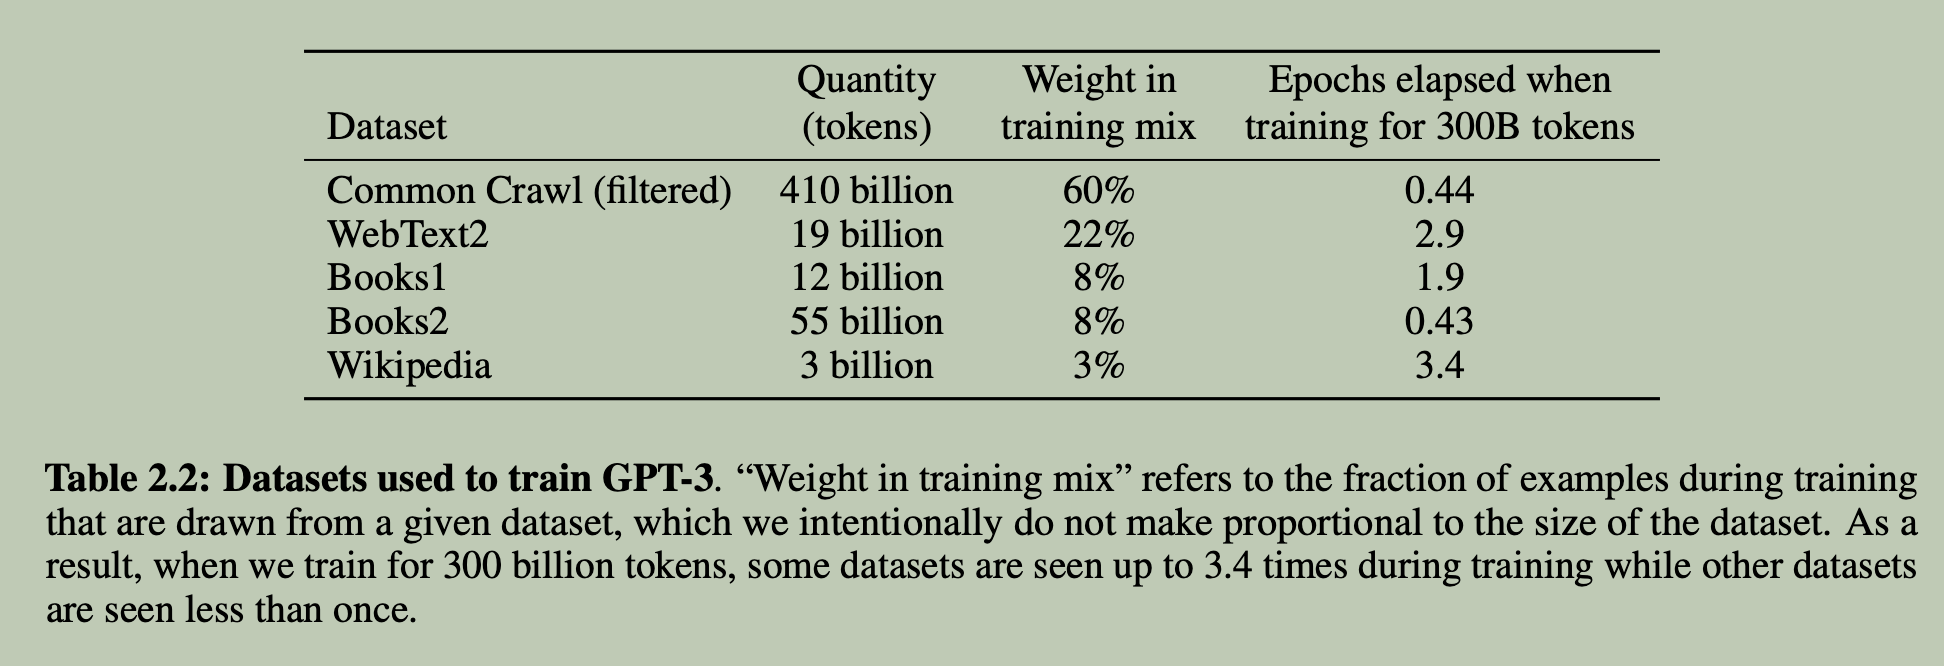
- Common Crawl 数据
- 原始大小:45TB
- 过滤后大小:570GB,约 400B tokens
- 训练数据不按子数据集大小采样,而是按数据质量采样。
2.3 Training Process
正如之前工作所发现的,更大的模型通常可以使用更大的批量大小,但需要更小的学习率。我们在训练期间测量梯度噪声尺度(gradient noise scale),并用它来指导我们选择批量大小。为了在训练更大模型时不耗尽内存,我们使用了矩阵乘法内部的模型并行与网络层之间的模型并行相结合的方式。所有模型都在 Microsoft 提供的高带宽集群的一部分上使用 V100 GPU 进行训练。训练过程和超参数设置的细节见附录 B。
附录 B:
为了训练所有版本的 GPT-3,我们使用 Adam 优化器,参数为 β1 = 0.9、β2 = 0.95、ε = 10⁻⁸;我们将梯度的全局范数裁剪到 1.0;并在 260B tokens 上使用余弦衰减将学习率降至其值的 10%(260B token 之后,训练继续以原始学习率的 10% 进行)。在最初的 3.75 亿 token 上进行线性学习率预热。我们还在训练的前 40 亿到 120 亿 token 内,根据模型规模将批量大小从小值(32k token)线性逐渐增加到完整值。训练期间数据采样无放回(直到达到一个 epoch 边界),以最小化过拟合。所有模型使用 0.1 的权重衰减,以提供少量正则化。
在训练期间,我们始终在完整的 n_ctx = 2048 token 上下文窗口的序列上进行训练;当文档短于 2048 时,将多个文档打包进单个序列,以提高计算效率。包含多个文档的序列不会以任何特殊方式进行掩码,而是用特殊的文本结束 token 分隔序列内的文档,从而给语言模型提供必要信息,使其推断出由文本结束 token 分隔的上下文是不相关的。这允许高效训练,而不需要任何特殊的序列特定掩码。
2.4 Evaluation
- Few-Shot:从任务训练集随机抽 K 个示例作为条件。
- K 值:0 到上下文窗口最大值(2048),通常容纳 10-100 个示例。较大 K 通常更好,dev 上试几个 K,选最佳用于 test。
- 多项选择:给 K 个 context+正确 completion,再给一个 context only,比较 LM likelihood。多数用 per-token likelihood;ARC、OpenBookQA、RACE 用无条件概率归一化:P(completion|context)/P(completion|answer_context),answer_context 为 "Answer: " 或 "A: "。
- 二分类:选项用语义名(True/False),当多项选择处理。
- 自由形式:beam search(beam width=4,length penalty α=0.6);用 F1、BLEU 或 exact match 评分。
- 结果报告:公开测试集报告 test;私有或模型太大时报告 dev。少数提交 test(SuperGLUE、TriviaQA、PiQA),只提交 200B few-shot 结果,其他报告 dev。
实验等其他内容略。
3. GPT-1 到 GPT~3 发展路线总结
| 项目 | GPT-1 | GPT-2 | GPT-3 |
|---|---|---|---|
| 发布时间 | 2018年6月11日 | 2019年2月14日 | 2020年5月28日 |
| 论文标题 | Improving Language Understanding by Generative Pre-Training | Language Models are Unsupervised Multitask Learners | Language Models are Few-Shot Learners |
| 最大模型规模 | 1.17 亿参数 | 15 亿参数 | 1750 亿参数 |
| 模型规模范围 | 单一规模 | 117M / 345M / 762M / 1542M | 125M / 350M / 760M / 1.3B / 2.7B / 6.7B / 13B / 175B |
| 层数(最大) | 12 | 48 | 96 |
| d_model(最大) | 768 | 1600 | 12288 |
| 注意力头数(最大) | 12 | 25 | 96 |
| 上下文长度 | 512 | 1024 | 2048 |
| 词表大小 | 40,000 BPE merges | 50,257 | 50,257(继承 GPT-2) |
| 位置编码 | 可学习位置嵌入 | 可学习位置嵌入 | 可学习位置嵌入 |
| 激活函数 | GELU | GELU(tanh 近似) | GELU |
| 架构改进 | Decoder-only Transformer,Post-LN | Pre-LN,final LN,残差权重 1/√N 初始化 | 交替稠密与局部带状稀疏注意力 |
| 预训练数据 | BooksCorpus,约 5GB | WebText,40GB,800 万文档 | Common Crawl(过滤后 570GB,约 400B tokens)+ WebText + Books1 + Books2 + Wikipedia |
| 数据清洗 | 未特别强调 | Reddit 外链 ≥3 karma,去重,移除 Wikipedia | 分类器过滤 Common Crawl,模糊去重,混合高质量语料 |
| 输入表示 | BPE,40k merges | Byte-level BPE,基础词表 256,无 OOV | 继承 GPT-2 的 Byte-level BPE |
| 训练目标 | 自回归 next-token prediction | 自回归 next-token prediction | 自回归 next-token prediction |
| 训练硬件/并行 | 8×P600 GPU,30 天 | 未详细说明 | V100 GPU 集群,TP + PP + DP 混合并行 |
| 训练计算量 | 约 0.96 pfs-days | 未明确,但远小于 GPT-3 | 约 3640 pfs-days(175B 模型) |
| 优化器 | Adam | Adam | Adam(β1=0.9, β2=0.95, ε=1e-8) |
| 学习率策略 | 未详细说明 | 手动调参 | 线性 warmup 3.75 亿 token,余弦衰减至 10% |
| 批量大小策略 | 未详细说明 | 未详细说明 | 从 32k token 线性增长至完整值(前 4-12B token) |
| 权重衰减 | 未提及 | 未提及 | 0.1 |
| 微调/评估范式 | 预训练 + 判别式微调 | 零样本(Zero-shot),无微调 | 零样本 / 单样本 / 少样本,无梯度更新 |
| 任务适配方式 | 任务感知输入变换 + 线性输出层 | 自然语言提示(Prompt) | 自然语言指令 + 少量演示(In-context Learning) |
| 关键贡献 | 确立“生成式预训练 + 判别式微调”范式;首个 decoder-only 预训练模型 | 证明零样本多任务学习可行;规模扩展带来能力提升;Byte-level BPE | 证明少样本/上下文学习能力;175B 规模;训练系统工程(TP+PP+DP);数据污染分析 |
| 主要局限 | 仍需为每个任务微调,需标注数据 | 零样本性能有限,未微调 | 部分任务仍困难(ANLI、RACE、QuAC);推理成本高;数据污染风险 |