GPT-1: Improving Language Understanding by Generative Pre-Training
- Improving Language Understanding by Generative Pre-Training
- OpenAI Technical Report,blog 链接:Improving
language understanding with unsupervised learning ,发布日期:June
11, 2018(Transformer paper 发布后的一年,即:12 Jun 2017 -> June 11,
2018)
- OpenAI milestone 页面:Research milestone
- 作者:
摘要:
自然语言理解涵盖广泛而多样的任务,例如文本蕴含(textual entailment)、问答(question answering)、语义相似度评估(semantic similarity assessment)和文档分类(document classification)。尽管大规模未标注文本语料库非常丰富,但用于学习这些特定任务的标注数据却很稀缺,这使得判别式训练的模型难以充分表现。我们证明,通过在多样化的未标注文本语料上对语言模型进行生成式预训练(generative pre-training),再针对每个特定任务进行判别式微调(discriminative fine-tuning),可以在这些任务上取得巨大提升。与以往方法不同,我们在微调期间利用任务感知的输入变换来实现有效迁移,同时只需对模型架构做最小改动。我们在广泛的自然语言理解基准上证明了该方法的有效性。我们的通用、任务无关模型优于那些使用为每个任务专门设计的架构的判别式训练模型,在研究的 12 项任务中的 9 项上显著提升了最先进水平。例如,我们在常识推理(Stories Cloze Test)上实现了 8.9% 的绝对提升,在问答(RACE)上实现了 5.7%,在文本蕴含(MultiNLI)上实现了 1.5%。
GPT-1 主要贡献:
- 首先使用了 decoder-only 的模型架构。
- 证明了无监督预训练+微调范式的可行性,并在多个数据集上接近或者实现新的 SOTA。
1. Introduction
深度学习模型依赖有标签的数据集进行监督学习,以完成各种 NLP 任务。但是,标签数据数量稀少,且标签成本高昂,因此,社区在探索使用无标签的大规模语料数据集的方法,以减少对标签的依赖。一般范式是:先使用大规模无标签数据进行预训练;然后基于预训练的模型在特定任务上进行微调。这一范式已经被广泛证明了有效性,比如:word2vec 等。
但是,如何从无标签数据中进行学习,以利用其中的世界信息(word-level information)还是一个具有挑战性的问题,原因如下:
- First, it is unclear what type of optimization objectives are most effective at learning text representations that are useful for transfer. (如何预训练)
- Second, there is no consensus on the most effective way to transfer these learned representations to the target task.(如何迁移)
本文提出的方法:
- 使用 Transformer 模型。
- 首先在无标签数据集上进行预训练。
- 基于预训练的模型参数与 backbone,在有标签数据集上进行微调。
2. Framework
训练过程分为两个阶段:
- 第一阶段是在大规模文本语料上学习一个高容量语言模型。
- 微调阶段:使用标注数据将模型适配到一个判别式任务。
2.1 Unsupervised pre-training
数据集与损失函数
无监督语料:\(U = \{u_1, \dots, u_n\}\)。GPT-1 实验中预训练数据为 BooksCorpus,约 5GB,包含 7000 多本未出版书籍。
训练目标:使用标准语言建模目标,最大化以下似然: \[L_1(U) = \sum_i \log P(u_i \mid u_{i-k}, \dots, u_{i-1}; \Theta) \tag{1}\]
其中 \(k\) 是上下文窗口大小,条件概率 \(P\) 由参数为 \(\Theta\) 的神经网络建模。
解释:本质是自回归 next-token prediction(对应论文标题的:生成式预训练),即给定左侧 \(k\) 个 token,预测下一个 token。等价于最小化交叉熵损失。由于使用因果掩码,每个位置只能看到左侧上下文,不能看到未来 token。
模型结构
使用多层 Transformer 解码器(decoder-only)。
前向传播: \[ \begin{aligned} h_0 &= U W_e + W_p \\ h_l &= \text{transformer\_block}(h_{l-1}), \quad \forall l \in [1, n] \\ P(u) &= \text{softmax}(h_n W_e^T) \end{aligned} \tag{2} \]
其中 \(U = (u_{-k}, \dots, u_{-1})\) 是上下文 token 向量,\(n\) 是层数,\(W_e\) 是 token 嵌入矩阵,\(W_p\) 是位置嵌入矩阵。
解释:
- 输入 token 先通过 token embedding 矩阵 \(W_e\) 得到嵌入,再加上 可学习 位置嵌入 \(W_p\),得到 \(h_0\)。
- \(h_0\) 依次经过 \(n\) 层 transformer block,每层包含多头自注意力和 FFN。
- 最后一层隐藏状态 \(h_n\) 与 token embedding 矩阵转置 \(W_e^T\) 相乘,得到词表 logits,再通过 softmax 得到下一个 token 的分布。
- 输出投影层与输入 token embedding 共享权重,减少参数量,并保持输入输出空间一致。
- 注意力使用因果掩码,保证 decoder-only 自回归性质。
2.2 Supervised fine-tuning
数据集与损失函数
- 有监督数据集:\(C\),每个实例由输入 token 序列 \(x_1, \dots, x_m\) 和标签 \(y\) 组成。
- 输入序列经过预训练模型,取最后一个 transformer block 的激活 \(h_l^m\),送入新增的线性输出层 \(W_y\) 预测标签: \[P(y \mid x_1, \dots, x_m) = \text{softmax}(h_l^m W_y) \tag{3}\]
- 微调目标:在预训练模型之上,最大化以下似然: \[L_2(C) = \sum_{(x,y)} \log P(y \mid x_1, \dots, x_m) \tag{4}\]
- 额外发现:在微调时加入语言建模作为辅助目标有助于学习:
- 提高有监督模型的泛化能力;
- 加速收敛。
- 具体优化目标(权重 \(\lambda\)): \[L_3(C) = L_2(C) + \lambda * L_1(C) \tag{5}\] 其中 \(L_1(C)\) 是在有标签数据 \(C\) 的输入上计算的语言建模损失。
模型结构(微调阶段)
- 主干网络:复用无监督预训练好的多层 Transformer 解码器。
- 输出层:新增一个线性层 \(W_y\),将最后一层隐藏状态 \(h_m^l\) 映射到标签空间。
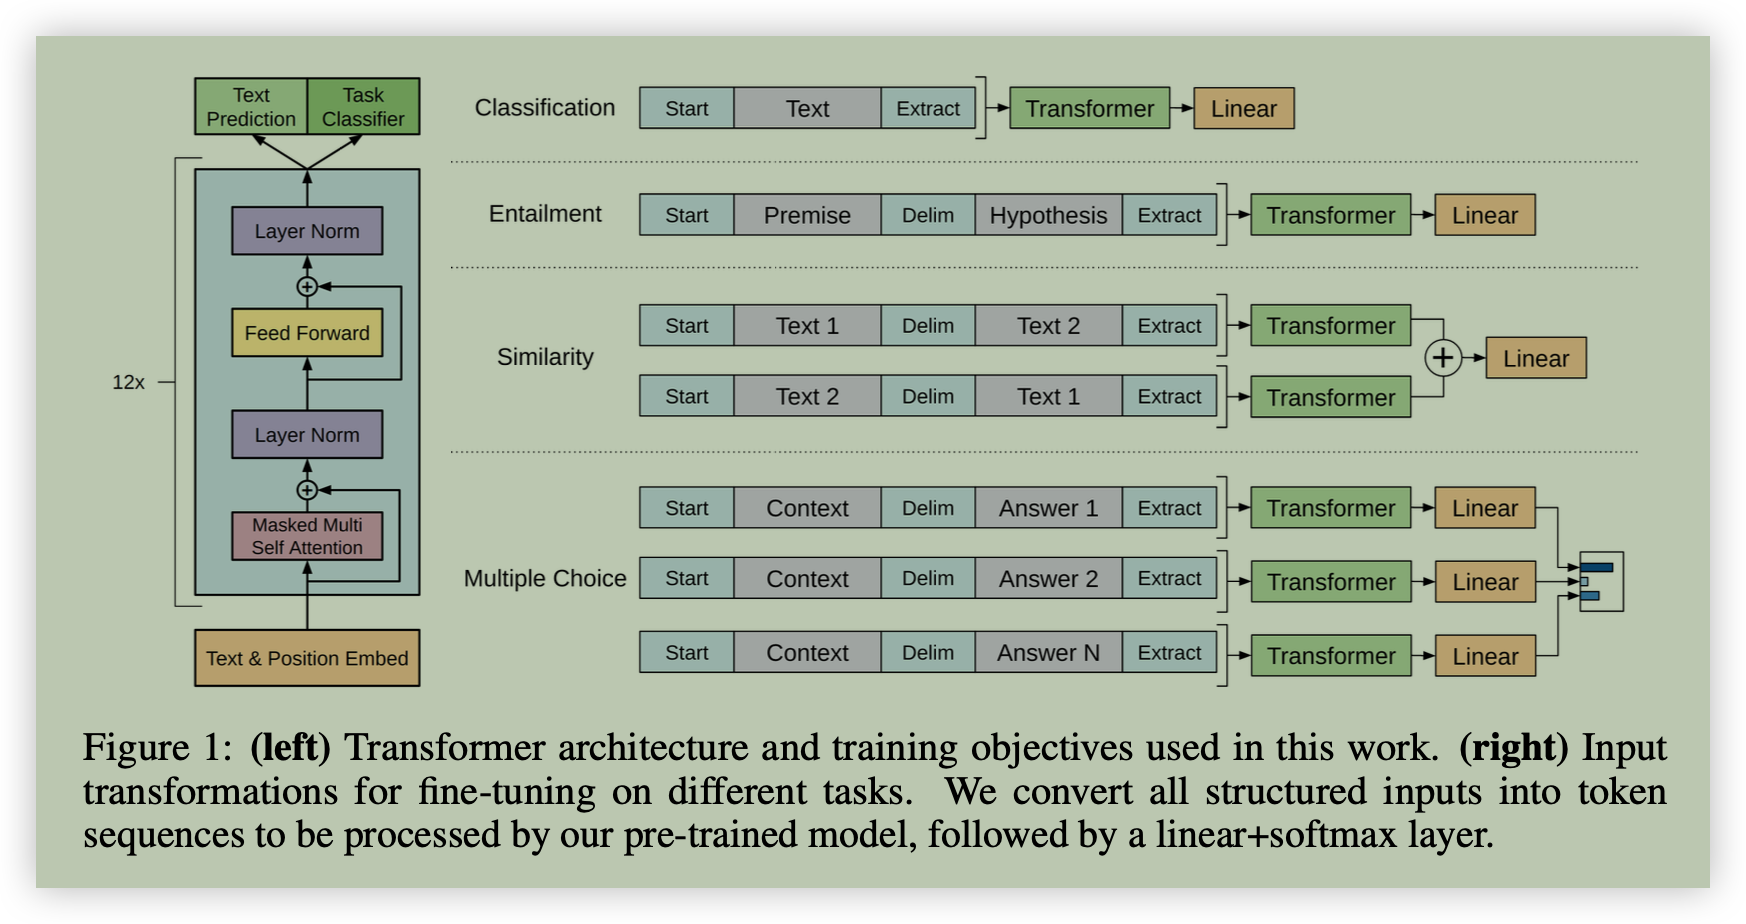
- 输入适配:通过任务感知的输入变换,将不同任务的输入组织成单个连续 token 序列,再送入模型。
额外参数
- 微调期间唯一新增的参数是:
- 输出线性层 \(W_y\);
- 分隔符 token 的嵌入(详见下面一小节)。
- 其余参数均来自预训练模型,微调时继续更新。
2.3 Task-specific input transformations
动机
- 对于文本分类等任务,可以直接按上述方式微调。
- 对于问答、文本蕴含等具有结构化输入的任务(如有序句子对,或文档、问题、答案三元组),由于预训练模型是在连续文本序列上训练的,需要一些修改才能应用。
- 先前工作提出在迁移表示之上学习任务特定架构,但这种方法重新引入了大量任务特定定制,且没有为这些额外架构组件利用迁移学习。
- 本文采用 traversal-style 方法,将结构化输入转换为预训练模型可以处理的有序序列。这些输入变换避免了对架构进行大量跨任务修改。
- 所有变换都包括添加随机初始化的 start 和 end token(\(\langle s \rangle\), \(\langle e \rangle\))。
具体任务变换
- 文本蕴含(Textual Entailment)
- 将前提 \(p\) 和假设 \(h\) 的 token 序列拼接,中间用分隔符 token
$隔开。 - 即构造序列:\(\langle s \rangle\)
... \(p\) ...
$... \(h\) ... \(\langle e \rangle\)。
- 将前提 \(p\) 和假设 \(h\) 的 token 序列拼接,中间用分隔符 token
- 相似性(Similarity)
- 两个被比较的句子没有固有顺序。
- 为反映这一点,修改输入序列以包含两种可能的句子顺序(中间用分隔符隔开),并分别独立处理,产生两个序列表示 \(h_l^m\)。
- 将这两个表示逐元素相加,然后送入线性输出层。
- 问答与常识推理(Question Answering and Commonsense
Reasoning)
- 给定上下文文档 \(z\)、问题 \(q\)、以及一组可能答案 \(\{a_k\}\)。
- 将文档上下文、问题与每个可能答案拼接,中间添加分隔符 token,得到 \([z; q; \$; a_k]\)。
- 每个序列都用模型独立处理,然后通过 softmax 层归一化,产生可能答案上的输出分布。
3. Experiments
3.1 Setup
预训练数据集:BooksCorpus,包括 7000 多本未出版书籍。
模型结构与训练细节:
- 12 层 decoder-only 架构
- \(d_{model} = 768\) ;\(h = 12\) (12 个 Attention Heads);\(d_{ffn} = 3072\)
- 使用 GLEU 激活函数和可学习位置编码
- Adam 优化器
- 预训练 sequence len 为 512
- 使用 bytepair encoding (BPE) vocabulary with 40,000 merges
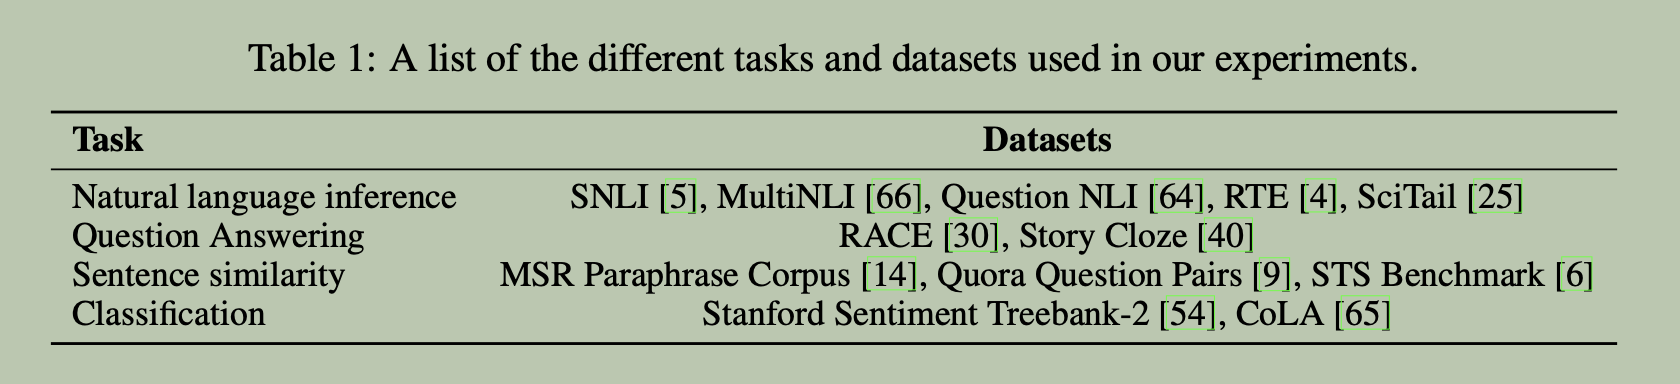
微调数据集
预训练 FLOPs
8 P600 GPU's * 30 days * 12 TFLOPS/GPU * 0.33 utilization == 0.96 pfs-days- 共需要
0.96 PFLOPs
实验结果与分析略。
4. Conclusion
GPT-1 主要贡献:
- Transformer decoder-only 模型结构。
- 证明了生成式预训练+判别式微调范式在多个 NLP 任务上的泛化性。