GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding
- GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding
- arXiv 提交日期:30 Jun 2020(发表于 ICLR 2021)
- 作者:
摘要
神经网络规模扩展(Scaling) 在拥有海量训练数据和计算资源的许多现实机器学习应用中,对提升模型质量起到了至关重要的作用。尽管扩大模型规模已被证实是提高模型质量的有效途径,但该路径上也面临着计算成本高、编程复杂度高以及在并行设备上的高效实现等挑战。在本文中,我们展示了条件计算(Conditional Computation)作为解决上述障碍的有效方案,并证明了其高效性与实用性。
我们深入使用了 GShard 模块——它由一组轻量级标注 API 和 XLA 编译器的扩展组成,能够支持参数量高达数万亿的大规模模型。借助 GShard 和条件计算,我们成功扩展了基于稀疏门控混合专家(Sparsely-Gated Mixture-of-Experts, MoE)的多语言神经机器翻译 Transformer 模型。实验表明,这样一个拥有 600B 参数的巨型模型可以在 2048 个 TPU v3 核心上高效训练,仅需 4 天即可完成,且在 100 种语言翻译至英语的任务上取得了远超现有技术的翻译质量。
1. Introduction
- 背景:老生常谈的模型规模越大各种机器学习任务上性能越好,但是随之带来了训练效率问题。
- 本文主要贡献:
- Conditional computation:使用稀疏 MoE 模型扩展模型参数量,限制计算量的增长。
- GShard Annotation:将模型 并行策略的实现和优化 与 描述模型结构本身 解耦,用户只需要在少量关键 tensor 上添加分片标注,XLA 编译器自动生成并行代码。
2. Model
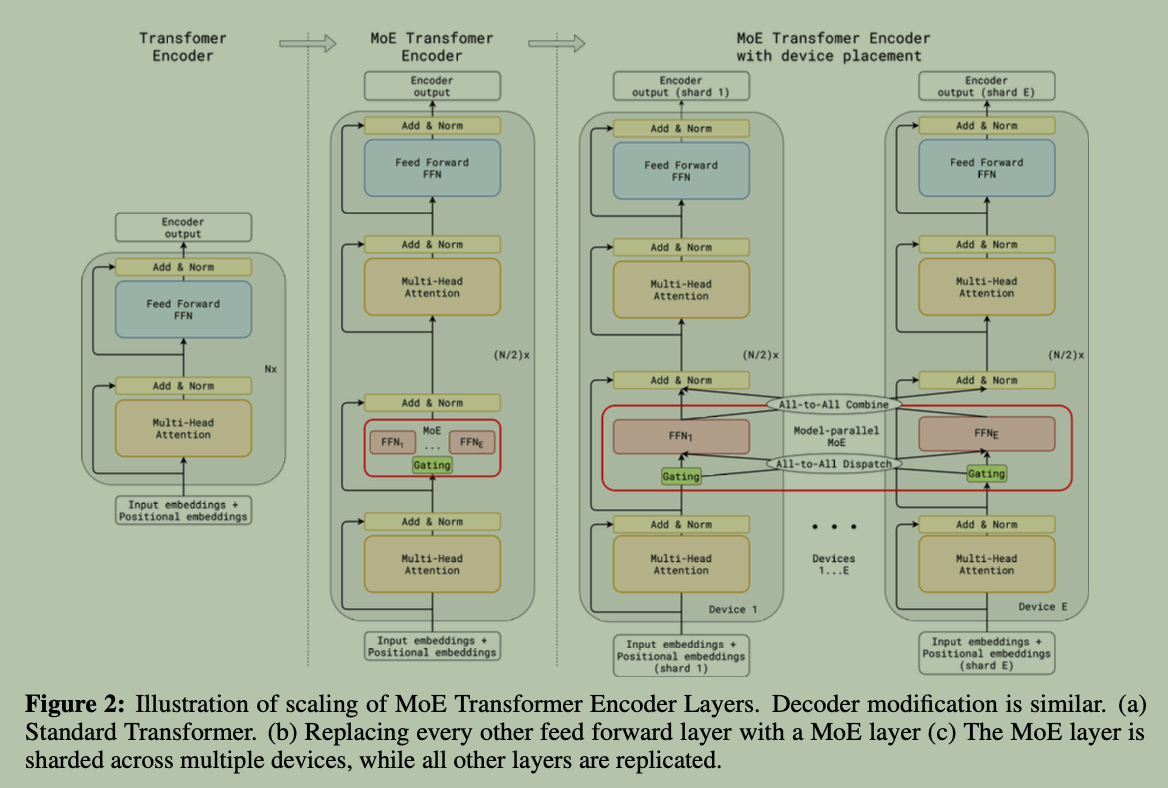
替换 Transformer 中的 FFN 为稀疏 MoE + Top-2 Gating。模型结构与并行策略如下图所示:
2.1 Position-wise Mixture of Experts Layer
Load balancing
- 问题:若仅简单按 Softmax 概率挑选 Top-2 专家,会导致大量 token 涌向少数热门专家,其他专家得不到充分训练。
- 解决方案:引入固定的专家容量(Expert Capacity, \(C\)) 作为硬性上限。对于批次内 \(N\) 个 token,每个专家的容量设为 \(C = O(N/E)\)。
- 溢出处理(Overflow Token):若选中专家的缓冲区已满,多余的 token 被标记为溢出(Overflow),其门控权重归零,直接通过残差连接(Residual Connection)传递到下一层。
Local dispatching for parallel gating
- 问题:传统的全局门控需要跨专家统计计数,导致门控计算变成串行操作,在 TPU 等依赖静态 Shape 的硬件上会导致数千加速卡挂起等待。
- 解决方案:将训练 Batch 内的 \(N\) 个 token 平均划分为 \(G\) 个局部组(Local Groups),每组包含 \(S = N/G\) 个 token。
- 并行加速:每个 Local Group 独立进行局部门控与分发,分配到的局部专家容量为 \(C = \frac{2N}{G \cdot E}\)。这种解耦设计将门控函数的计算速度提升了 \(O(G)\) 倍。
Auxiliary loss
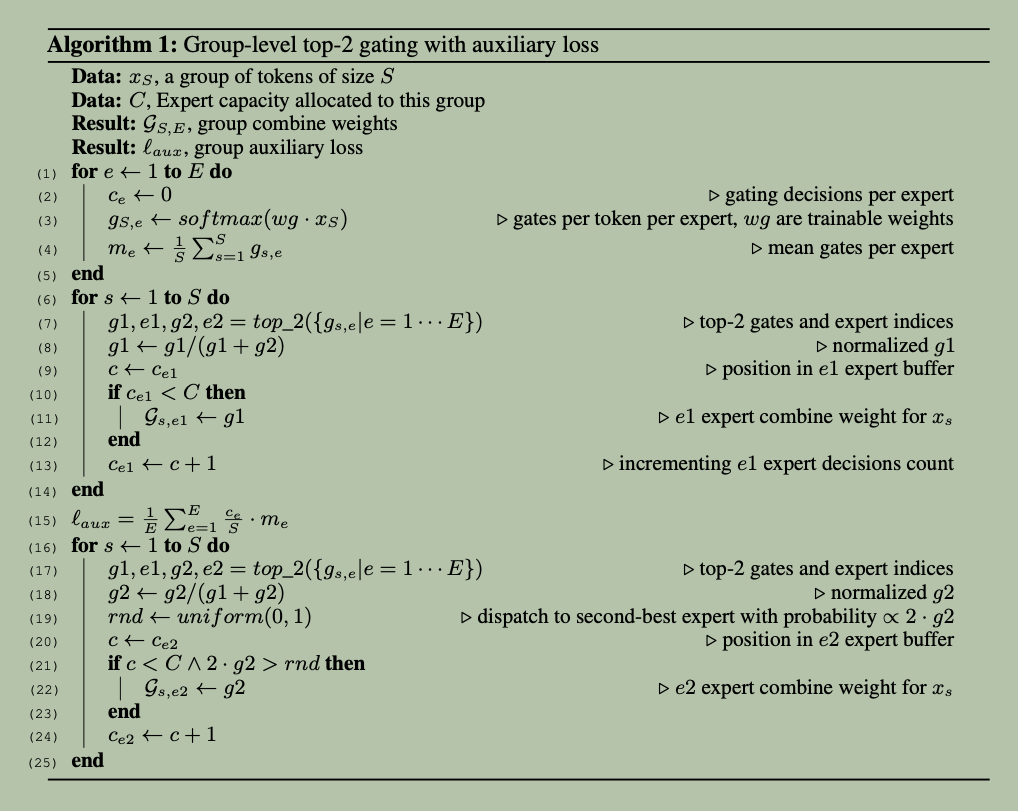
- 问题:早期的辅助损失使用不可微的离散计数项 \(\left(\frac{c_e}{S}\right)^2\),无法通过梯度下降直接优化门控网络参数 \(w_g\)。
- 解决方案:引入连续可微的平均分配概率 \(m_e = \frac{1}{S} \sum_{s=1}^S g_{s,e}\),将辅助损失重构为: \(\mathcal{L}_{aux} = \frac{1}{E} \sum_{e=1}^{E} \left( \frac{c_e}{S} \cdot m_e \right)\) 其中 \(\frac{c_e}{S}\) 是路由到专家 \(e\) 的真实 token 比例。该 Loss 能够通过梯度下降平滑地推动门控网络将 token 均匀分配给所有专家。
Random routing
- 机制:如果第 2 个专家的概率权重 \(g_2\) 非常小,强行分发会浪费宝贵的专家容量。
- 策略:GATE 函数以正比于 \(g_2\) 的概率随机决定是否将 token 分发给第 2 个专家。实验证明该机制大幅减少了溢出 token 并提升了模型的收敛精度。
2.2 Highly Parallel Implementation using GShard
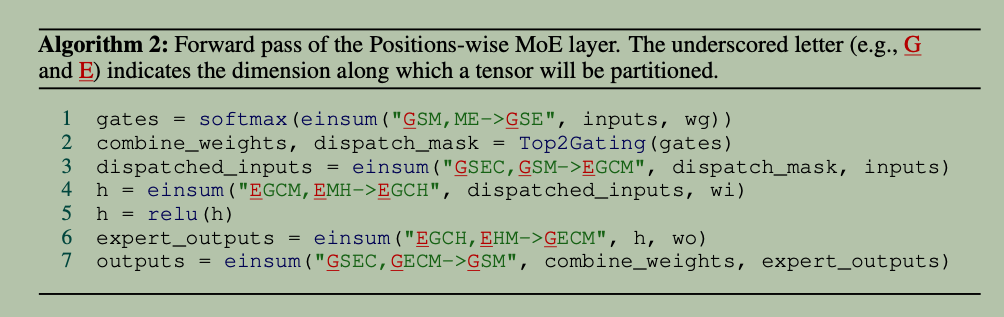
- 上述算法流程为:
- 算门控概率
- 生成 4D 掩码 [G,S,E,C]
- 按专家分发 Token
- 专家 FFN 第一层
- 专家 FFN 第二层
- 结果加权聚合
- 维度张量符号:
G为 Local Group 数,S为组内 Token 数,M为隐藏层维度,E为专家数,C为 Expert Capacity 缓冲区大小,H为 FFN 中间隐层维度。 - 本质:把动态路由转换成了
GSEC与GSM矩阵的内积(类似于用 One-hot 掩码做 Gather/Scatter),使得整个 MoE 层的计算彻底转化为高度固化的标准线性代数运算。
声明式标注 API
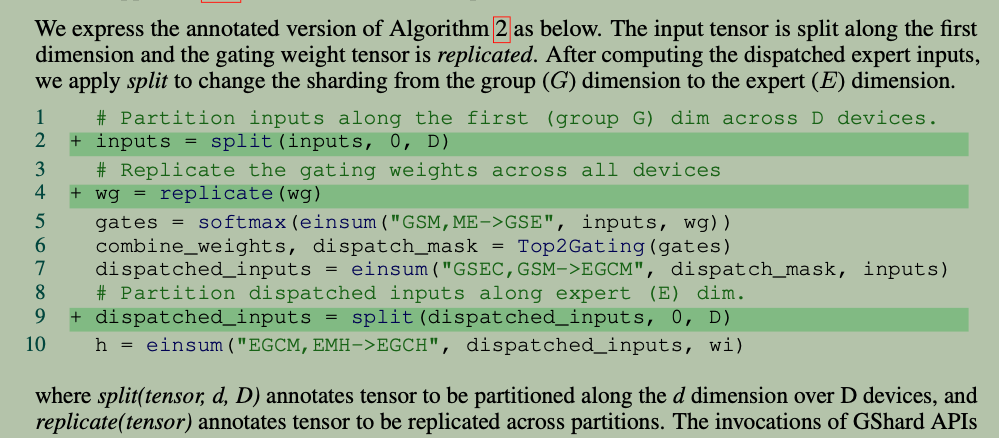
- split(tensor, d, D):声明将
tensor的第d个维度切分为D份(分布在D台设备上)。 - replicate(tensor):声明将
tensor在所有D台设备上完整复制(广播)一份。
只需要标注三行代码:
- 输入数据:
inputs = split(inputs, 0, D)(按 Group 维度G在D台设备上数据并行切分)。 - 门控参数:
wg = replicate(wg)(门控权重在所有卡间全量复制)。 - 专家输入:
dispatched_inputs = split(dispatched_inputs, 0, D)(将数据从按 Group 维度切分,切换为按 Expert 维度E切分)。
添加标注完全不会改变张量的逻辑 Shape。XLA 编译器通过迭代式数据流分析(Sharding Propagation),会自动推导全图中其他几百个中间张量和算子的切分策略,无需人工干预。
3. Conclusion
- TransformerBlock: FFN -> MoE
- GShared: EP(All2All)
GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding
https://arcsin2.cloud/posts/2026/10/4164788123/