Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM
- Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM
- arXiv 提交日期:9 Apr 2021
- 代码:Megatron-LM
- 作者:
摘要:
大语言模型在多项任务中均取得了当前最佳(SOTA)的准确率。然而,高效地训练这些模型面临着严峻挑战,原因在于: a) GPU 显存容量有限,甚至在单台多卡服务器上也无法容纳超大模型; b) 所需的计算量极其庞大,可能导致现实中不可接受的超长训练时间。
因此,研究者们提出了张量并行(Tensor Parallelism)和流水线并行(Pipeline Parallelism)等新型模型并行技术。遗憾的是,朴素地使用这些方法在扩展至数千张 GPU 规模时会出现严重的分散与扩展性瓶颈。
在本文中,我们展示了如何将张量并行、流水线并行与数据并行深度融合(即 3D 并行),以成功扩展至数千张 GPU。我们提出了一种创新的交错式流水线调度(Interleaved Pipelining Schedule),在显存占用与现有方法相当的前提下,将吞吐量提升了 10% 以上。
我们的方法使我们能够在 3072 张 GPU 上,以 502 PetaFLOP/s 的总计算吞吐量(单卡算力利用率达到理论峰值的 52%),成功对 1 万亿(1 Trillion)参数的大模型进行了训练迭代。
1. Introduction
模型规模呈指数增长:
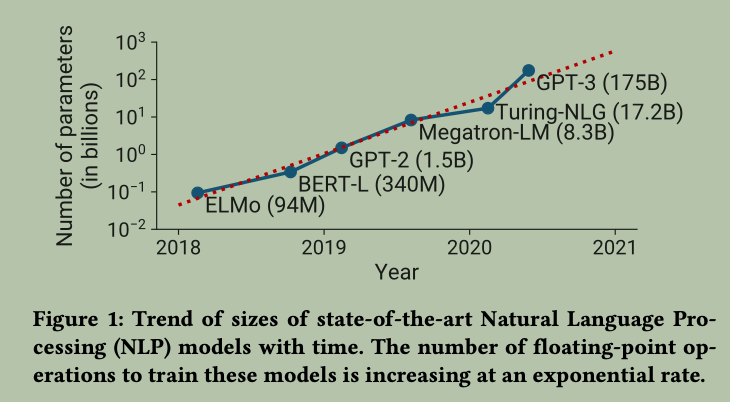
- 已有并行训练技术:DP/TP/PP
- 本文要解决的问题:在给定批次大小(Batch Size)且保持严格优化器语义的前提下,应该如何组合各种并行技术,以最大化大语言模型的训练吞吐量?即:如何同时利用 PP/TP/DP(3D Parallel)技术,以充分利用 GPU 计算能力训练大模型。
- 3D Parallel 设置原则:
- 机内 TP
- 机间 PP
- DP 扩展更多机器
- 工程实现
- 高效 kernel
- 设置 TP/PP 以减少通信(reduce the number of bytes sent over network links)
- 通信优化
- 硬件(GPU 与 机内/机间高速互联)
2. Modes of Parallelism
TP/PP 组合示意图:
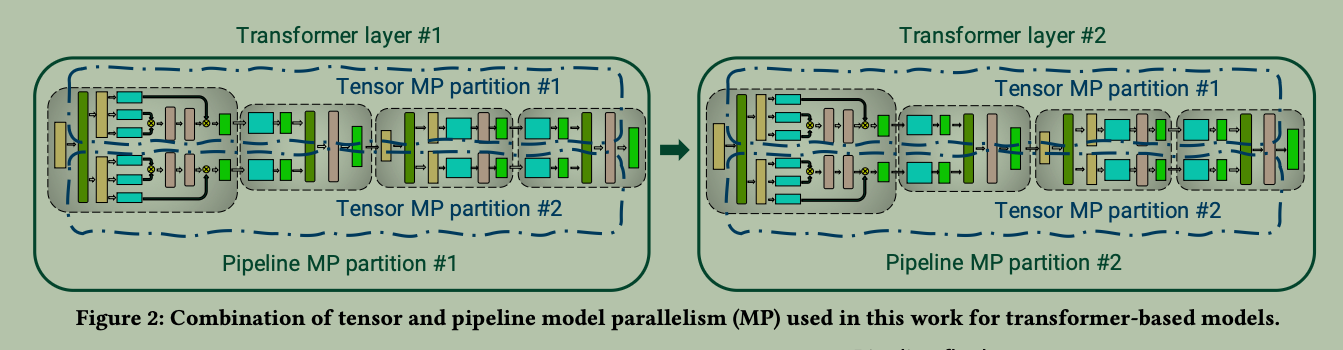
2.1 Data Parallelism
- PyTorch DDP
- 切分输入数据到不同 worker;
- backward 时对梯度进行 AllReduce 通信,以保证不同 replica 权重相同;
- 局限:要求模型可以放到一个 device;
2.2 Pipeline Model Parallelism
- PP
- 模型不同层切分到不同 device;
- 关键优化:
- mini-batch 切分为 micro-batches;
- micro-batches 流水线执行,以减少 bubble;
- gradient checkpointing:减少激活值内存占用;
实现 PP 的核心:如何调度 micro-batch 的 forward/backward?
2.2.1 Default Schedule: GPipe
- GPipe 调度策略
- 先完成所有 micro-batches 的 forward;然后再进行所有 micro-batches 的 backward。图示:
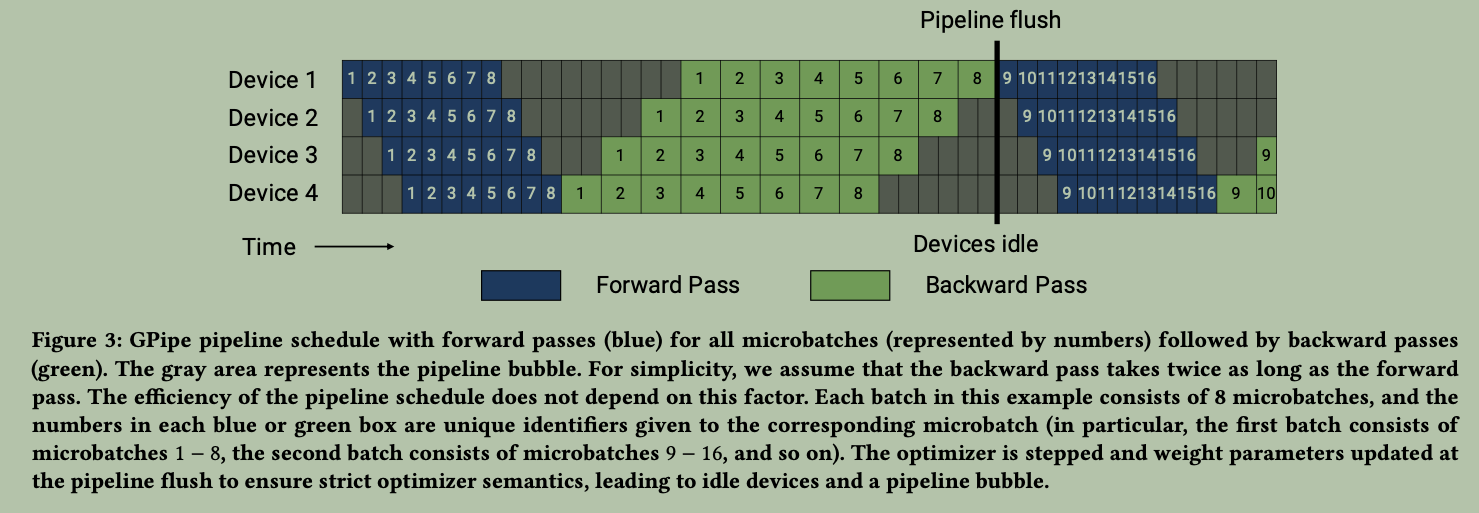
- pipeline bubble(\(t_{pb}\))
比例分析:
- micro-batch 大小为 \(m\) ;pipeline stage 数量为 \(p\) ;一个 micro-batch forward/backward 耗时分别为 \(t_f\) 和 \(t_b\) ;
- bubble 由 forward 时 \(p-1\) 个 stage 和 backward 时 \(p-1\) 个 stage 组成,总 bubble 耗时为 \(t_{pb} = \left( p-1 \right) \cdot \left( t_f + t_b \right)\) ;
- 处理 \(m\) 个 micro-batches 理想耗时为 \(t_{id} = m \cdot \left( t_f + t_b \right)\) ;
- 则 bubble 比例 为:\(\text{Bubble time fraction (pipeline bubble size)}
= \frac{t_{pb}}{t_{id}} = \frac{p-1}{m}\) ;
- 注意:分母为理想耗时而非实际耗时,与 GPipe paper 和课程 sldies 计算方式不同。
- micro-batch 数 \(m\) 越大,则 bubble 比例越低;但是内存占用随之升高。
GPipe 改进 -> PipeDream-Flush schedule
如下图上半部分所示:
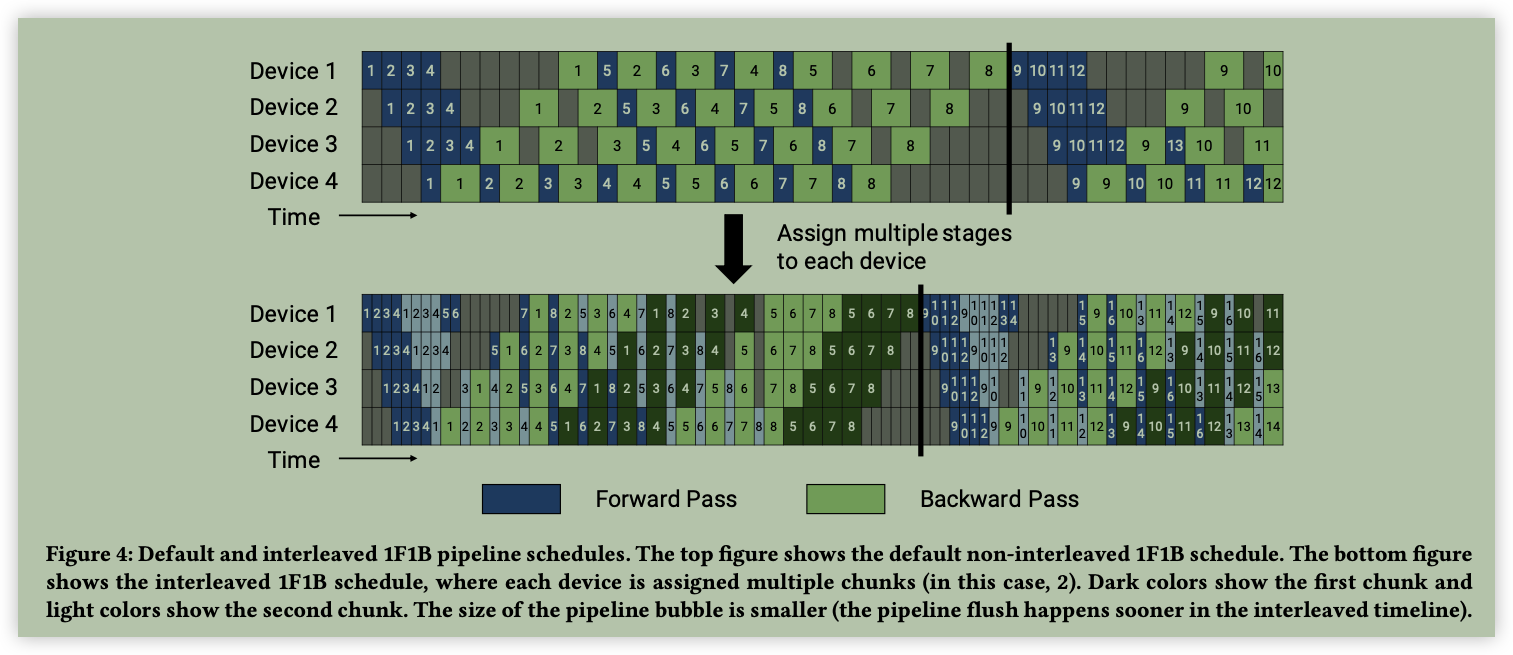
- 核心 Motivation:尽早开始 backward;
- 流水线进入稳定状态后,每个 worker 执行 1F1B;
- 激活值显存占用与 \(p\) 成正比,而不是 GPipe 的与 \(m\) 成正比,降低了峰值内存占用;
2.2.2 Schedule with Interleaved Stages
- 目的:减少 pipeline bubble 占比
- 方法:把模型层按 chunk(若干连续层) 切分,一个 device 不再放置连续的若干层;而是放置多个不连续的 chunk;
- forward/backward 调度如上图下半部分所示:
- 类似 1F1B 尽在开始 backward 以减少激活值峰值显存占用;
- 要求 micro-batches 数量 \(m\) 是 PP stage \(p\) 的整数倍;
- 气泡比例分析:
- 每个 device 有 \(v\) 个 stages (or model chunks);
- 每个 stage 完成一个 micro-batch 耗时变为 \(\frac{t_{f}}{v}\) 和 \(\frac{t_{b}}{v}\) ;
- Pipeline bubble 耗时变为:\(t_{pb}^{int.} = \frac{(p-1) \cdot (t_f + t_b)}{v}\) ;
- Bubble 占比变为:\(\text{Bubble time fraction (pipeline bubble size)} = \frac{t_{pb}^{int.}}{t_{id}} = \frac{1}{v} \cdot \frac{p-1}{m}\) ;
- 优缺点分析:
- 气泡比例降低;
- 通信更多(增长 \(v\) 倍);实现更复杂;
- 与 TP 共同使用时的通信优化:
- 朴素实现:在节点内部开启 8-way 张量并行(TP=8)时,相邻 Stage 的 8 张 GPU 在发送流水线激活值时,默认会重复发送 8 份完全相同的张量(因为 TP 算完后输出已全量同步)。
- 优化实现(Scatter-Gather):
- 发送端(Scatter):发送方节点不重复发 8 份全量数据,而是将该张量沿维度切成 8 等份(Scatter),8 张 GPU 分别利用各自独占的 IB 网卡向接收节点并行发送 \(\frac{1}{8}\) 的分块。
- 接收端(Gather):接收方节点收到 8
份碎片后,通过节点内部高带宽的 NVLink 执行一次
All-Gather重新拼出完整张量。
- 效果:
- 跨节点 InfiniBand 传输的数据量降为了原来的 \(\frac{1}{\text{TP}}\) 。大幅降低跨节点网络负担,对冲掉交错式调度带来的 \(v\) 倍通信增加。
2.3 Tensor Model Parallelism
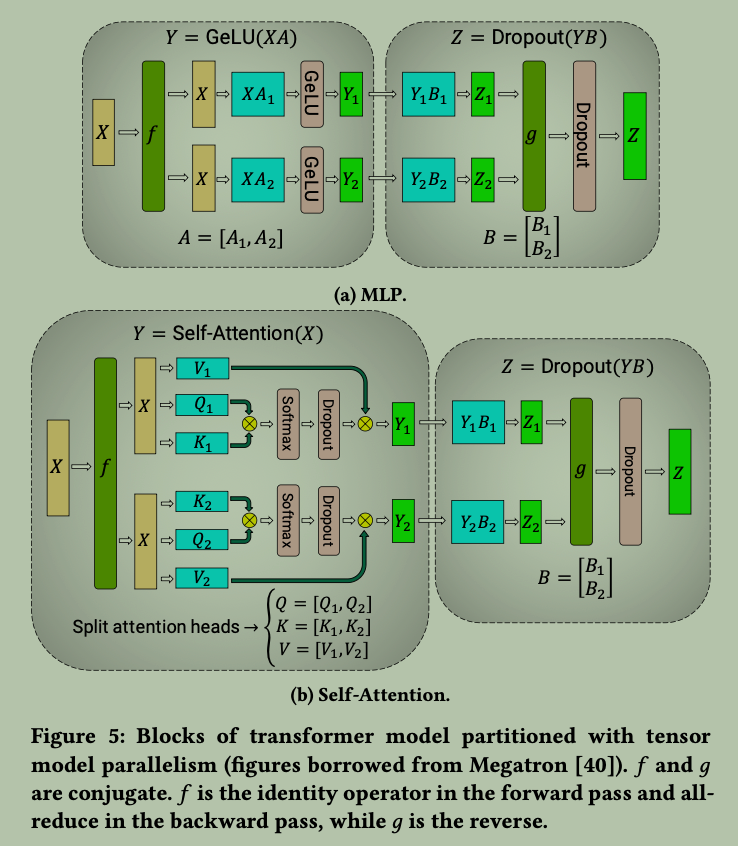
- 略,见 Megatron-LM v1 paper 或课程 slides。
3. Performance Analysis of Parallelization Configurations
3D 并行的不同设置,其实是以下:
- 显存占用;
- 设备利用率;
- 通信量;
三个因素的取舍与权衡(tradeoffs)。
本节针对 流水线气泡大小(pipeline bubble size) 给出了相关的分析模型;同时,定性地描述了通信时间的表现行为,并给出了通信量的成本模型。
3.1 Notation
- \((p, t, d)\) 分别表示 PP/TP/DP 设置大小;
- \(n\) 表示 GPU 数量,且 \(n = p \times t \times d\) ;
- \(B\) 表示 global batch size;
- \(b\) 表示 micro-batch 大小(决定了单次 forward/backward 输入大小和算子效率);
- \(m = \frac{1}{b} \cdot \frac{B}{d}\) 表示每个流水线的 micro-batch 数量(决定了流水线深度)。
3.2 Tensor and Pipeline Model Parallelism
假设 DP 设置为 1,即 \(d = 1\),则 \(t \cdot p = n\) 。则流水线气泡比例关于 \(t\) 关系为:
\[ \frac{p-1}{m} = \frac{n/t -1}{m} \]
- 当 \(B\) 与 \(b\) 与 \(d\) (\(m = \frac{B}{b \cdot d}\)) 固定时, \(t\) 增加时,流水线气泡比例下降。
- 通信量分析(受 \(p\) 与 \(t\) 影响)
- PP 点对点通信
- 每两个连续 device 间一个 micro-batch 所需通信量为 \(bsh\) ,其中 \(s\) 为序列长度,\(h\) 为隐藏层维度;
- TP AllReduce 通信
- 激活值 tensor shape 为 \([b,s,h]\)
,需要在 \(t\) 个 device 进行 AllReduce
通信,每层每个 micro-batch 所需通信量为 \(8bsh\frac{t-1}{t}\) 。
- forward/backward 各需要 2 次 AllReduce 通信,共 4 次;
- 每次 AllReduce 通信量为 \(2bsh\frac{t-1}{t}\) ;
- 单个流水线 Stage(即单张 GPU)上分配的 Transformer 层数为 \(l_{stage}\) ,则每个 device 每个 micro-batch 的通信量为 \(l_{stage} \cdot \left( 8bsh\frac{t-1}{t} \right)\) 。
- 激活值 tensor shape 为 \([b,s,h]\)
,需要在 \(t\) 个 device 进行 AllReduce
通信,每层每个 micro-batch 所需通信量为 \(8bsh\frac{t-1}{t}\) 。
- 结论:
- TP 通信量远大于 PP;
- TP 设置不应超过单机 GPU 数量;
- 单机设置 TP 后模型仍无法放置时,用 PP 进一步在不同机器间扩展。
- PP 点对点通信
3.3 Data and Model Parallelism
3.3.1 Pipeline Model Parallelism
考虑 TP=1 即: \(t = 1\) 时,则每个流水线的 micro-batch 大小为 \(m = \frac{B}{d \cdot b} = \frac{b'}{d}\) ,其中 \(b' = \frac{B}{b}\) 。当有 \(n\) 个 GPU 时,PP 大小 \(p = \frac{n}{t \cdot d} = \frac{n}{d}\) 。则流水线气泡比例为:
\[ \frac{p-1}{m} = \frac{n/d -1}{b'/d} = \frac{n-d}{b'} \]
- 当 \(d\) 增大时,\(n - d\) 减小,流水线气泡比例降低;
- \(d\) \(n\) \(b'\) 取值变化时,流水线气泡比例如下图所示:
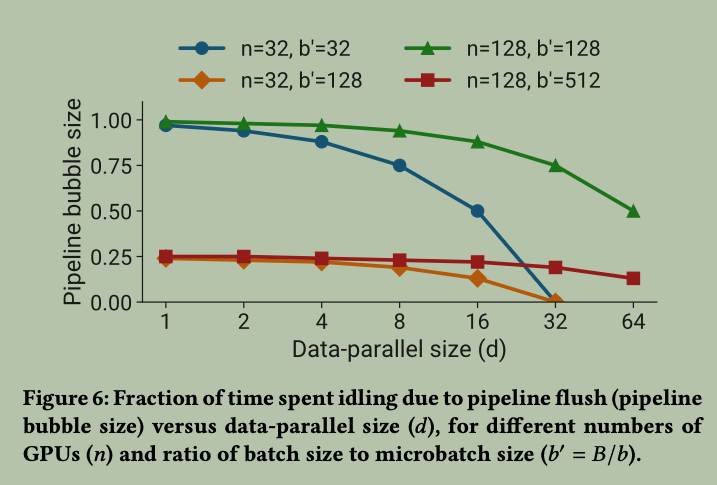
- 在模型能够放下的前提下,应该尽量增大 DP 大小;
- 增加 global batch size \(B\) 时,\(b' = \frac{B}{b}\) 增加,流水线气泡比例降低;同时 DP backward AllReduce 梯度通信频率降低,进一步增加吞吐。
3.3.2 Data and Tensor Model Parallelism
- TP AllReduce 通信对每个 micro-batch 进行;
- DP AllReduce 通信只需要在整个 global batch 完成后进行一次;
- 结论:
- 设置 Model Parallel Size 为 \(M = t \cdot p\) 以让模型参数、梯度、激活值、优化器状态能够在 GPU memory 内放下;
- 在此基础上使用 DP 扩展训练吞吐。
3.4 Micro-batch Size
Micro-batch 大小 \(b\) 也会影响训练吞吐,如下图所示:
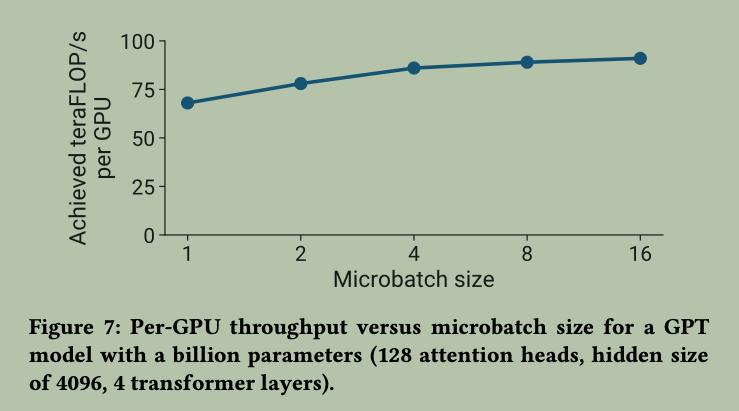
- micro-batch 增加让单卡训练吞吐增加 30+%;
问题:给定 3D Parallel 设置 \((p, t, d)\) 和 global batch size 大小 \(B\) ,该如何设置 micro-batch size \(b\) ?
- DP 通信量与 \(b\) 无关;
- 令 \(t_f(b)\) 和 \(t_b(b)\) 表示将 micro-batch size \(b\) 映射为完成一个 micro-batch forward/backward 计算耗时的函数,则不考虑通信开销,完成整个 batch \(B\) 耗时为(同上,\(b' = \frac{B}{d}\)):
\[ \left( \frac{b'}{b}+ p - 1 \right) \cdot \left( t_f(b) + t_b(b) \right) \]
- micro-batch 大小 \(b\) 同时影响:
- 计算强度
- 流水线气泡比例
- 固定 \((p, t) = (8, 8)\) 时,micro-batch size \(b\) 大小与训练吞吐关系如下图所示:
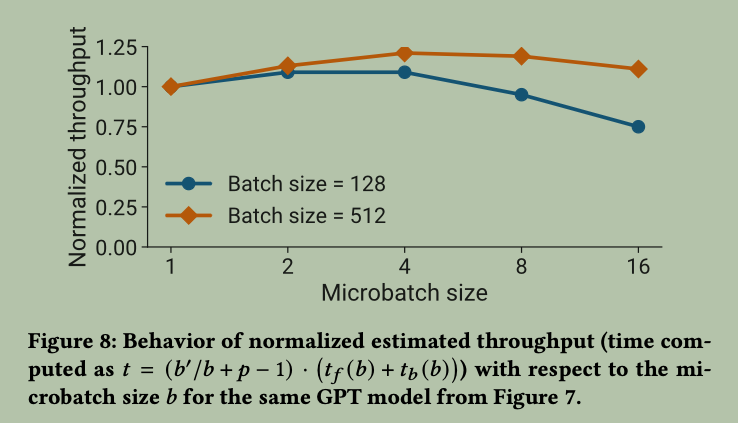
- 上图展示,\(b = 4\) 时吞吐最高;
- 结论:
- 最佳 micro-batch size \(b\)
的取值共同取决于:
- 模型的吞吐量与显存占用特性;
- 流水线深度 \(p\) ;
- 数据并行大小 \(d\) ;
- 全局批次大小 \(B\) ;
- 最佳 micro-batch size \(b\)
的取值共同取决于:
3.5 Activation Recomputation
- Motivation:通过在反向传播紧邻发生前再次运行一次前向传播(此时仅需暂存给定流水线 Stage 的输入激活值,而无需保存要庞大得多的全量中间激活值),以增加计算量为代价来换取更低的显存占用;
- 激活检查点的数量不会直接影响吞吐量,但会显著影响显存占用;
- 理论分析:
- 设 \(A_{input}\) 为单层的输入激活值大小,\(A_{intermediate}\) 为单层的中间激活值大小。如果一个流水线 Stage 包含 \(l\) 个 Transformer 层,且设置了 \(c\) 个检查点,则总激活值显存占用为:\(c \cdot A_{input} + \frac{l}{c} \cdot A_{intermediate}\) ;该函数的最小值在以下位置取得: \(c = \sqrt{l \cdot \left(\frac{A_{intermediate}}{A_{input}}\right)}\) 。
- 在实际工程中,通常对 \(A_{intermediate}\) 进行经验测量。在大多数情况下,每 1 或 2 个 Transformer 层设置一个检查点是最优的。
3.5.1 Activation Partitioning & Sequence Parallelism(SP)
TP 存在的问题
- 非 GEMM 区域激活值显存冗余:传统张量并行仅切分了 GEMM 矩阵乘法区(QKV 投影、Output Projection 及 MLP 线性层),而对于 LayerNorm、Dropout、Residual Add 等非 GEMM 逐元素(Element-wise)算子,TP 组内的所有 GPU 都会 全量重复存储 其输入输出激活值,形状均为 \([B, S, H]\) ;
- 长文本场景下的显存瓶颈:随着序列长度 \(S\) 的增加,这些未切分的重复激活值显存呈线性膨胀;即使开启了激活检查点(Activation Checkpointing),检查点处暂存的 LayerNorm 输入激活值依然占据大量显存,成为限制上下文长度(Long Context)与引发 OOM 的主要瓶颈。
引入 SP 后 TP 通信方式变化
- 核心思想:利用 LayerNorm 和 Dropout 在序列维度(Sequence Length, \(S\) )上相互独立的特性,将非 GEMM 区域的激活值沿着 \(S\) 维度均匀切分给 TP 组内的各卡(每卡处理 \(\frac{S}{TP}\) );
- 通信算子等价拆解(零额外通信开销):利用恒等式
\(\text{All-Reduce} = \text{Reduce-Scatter} +
\text{All-Gather}\),将传统 TP 内部的通信算子进行了优雅替换:
- 行并行(Row-Parallel)GEMM 结束时:将原有的
All-Reduce替换为Reduce-Scatter,在归一化求和的同时将激活值沿序列维度切分,各卡仅获得 \([B, \frac{S}{TP}, H]\) 的局部激活值; - 非 GEMM 区本地计算:各卡在本地独立执行 LayerNorm 与 Dropout 计算;
- 列并行(Column-Parallel)GEMM 开始前:触发一次
All-Gather,将 \([B, \frac{S}{TP}, H]\) 重新拼回全量序列张量 \([B, S, H]\) 喂给 GEMM。 - 注:总通信字节数与原
All-Reduce完全相同,实现了白嫖显存收益。
- 行并行(Row-Parallel)GEMM 结束时:将原有的
激活值显存节省分析
- 非 GEMM 区域激活显存降低 \(\frac{1}{TP}\):LayerNorm、Dropout 以及残差连接的激活值显存占用从 \(O(B \cdot S \cdot H)\) 降至 \(O(B \cdot \frac{S}{TP} \cdot H)\),显存开销缩减为原来的 \(\frac{1}{TP}\);
- 与激活重计算(Activation Recomputation)协同放大:重计算所需的 Checkpoint(如 LayerNorm 输入张量)在 SP 下同样按 \(\frac{1}{TP}\) 切分存储,大幅降低了常驻显存;
- 算力与访存负载平摊:非 GEMM 区域算子的本地计算量与内存访存量也同步降至 \(\frac{1}{TP}\),进一步提升了 Memory-bound 算子的执行效率。
开启 SP 后 backward 流程
- 自动求导的通信算子对偶:前向的
All-Gather在反向映射为Reduce-Scatter;前向的Reduce-Scatter在反向映射为All-Gather; - 反向传播计算与通信链条(按反向执行顺序):
- 非 GEMM 区域反向:在本地针对切片激活值 \([B, \frac{S}{TP}, H]\) 计算 LayerNorm / Dropout / 残差的梯度,得到切片梯度 \(\frac{\partial L}{\partial Y_{split}} \in [B, \frac{S}{TP}, H]\);
- 触发
All-Gather:将切片梯度拼回全量序列梯度 \(\frac{\partial L}{\partial Y_{full}} \in [B, S, H]\),准备喂给 Row-Parallel GEMM; - Row-Parallel GEMM 反向:计算 Output Projection / MLP 的梯度;
- Self-Attention / GeLU 反向:在本地计算 Attention / 激活函数的梯度;
- Column-Parallel GEMM 反向:计算 QKV Projection / MLP 的梯度,得到对输入的全量梯度 \(\frac{\partial L}{\partial X_{full}} \in [B, S, H]\);
- 触发
Reduce-Scatter:对全量梯度进行跨卡规约求和,并沿 \(S\) 维度切分,得到当前卡负责的切片梯度 \(\frac{\partial L}{\partial X_{split}} \in [B, \frac{S}{TP}, H]\),继续传给上一个 Transformer Block 的非 GEMM 区域;
- 通信开销完全对称:反向传播同样包含 1 次
All-Gather与 1 次Reduce-Scatter(通信总字节数与传统 TP 1 次反向All-Reduce等价),整个前向+反向过程依然没有产生任何额外的通信 overhead。
4. Implementation
- 基于 PyTorch 实现;
- 使用 NCCL 通信;
- 做了通信/计算优化;
4.1 Communication Optimizations
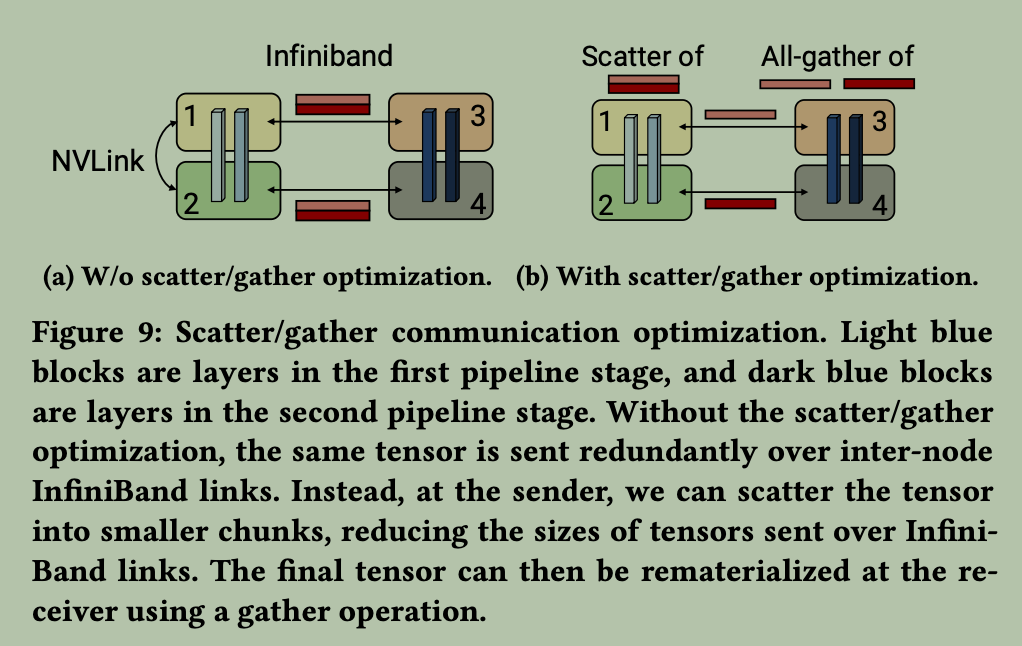
- 利用 TP/PP 同时开启的特性,优化 PP 的 P2P 通信:
- 发送端进行 Scatter,以减少跨机 IB 通信量,避免冗余通信;
- 接收端进行 AllGather,利用机内高速 NVLink 互联,提高通信速度;
4.2 Computation Optimizations
- 改变数据布局:\([b, s, a, h] \rightarrow
[s, b, a, h]\) ,其中 \(b, s, a,
h\) 分别表示 batch、sequence、attention heads 和 hidden dim。
- 转换后 layout \((b, a)\) 维度构成连续的 batch size (shape 可以看作三维: \([s, b \cdot a, h]\) ,strides 为 \([b \cdot a \cdot h, h, 1]\) ,则可以看作 \(\text{leading\_stride} = b \cdot a \cdot h\) 且 \(\text{batch\_stride} = h\) 的 batched GEMM 操作 ) ,可以利用 strided batched GEMM 接口,避免 transpose 操作高效执行 GEMM。
- 使用 PyTorch JIT 为一连串逐元素操作生成了融合 Kernel(如
bias + GeLU以及bias + dropout + add)。 - Softmax 组合算子融合:创建了两个自定义 CUDA Kernel,实现了缩放(Scale)、掩码(Mask)和 Softmax 规约操作的融合:一个用于支持通用掩码(如 BERT 模型中的 Mask),另一个用于支持隐式因果掩码(如 GPT 等自回归模型中的 Causal Masking)。
5. Conclusion
- 3D Parallel
- TP:机内
- SP:减少开启 TP 时激活值显存占用
- PP:机间
- 1F1B
- interleaved(layer chunk)
- gradient checkpointing
- DP:扩展吞吐
- TP:机内
- TP & PP
- Scatter + AllGather 通信优化
- Compute Optimization
- micro-batch \(b\)
- 计算强度
- PP bubble 比例
- kernel fuse:减少显存访问
- micro-batch \(b\)
附录:Transformer FLOPs 分析
1. 符号与基本法则定义
- 符号定义:
- \(l\):Transformer 层数(Number of layers)
- \(h\):隐藏层维度(Hidden size)
- \(s\):序列长度(Sequence length)
- \(V\):词表大小(Vocabulary size)
- \(B\):训练批次大小(Batch size)
- 矩阵乘法 FLOPs 基本法则:
- 形状为 \(m \times k\) 的矩阵与形状为 \(k \times n\) 的矩阵相乘(\(A_{m \times k} \times X_{k \times n}\)),需要的浮点运算数为 \(2 m k n\)(乘法与加法各算 1 次 FLOP)。
2. 单个 Transformer Block 前向传播 FLOPs 拆解
(1) Self-Attention 模块
- Q, K, V 线性投影:将维度 \(h\) 映射为 Q、K、V 三个张量(总权重大小为 \(3 \times h \times h\)),计算量为 \(6 B s h^2\)。
- Attention Score 计算 (\(Q \cdot K^T\)):计算 \(B \cdot a\) 个 Head 的 \(s \times d_k\) 与 \(d_k \times s\) 矩阵乘法(其中 \(a \cdot d_k = h\)),计算量为 \(2 B s^2 h\)。
- Attention 权重加权求和 (\(\text{Softmax}(QK^T) \cdot V\)):\(s \times s\) 概率矩阵与 \(s \times d_k\) 的矩阵乘法,计算量为 \(2 B s^2 h\)。
- 输出线性投影(Output Projection):线性映射 \(h \to h\),计算量为 \(2 B s h^2\)。
- Self-Attention 前向小计:\(6 B s h^2 + 2 B s^2 h + 2 B s^2 h + 2 B s h^2 = \mathbf{8 B s h^2 + 4 B s^2 h}\)。
(2) Feed-Forward Network (MLP) 模块
- 第一层升维 (\(h \to 4h\)):\(2 \times B \times s \times h \times 4h = \mathbf{8 B s h^2}\)。
- 第二层降维 (\(4h \to h\)):\(2 \times B \times s \times 4h \times h = \mathbf{8 B s h^2}\)。
- MLP 前向小计:\(8 B s h^2 + 8 B s h^2 = \mathbf{16 B s h^2}\)。
(3) 单层前向传播总和
- 将 Self-Attention 与 MLP 模块相加: \(\text{Forward FLOPs per layer} = (8 B s h^2 + 4 B s^2 h) + 16 B s h^2 = \mathbf{24 B s h^2 + 4 B s^2 h}\) 。
3. 反向传播与激活重计算(Activation Recomputation)的影响
- 反向传播 (Backward Pass):需要对输入张量和权重张量分别求导,所需的 FLOPs 为前向传播的 2 倍。
- 激活重计算 (Activation Recomputation):在前向传播丢弃中间激活值,在反向传播前额外执行一次前向传播。
- 总计算倍率:前向传播 (\(1\times\)) + 反向传播 (\(2\times\)) + 重计算前向 (\(1\times\)) = \(4 \times\) 前向 FLOPs。
- 单层 Transformer 完整训练 FLOPs: \(\text{FLOPs per layer} = 4 \times \left(24 B s h^2 + 4 B s^2 h\right) = 96 B s h^2 \left(1 + \frac{s}{6h}\right)\) 。
4. Logit 层(Language Model Head)
- 功能:将隐藏层特征 \(h\) 映射到词表空间 \(V\)。
- 前向传播:\(2 B s h V\)。
- 反向传播:\(4 B s h V\)(2倍前向)。
- Logit 层总 FLOPs:\(2 B s h V + 4 B s h V = \mathbf{6 B s h V}\)。
5. 单次训练迭代(Iteration)全量 FLOPs 最终公式
将 \(l\) 个 Transformer 层与 Logit 层累加,并提出公因式 \(96 B s l h^2\):
\(\mathbf{\text{Total FLOPs per iteration} = 96 B s l h^2 \left( 1 + \frac{s}{6h} + \frac{V}{16lh} \right)}\) 。
6. 实用估算近似(工程经验推导)
在大部分大语言模型配置中(如 \(h \ge 2048\)),\(\frac{s}{6h}\) 与 \(\frac{V}{16lh}\) 均极小(可忽略)。
- 单次 Iteration 计算量:\(\approx 96 B s l h^2\)。
- 模型参数量:\(P \approx 12 l h^2\)。
- 训练 \(T\) 个 Tokens 的总 FLOPs: 由于总迭代次数为 \(I = \frac{T}{B \cdot s}\),训练 \(T\) 个 Tokens 所需的总浮点运算量可简化为: \(\text{Total Training FLOPs} \approx \mathbf{8 T P}\) (注:若不开启激活重计算,该数值约为 \(6 T P\)。)