Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism
- Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism
- arXiv 提交日期:17 Sep 2019(GPT 2 blog 发布约半年后,即:February 14, 2019 -> 17 Sep 2019)
- 代码:Megatron-LM
- 作者:

摘要:
近期在语言模型方面的研究表明,训练大型 Transformer 模型能够显著推动自然语言处理(NLP)应用的前沿发展。然而,由于内存限制,超大型模型往往非常难以训练。在这项工作中,我们提出了训练超大型 Transformer 模型的系列技术,并实现了一种简单、高效的层内模型并行方法,从而能够训练拥有数十亿参数的 Transformer 模型。该方法不需要新的编译器或库的更改,它与流水线模型并行(pipeline model parallelism)正交且互补,并且只需在原生 PyTorch 中插入几个通信操作即可完全实现。
我们通过使用 512 个 GPU 成功收敛了高达 83 亿参数的基于 Transformer 的模型,展示了该方法的有效性。在整个应用中,我们维持了 15.1 PetaFLOPs 的算力,与维持 39 TeraFLOPs(即峰值 FLOPs 的 30%)的强大的单 GPU 基准相比,实现了 76% 的扩展效率。为了证明大型语言模型能够进一步推动技术发展达到新高度(SOTA),我们训练了一个类似于 GPT-2 的 83 亿参数 Transformer 语言模型和一个类似于 BERT 的 39 亿参数模型。我们发现,在类 BERT 模型中精心设计层归一化(layer normalization)的位置,对于随着模型规模增长而实现性能提升至关重要。基于我们的 GPT-2 模型,我们在 WikiText103(困惑度为 10.8,优于原 SOTA 的 15.8)和 LAMBADA(准确率为 66.5%,优于原 SOTA 的 63.2%)数据集上取得了 SOTA 结果。我们的 BERT 模型在 RACE 数据集上也取得了 SOTA 结果(准确率为 90.9%,优于原 SOTA 的 89.4%)。
1. Introduction
- 背景:模型越大 NLP 任务上性能越好。
- 问题:GPU 显存不够,无法放置完整模型。
- 本文提出的 Solution:层内模型并行(intra-layer model-parallelism)
- 仅面向 Transformer。
- 实现简单,基于 PyTorch Python API 即可。
- 可与 PP/DP 同时使用。
2. Model Parallel Transformers
Transformer 模型架构回顾:
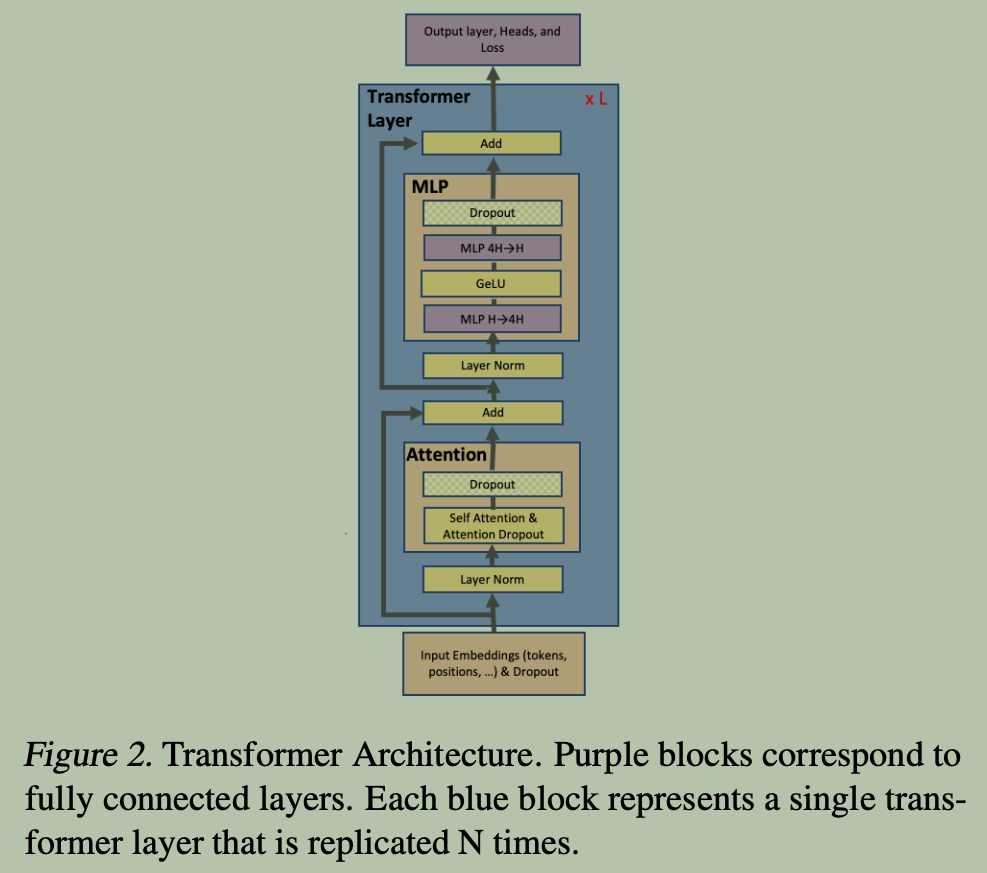
TP 切分方式:
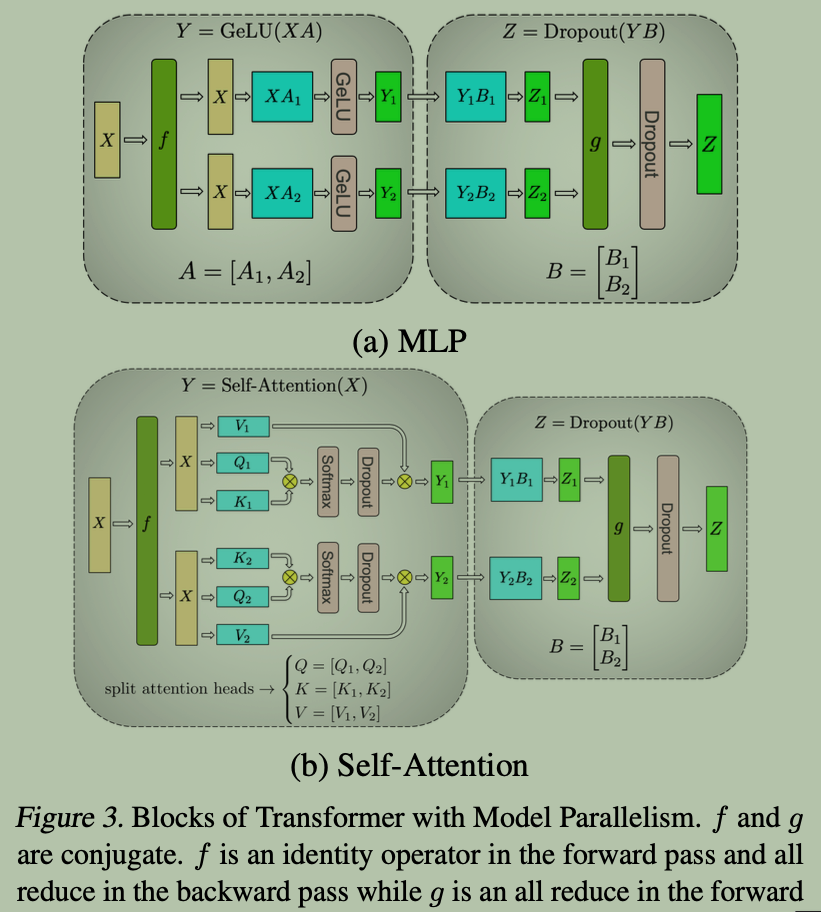
- 通信算子 \(f\) 与 \(g\)
- forward 时,\(f\) 对应 identity;\(g\) 对应 AllReduce(Sum)
- backward 时,\(f\) 对应 AllReduce(sum);\(g\) 对应 identity;
- 代码实现:
1 | |
- MLP 切分方式
- 第一层权重按 列 切分;
- 第二层权重按 行 切分;
- SelfAttention 切分方式
- QKV 权重矩阵按 列 切分,相当于按 Attention Heads 切分,天然利用 MHA 并行性,不同 Head Attention 在不同 device 并行计算,无需通信;
- O 权重矩阵按 行 切分;
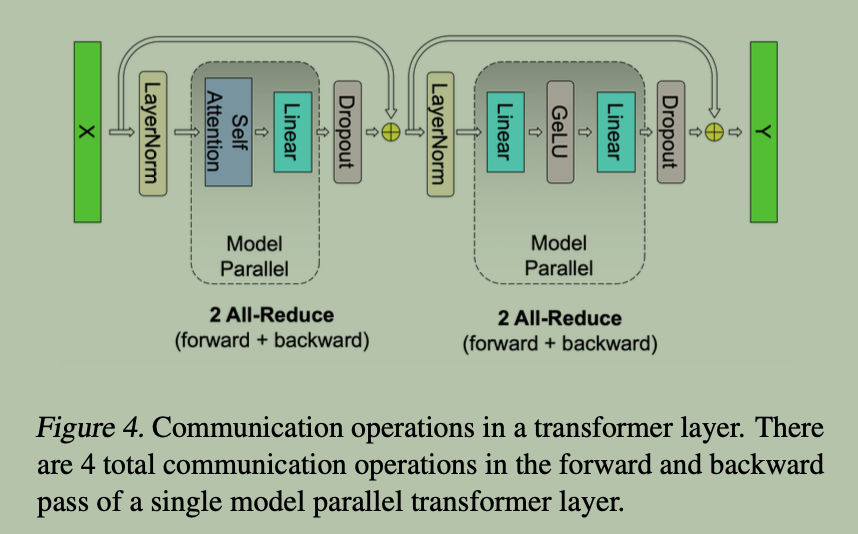
切分后 forward/backward 通信:各两次 AllReduce,如下图所示:
- Embedding/LM Head 切分方式:
- 由于 Transformer 模型的 LM Head 经常与 Embedding 共享权重,切分权重时需要同时考虑 Embedding/LM Head 计算特性;
- We parallelize the input embedding weight matrix \(E_{H×v}\) along the vocabulary dimension \(E = [E_1,E_2]\) (column-wise).
- Embedding forward:不同 device 拥有全量 Embedding 一个子集,需要 AllReduce 通信;
- LM Head forward:仅通信各个 device 局部 logits 的 reduce 结果,降低通信量为 \(b \times s \times v \rightarrow 2 \times b \times s\) 。
- LayerNorm / Dropout / Residual Connections 在多个 GPU 重复计算。
- Dropout 随机数种子问题
- Identical Dropout in TP Group
- 例子:
- FFN 第二个 Linear 层之后的 Dropout
- 原因:FFN 的 Dropout 是在 TP 计算完成进行 AllReduce 获取最终结果后在不同 device 上重复进行的计算,必须保证该 Dropout seed 在不同 device 间相同,以保证后续输入在 TP Group 内相同。
- 例子:
- Different Dropout in TP Group
- 例子:
- MHA AttentionScore 需要经过的 Dropout
- 原因:MHA 经过 TP 沿着 Head 切分后,获取的 AttentionScore 是属于不同 Head,互相独立的。需要让 TP Group 内的这个 Dropout seed 不同以让不同 head 独立计算捕捉不同的模式。
- 例子:
- 实际随机数生成器实现:
- 维护两套随机数生成器
- 一个生成器保证 TP Group 内不同 worker seed 相同,保证生成相同的 mask,用于 identical Dropout mask 生成与计算。
- 一个生成器保证 TP Group 内不同 worker seed 不同,保证生成不同 mask,用于 different Dropout mask 生成与计算。
- 上下文切换(Context Manager):在前向传播执行到模型并行区域(如 Self-Attention)时,通过 Python 上下文管理器自动将 PyTorch 的 CUDA RNG 切换为张量并行专属状态;离开该模块后,自动恢复为全局 RNG 状态。
- 维护两套随机数生成器
- Identical Dropout in TP Group
- LayerNorm:
- 由于在不同 device 间重复计算,需要保证初始化权重在同一个 TP Group
内经过广播,确保相同。
- 前向过程:各卡在本地独立计算 LayerNorm,不需要任何跨卡广播或同步。
- 反向传播:由于前向输入与权重完全相同,每张卡计算出的 LayerNorm 梯度也天然完全相同。
- 由于在不同 device 间重复计算,需要保证初始化权重在同一个 TP Group
内经过广播,确保相同。
- Dropout 随机数种子问题
TP & DP 共同训练:
示意图:
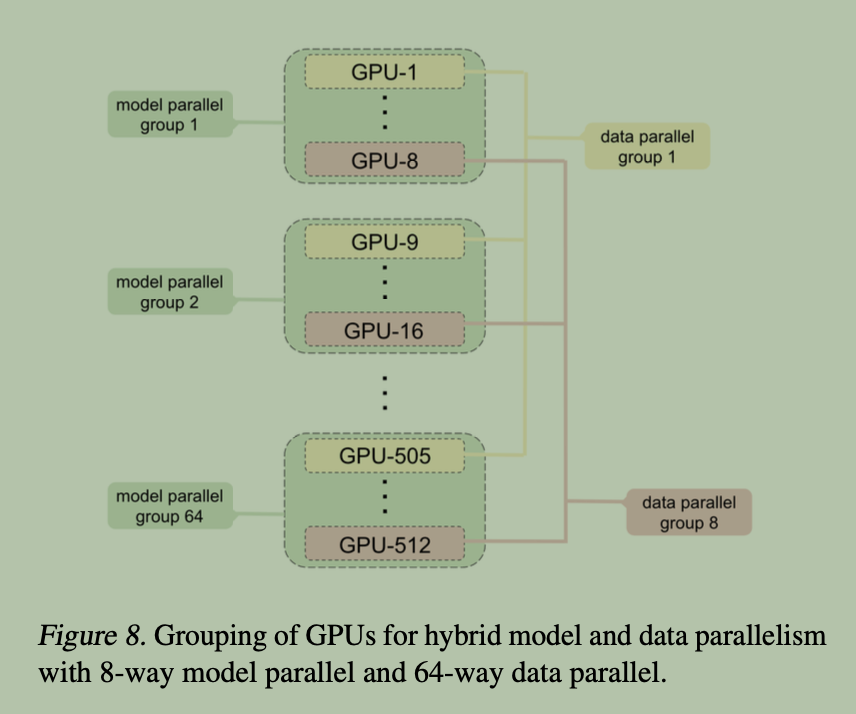
- 配置:TP=8;DP=64
- TP 组:连续的 8 个 GPU(一个 Node 内,以利用机内高速 NVLink)
- forward/backward:AllReduce 通信激活值
- DP 组:TP 组内 rank 相同的 64 个 GPU 构成一个 DP Group
- backward:AllReduce 通信梯度
Further Scaling Analysis
核心结论:
- 较小的模型(单 GPU 可以放下)也可以使用 TP
加速训练,但是加速比较低,不如直接 DDP 训练;
- 原因:TP 切分小模型后,GEMM 计算强度低,无法充分利用 GPU 算力,瓶颈变为显存带宽;
- 固定 TP=8 和 hidden_size 时,调整 Attention Heads 数量(每个 Head 的 dim)也会影响 TP 训练的扩展效率,见下表:
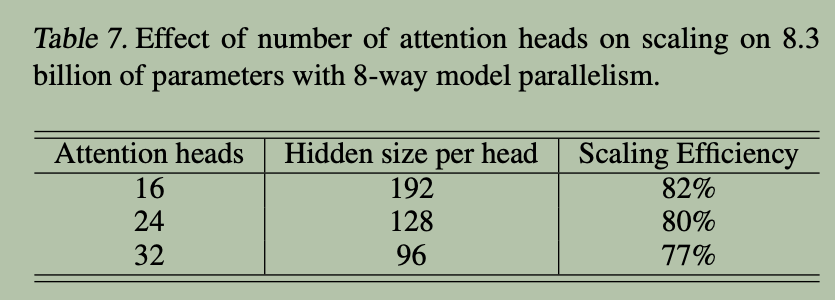
- 原因:
- shape 与 FLOPs 分析
- TP partition 数量 \(K\);Attention Head 数量为 \(h\)
- 输入 shape:\([B, S, H]\)
- 切分后 QKV 权重 shape:\([H, \frac{H}{K}]\)
- QKV 计算完成后进行 SelfAttention 的 \(QK^T\) 以及 \(AV\) 两个 GEMM 计算时,Q/V shape 为:\([B, \frac{h}{K}, S, \frac{H}{h}]\);\(K^T\) shape 为:\([B, \frac{h}{K}, \frac{H}{h}, S]\) ;GEMM
FLOPs:\(2 \times B \times \frac{h}{K} \times
S^2 \times \frac{H}{h}\) ;以标准 GEMM MNK 角度理解,上述 batched
GEMM 总 FLOPs 虽然不变(两项中的 \(h\)
分别作为分子与分母消掉),但是标准 GEMM 的 Reduce 维度 K 等于 \(\frac{H}{h}\) ,当这个值随着 Attention
Heads 数增加而减小时,导致了 GEMM kernel 效率的下降;
- 为什么 reduce 维度变小导致 GEMM 效率下降:
- tile GEMM 实现,reduce 维度较小时,shared memory load 与 tensor core compute overlap 程度低;
- 计算强度降低,算子瓶颈由计算型转向带宽型;
- 由于 reduce 维度小,利用 tensor core 计算时,padding 占比提高,有效计算比例降低;
- 为什么 reduce 维度变小导致 GEMM 效率下降:
- Softmax 计算数量:\(B \times h \times S\) ,与 Attention Heads 的数量成正比(每次 Softmax reduce 的元素数量不变保持为 \(S\),但是随着 Attention Heads 数量 \(h\) 增加,Softmax 计算次数增加);
- 由于随着 Attention Heads 数量增加,计算 SelfAttention 时的 GEMM kernel reduce 维度减小以及 Softmax 计算次数增加,导致了 TP 扩展效率随着 Attention Heads 数量降低。
- shape 与 FLOPs 分析
- 由此带来的对 TP 设置取舍与考虑
- TP 的扩展效率(Scaling Efficiency)本质上取决于 “本地计算时间能否完美掩盖跨卡通信时间(All-Reduce)”。
- 当 Heads 数量增加时,跨卡通信开销(All-Reduce 传输量 \(B \times S \times H\))保持恒定,但本地 GEMM 的算子效率下降、Softmax 访存增加,导致本地计算耗时拉长且 GPU 吞吐下降,最终导致 TP 的扩展效率从 82% 降到 77%。
3. Conclusion
- TP
- MLP
- 第一层按列切分
- 第二层按行切分
- MHA
- QKV 按列切分
- O 按行切分
- Embedding
- 沿词表维度切分
- Other Layers:
- 重复计算,Dropout 随机数种子问题
- Identical seed for 重复计算
- Different seed for TP 内部计算
- 重复计算,Dropout 随机数种子问题
- MLP
- TP 扩展效率与 Attention Heads 数量关系
- GEMM 效率下降
- Softmax 计算/访存增加