GPipe: Easy Scaling with Micro-Batch Pipeline Parallelism
- GPipe: Efficient Training of Giant Neural Networks using Pipeline Parallelism
- arXiv 提交日期:6 Nov 2018
- 作者:
摘要:
扩大深度神经网络的容量,已被证明是提升多种不同机器学习任务中模型质量的有效方法。在许多情况下,当模型容量增长并超出单个加速器的显存限制时,往往需要开发专门的算法或基础设施。然而,这些解决方案通常针对特定架构设计,无法直接迁移到其他任务中。为了满足高效且与任务无关的模型并行需求,我们推出了 GPipe——一个流水线并行库,它支持扩展任何可以表达为“层序列”的神经网络。通过将网络的不同子层序列部署在不同的加速器上进行流水线化处理,GPipe 能够灵活且高效地将各种不同网络扩展至巨型规模。此外,GPipe 采用了一种新型的微批次拆分流水线算法,当模型切分到多个加速器上时,能够实现近乎线性的加速比。我们通过在两种具有截然不同网络架构的任务上训练大规模神经网络,证明了 GPipe 的优势:1)图像分类:我们训练了一个包含 5.57 亿参数的 AmoebaNet 模型,并在 ImageNet-2012 上取得了 84.4% 的 Top-1 准确率。2)多语言神经机器翻译:我们在涵盖 100 多种语言的语料库上,训练了一个单一的 60 亿参数、128 层的 Transformer 模型,取得了超越所有独立双语模型的翻译质量。
1. Introduction
- 背景:许多机器学习任务的性能随着模型规则增加而增长。
- 问题:大规模模型训练的实际挑战:
- 硬件内存与通信带宽限制,要求必须将模型切分放置到多个 device;
- 高效的模型并行策略难以设计和实现:可扩展性/灵活性/训练效率的取舍;
- Solution:GPipe
- 按层切分模型到不同 device;
- mini-batch 切分为多个 micro-batch;
- 支持梯度检查点以减少激活值内存占用;
- 同步梯度下降,无训练收敛速度/准确性损失;
2. The GPipe Library
符号定义:
- partition 数量 \(K\)
- micro-batch 大小 \(M\)
- 模型层数 \(L\)
- \(L\) 层模型划分为 \(K\) 个 partition 的原则:每个 device 上的多个连续层 cost 只和应该尽可能接近,以让流水线执行效率更高。
算法流程:
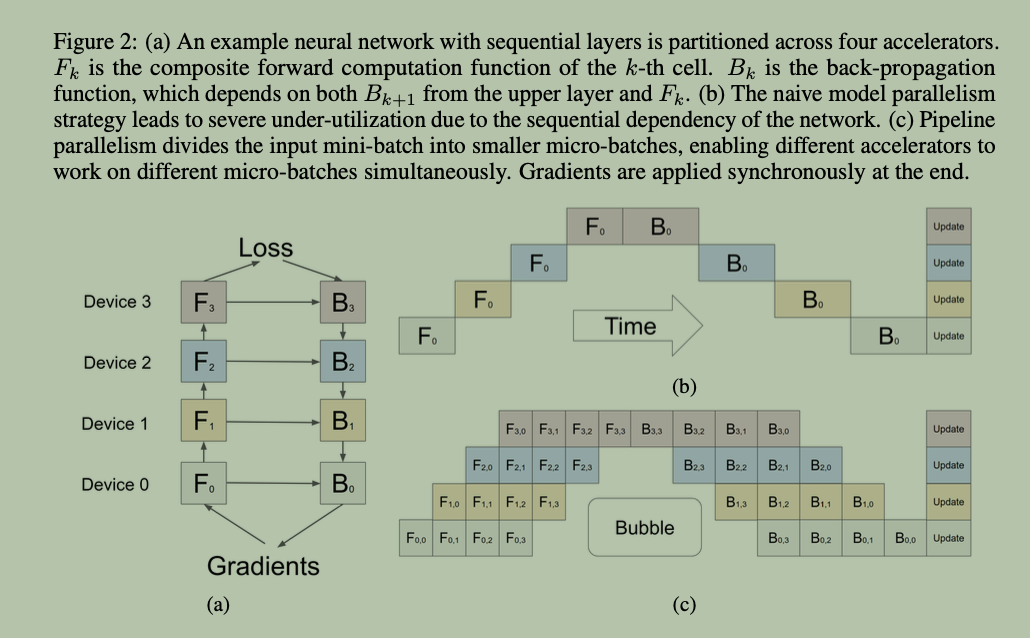
- mini-batch 大小 \(N\) 划分为 \(M\) 个 micro-batch;
- 一个 mini-batch forward 完成后进行 backward,\(M\) 个 micro-batch backward 梯度累加完成后,进行参数 update;
性能优化:
- 支持重计算以减少激活值内存占用;
- 峰值内存占用:\(O(N \times L) \rightarrow O(N + \frac{L}{K} \cdot \frac{N}{M})\)
- bubble 率:\(\frac{K - 1}{M + K - 1}\) ,当 \(M \ge 4 \times K\) 时可忽略;
- 仅需要 partition 间通信激活值,不需要高速互联硬件;
3. Conclusion
- GPipe
- 按层切分模型到不同 device;
- mini-batch 切分为多个 micro-batch;
- 支持梯度检查点以减少激活值内存占用;
- 同步梯度下降,无训练收敛速度/准确性损失;
GPipe: Easy Scaling with Micro-Batch Pipeline Parallelism
https://arcsin2.cloud/posts/2026/10/1410675755/