Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity
- Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity
- arXiv 发布日期:11 Jan 2021(发表于:Journal of Machine Learning Research 2022)
- 代码:t5x
- 作者:
摘要
在深度学习中,模型通常对所有输入重复使用相同的参数。混合专家(Mixture of Experts, MoE)模型打破了这一范式,转而为每一个传入的样本选择不同的参数。其结果是一个稀疏激活的模型——虽然拥有极其庞大的参数量,却能保持恒定的计算成本。然而,尽管 MoE 取得了几项显著的成功,但其广泛应用一直受到架构复杂性、通信成本以及训练不稳定性的阻碍。
我们通过引入 Switch Transformer 解决了这些问题。我们简化了 MoE 的路由算法,设计了更直观的改进模型,降低了通信和计算成本。我们提出的训练技术缓解了训练不稳定性,并且首次证明了大型稀疏模型可以使用低精度(bfloat16)格式进行训练。
基于 T5-Base 和 T5-Large 架构,我们在相同计算资源下实现了高达 7 倍的预训练速度提升。这些改进同样延伸到了多语言场景,在全部 101 种语言中均取得了超越 mT5-Base 的性能增益。最后,我们在 C4 数据集(Colossal Clean Crawled Corpus)上预训练了高达万亿参数规模的模型,进一步推进了当前语言模型的极限,并实现了相比 T5-XXL 模型 4 倍的速度提升。
1. Introduction
- 已有 MoE 范式存在的问题:复杂性 + 通信成本 + 训练不稳定;
- 本文提出的 Solution:Switch Transformer,简化 MoE 并提高其性能。
2. Switch Transformer
- Motivation:以简单和计算高效的方式,扩展 Transformer 模型参数量。
- 提升模型参数量,但保持每 token 计算 FLOPs 不变;
模型结构:
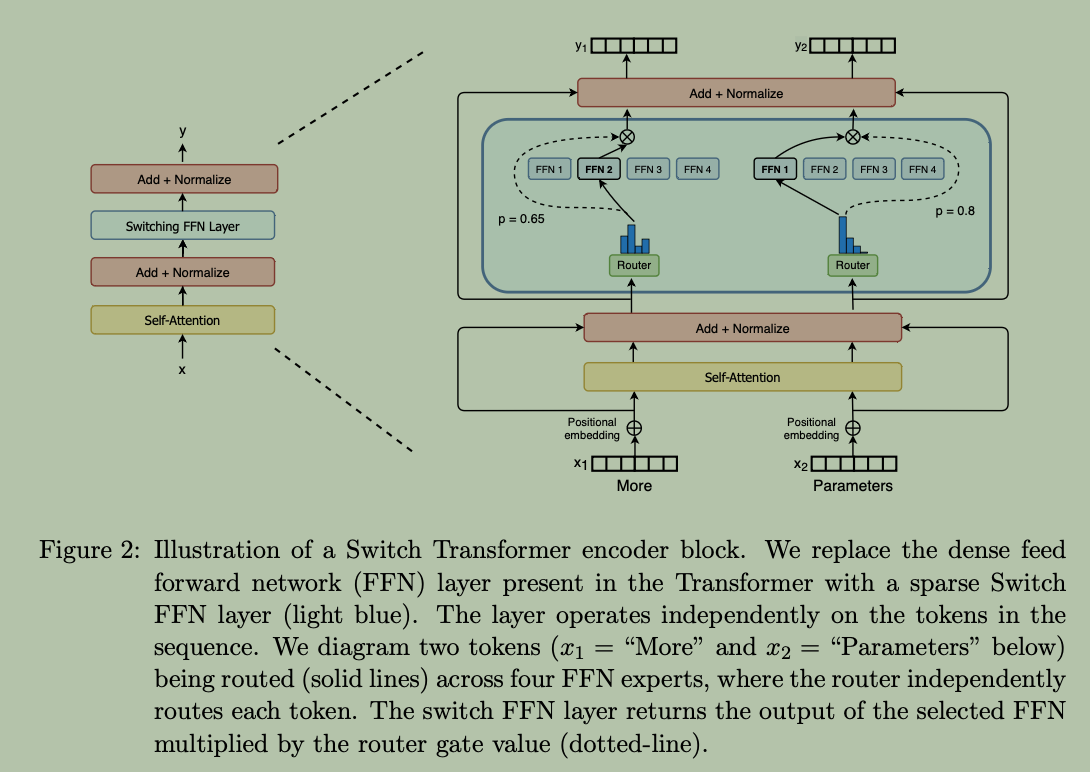
- FFN -> MoE
- Top-K 取值为 1
2.1 Simplifying Sparse Routing
Mixture of Expert Routing
传统实现:输入 token 特征 \(x\) 经过 Router 权重 \(W_r\) 得到 logits:\(h(x) = W_r \cdot x\) ,然后经过 Softmax 得到概率,从 \(N\) 个专家 \(\{E_i(x)\}_{i=1}^{N}\) 中选择概率最高的 Top-K 个。每个专家 \(i\) 的路由权重为:
\[ p_i(x) = \frac{e^{h(x)_i}}{ \sum_j^N{e^{h(x)_j}} } \]
令集合 \(\mathcal{T}\) 表示 Top-K 个专家的索引集合,即 MoE 层最终输出为:
\[ y = \sum_{i \in \mathcal{T}}{ p_i(x)E_i(x) } \]
Switch Routing: Rethinking Mixture-of-Experts
- 已有观点:
- \(k > 1\) 以让 Router 更容易梯度更新;
- 最前面几层 \(k\) 要更大;
- 本文观点:
- \(k = 1\) ,即:Switch layer;
- 简化了 Routing 计算(但是不能简单取 logits 做 Route,还需要计算 Softmax 得到 probs,以让反向传播时梯度可以传播给 Router 权重);
- 优点:
- 由于只选一个 Expert,减少了 Router 的计算量;
- 每个 expert 的 batch size (expert capacity) 可以更大,即:减少了 Expert 的计算量;
- Routing 实现更简单且通信量减小;
不同 Capacity Factor 取值 Router 示意图:
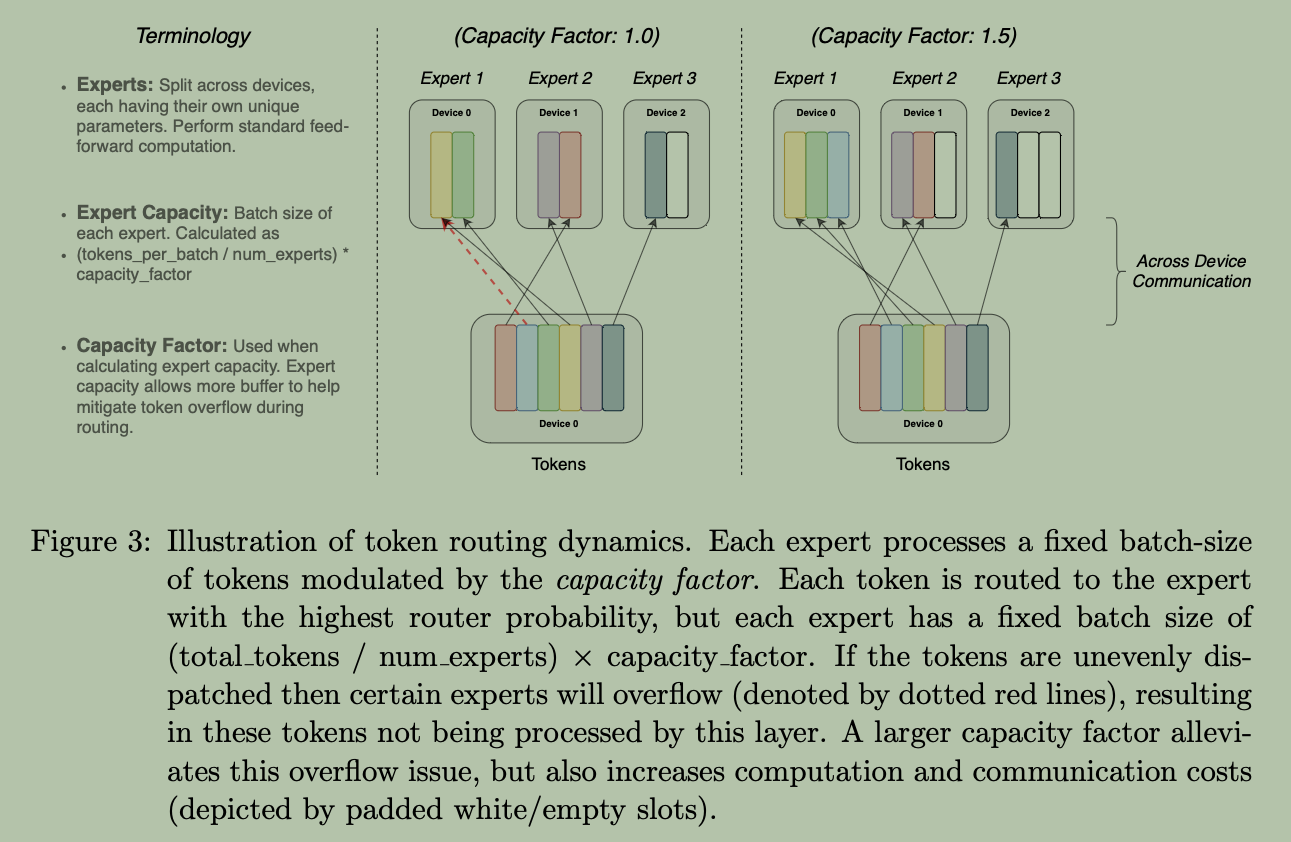
- overflow 时不进行 expert FFN 计算;
- capacity factor 增大可以缓解 overflow 现象,但是由于负载不均衡增加了整体计算和通信成本;
2.2 Efficient Sparse Routing
Distributed Switch Implementation
- Expert Capacity:每个专家计算的 token 数量上限,计算方式:
\[ \text{expert capacity} = \frac{\text{tokens per batch}}{\text{number of experts}} \times \text{capacity factor} \]
- 设置 expert capacity 大于 1,则额外提供了一定的缓冲区,允许某些专家临时接收超过平均数量的 Token;
- 当路由给某个专家的 Token 数量超过了其声明的 Expert Capacity(即专家溢出),超出的 Token 不会进行专家 FFN 计算,而是通过残差连接(Residual Connection)直接透传到下一层;
- trade-off:
- 增大 Capacity Factor 会减少 Token 丢弃率,但空白的槽位(Padded slots)会造成计算与显存浪费。
- 实验表明,将 Token 丢弃率维持在较低水平(通常小于 1%)对稀疏模型的扩展至关重要。
A Differentiable Load Balancing Loss
对于包含 \(T\) 个 Token 的 Batch \(\mathcal{B}\) 和 \(N\) 个专家:
- 实际分发比例(离散,不可导): 表示实际被分配给专家 \(i\) 的 Token 占总 Token 数的比例
\[ f_i = \frac{1}{T} \sum_{x \in B} \mathbf{1}\{\text{argmax } p(x) = i\} \]
- 软路由概率质量(连续,可导): 表示 Router 分配给专家 \(i\) 的概率累加均值
\[ P_i = \frac{1}{T} \sum_{x \in B} p_i(x) \]
- 辅助 Loss 公式:
\[ \text{Loss}_{\text{aux}} = \alpha \cdot N \cdot \sum_{i=1}^N f_i \cdot P_i \]
- 系数放缩:
- 乘以 \(N\) 使得当路由达到完全均匀平衡时,\(\sum_{i=1}^N (f_i \cdot P_i) = \frac{1}{N}\),此时 \(\text{Loss}_{\text{aux}}\) 的计算值固定为 1,不会随着专家数量 \(N\) 的增减而发生量级漂移。
- 乘以超参数 \(\alpha = 10^{-2}\) 可以迅速拉平负载,同时不会干扰主任务(交叉熵)的梯度方向。
2.3 Putting It All Together: The Switch Transformer
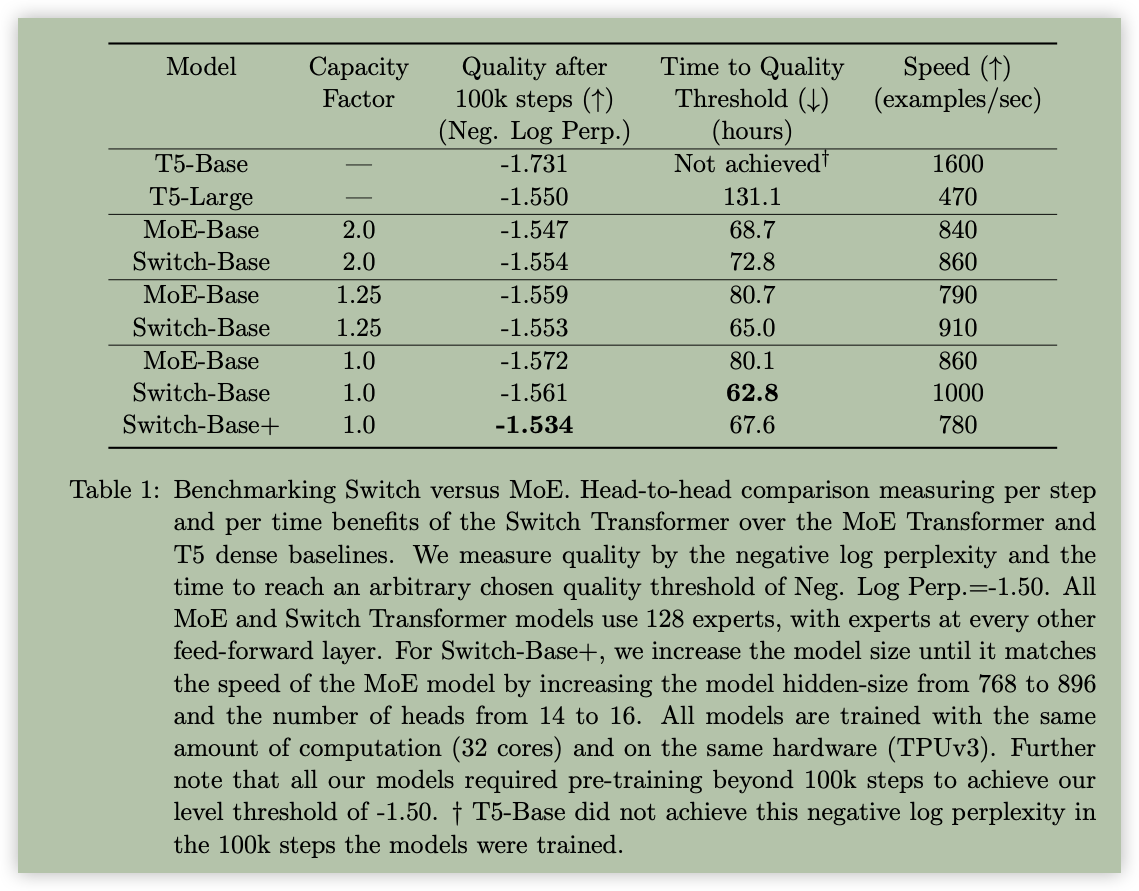
- 三类模型:
- T5-base:Dense;
- MoE-Base:GShard 模型,Top-K 取值为 2;
- Switch-Base/Switch-Base+:本文模型;
- 实验设置:
- Switch-Base 与标准的 T5-Base 在单 Token 计算量(FLOPs)上完全对齐。
- 传统的 MoE-Base 由于采用 Top-2 路由(每个 Token 激活 2 个专家),其单 Token 计算量比 Switch-Base 和 T5-Base 更高。
- 所有 MoE 和 Switch 模型均设置 128 个专家,每隔一层 FFN 替换为专家层,并在相同的 32 核 TPUv3 硬件上训练相同步数。
- 结果:
- Switch Transformers outperform both carefully tuned dense models and
MoE Transformers on a speed-quality basis.
- 在相同的计算资源和训练时间下,Switch Transformer 获得了最佳的综合表现。
- The Switch Transformer has a smaller computational footprint than
the MoE counterpart.
- 由于 Switch 仅激活 1 个专家,其计算与通信开销显著低于 Top-2 MoE。
- Switch Transformers perform better at lower capacity factors (1.0,
1.25).
- Switch Transformer 在 CF = 1.0(完全无额外的容量 Buffer)时,吞吐量升至 1000 examples/sec,达到 -1.50 阈值的时间进一步缩短至 62.8 小时。这证明了 Top-1 路由在极端显存约束下依然具有极高的稳定性与高吞吐优势。
- Switch Transformers outperform both carefully tuned dense models and
MoE Transformers on a speed-quality basis.
2.4 Improved Training and Fine-Tuning Techniques
Selective precision with large sparse models
- GShard 采用 fp32 训练 MoE 模型,以克服稀疏模型训练稳定性问题;
- 本文提出的方法:
- 选择性高精度(Selective Precision):只在 Router 函数内部将输入 Tensor 临时转为 fp32 计算(包括计算 Logits、Softmax 和派发/组合矩阵);完成 Top-1 路由决策与概率乘积后,立即将输出转回 bf16。
- All2All 通信数据类型仍为 bf16,节省通信带宽。
Smaller parameter initialization for stability
- 问题: 标准 Transformer 习惯使用截断正态分布初始化权重(均值 \(\mu=0\),方差 \(\sigma = \sqrt{s/n}\),其中默认 Scale \(s=1.0\))。但在包含了数十甚至数百个专家的巨型稀疏模型中,这种标准的初始化 scale 会在训练初始阶段产生过大的激活值,导致 Router 门控梯度剧烈抖动甚至冲垮网络。
- Solution: 将默认的初始化 Scale 直接缩小 10 倍(即设定 \(s=0.1\))。
- 效果:实验表明,缩小初始化 Scale 显著降低了训练早期的不稳定性与不同随机种子间的方差。
Regularizing large sparse models
- 问题:Switch Transformer 虽然单 Token 的 FLOPs 与 Dense 模型对齐,但其总参数量大出数倍至数十倍。在下游任务(如 GLUE、SQuAD、SuperGLUE)微调时,小数据集极易导致庞大的专家层陷入严重的过拟合。若盲目将所有层的 Dropout 统一调大,又会伤害非专家层(Self-Attention 等)的表征能力。
- Solution:提出 Expert Dropout
策略:在微调时分层施加差异化的 Dropout。
- 非专家层(Non-Expert Layers,如 Self-Attention 和普通 Dense
层):保持较低的 Dropout(如
0.1); - 专家层内部(Expert FFN Layers):大幅提高中间隐层的 Dropout 比例(如
0.4)。
- 非专家层(Non-Expert Layers,如 Self-Attention 和普通 Dense
层):保持较低的 Dropout(如
3. Scaling Properties
- 实验证明 Switch Transformer 的优势:
- 保持 FLOPs 不变前提下,增加 Experts 数量(参数量),能够提升模型性能(达到相同性能,需要的训练 step 数更少);
- 即使 Switch Transformer MoE 引入了 All2All 通信,在相同训练耗时下,性能更好(即:在 固定训练时长与算力预算(Wall-clock Time) 的前提下,MoE 模型仍比 Dense 模型更具性能优势);
- 如果将算力分配给一个单 Token FLOPs 膨胀 3.5 倍的更大 Dense
模型(739M 参数的 T5-Large),情况会怎样?
- FLOPs 劣势下的反超:
- 样本效率:Switch-Base(每个 Token 仅用 T5-Base 级别的计算量)在步数上依然比单 Token 计算量高出 3.5 倍的 T5-Large 更早收敛。
- 墙上时间:在真实训练时间上,Switch-Base 相比 T5-Large 依然取得了 2.5 倍的加速比。
- FLOPs 劣势下的反超:
4. Designing Models with Data, Model, and Expert-Parallelism
- 随意增加专家数量会导致边际收益递减;
- 增加 \(d_{model}\) 或 \(d_{ff}\) 则同时增加了参数量与 FLOPs,并可能需要引入模型并行。
相关符号定义:
| 符号 (Term) | 说明 (Description) |
|---|---|
| \(B\) | Batch 中的 Token 总数 (Number of tokens in the batch) |
| \(N\) | 计算核心/卡数总数 (Number of total cores) |
| \(n\) | 数据并行分片数 / 数据并行度 (Number of ways for data-parallelism sharding) |
| \(m\) | 模型并行分片数 / 模型并行度 (Number of ways for model-parallelism sharding) |
| \(E\) | Switch 层中的专家总数 (Number of experts in Switch layers) |
| \(C\) | 专家容量,即单个专家可处理的 Batch 大小 (Expert capacity, the batch size of each expert) |
Data & Model Parallel 切分示意图:
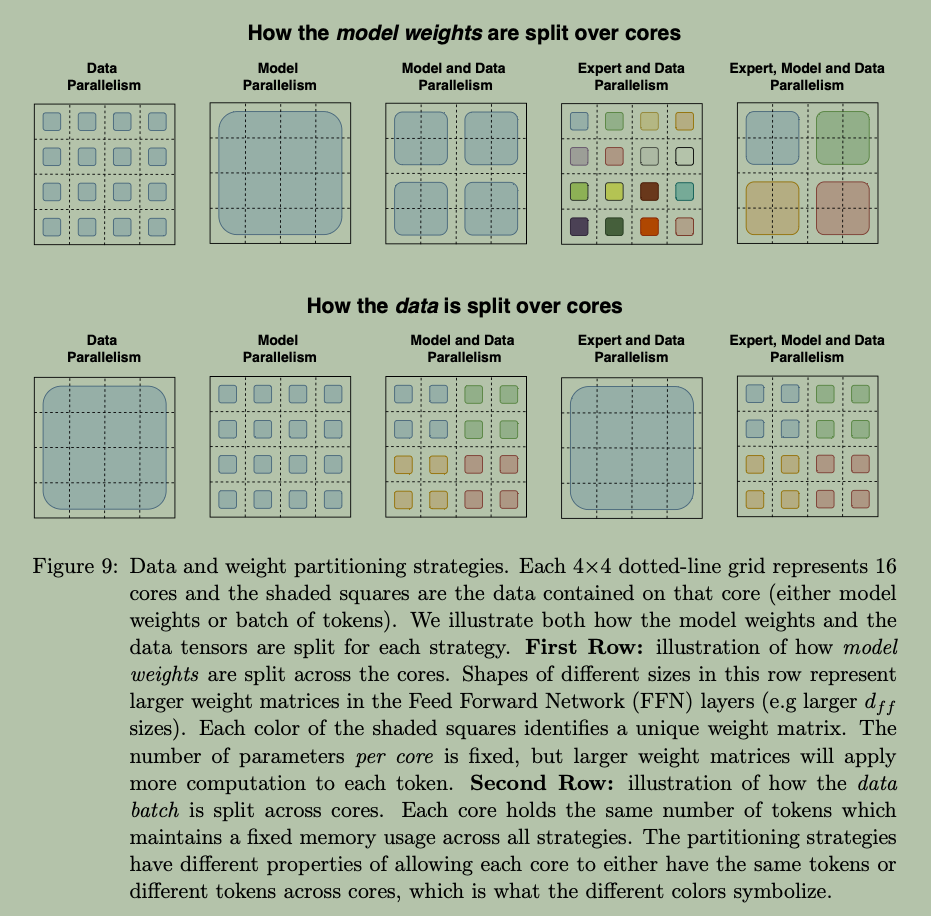
4.1 Data Parallelism
只设置 DP 时,\(n = N, m = 1\) ,对应上图最左列:
- 第一行(模型权重切分):在多个 cores 上复制(权重完全相同);
- 第二行(数据切分):不同 core 输入 tokens 不同。
4.2 Model Parallelism
只设置模型并行 MP,即 \(n = 1, m = N\) ,每个 core 输入相同,但是保有模型权重的不同切片。forward/backward 时都需要通信。
4.3 Model and Data Parallelism
同时设置 DP 和 MP,即:\(N = n \times m\) 。此时每个 core 负责 \(\frac{B}{n}\) 个 tokens 输入;权重和中间激活值的 \(\frac{d_{ff}}{m}\) 部分。在前向和反向传播过程中,每个核心都会在 All-Reduce 操作中通信一个形状为 \([B/n, d_{model}]\) 的张量。
4.4 Expert and Data Parallelism
DP + EP,不同 core 的 Expert 权重不同(Router 权重在不同 core 上相同),输入数据也不同。
MoE forward/backward All2All 通信示例说明
- Setting:
- 拓扑:
- Rank 0:持有 Expert 0 和本地 Batch 数据 Token \(T_1, T_2\)
- Rank 1:持有 Expert 1 和本地 Batch 数据 Token \(T_3, T_4\)
- 前向路由结果(Router 决策):
- \(T_1 \to \text{Expert 0}\)(本地计算)
- \(T_2 \to \text{Expert 1}\)(需要跨卡发往 Rank 1)
- \(T_3 \to \text{Expert 0}\)(需要跨卡发往 Rank 0)
- \(T_4 \to \text{Expert 1}\)(本地计算)
- 拓扑:
- forward 过程:
- 本地 Router 计算:Rank 0 算出 \(T_1, T_2\) 的门控概率;Rank 1 算出 \(T_3, T_4\) 的门控概率。
- FWD 通信 1(All-to-All Dispatch):
- Rank 0 将 \(T_2\) 发给 Rank 1;Rank 1 将 \(T_3\) 发给 Rank 0。
- 本地 Expert FFN 计算:
- Rank 0 (Expert 0):计算 \(T_1, T_3\) 的 FFN 输出。
- Rank 1 (Expert 1):计算 \(T_2, T_4\) 的 FFN 输出。
- FWD 通信 2(All-to-All Combine):
- Rank 1 将 \(T_2\) 的计算结果发还给 Rank 0;Rank 0 将 \(T_3\) 的计算结果发还给 Rank 1。
- 本地融合与门控点乘:Rank 0 融合 \(T_1, T_2\) 输出;Rank 1 融合 \(T_3, T_4\) 输出,进入下一层。
- backward 过程:当梯度从 Loss 一路传回到 MoE
层的输出端时,Rank 0 拿到针对 \(T_1,
T_2\) 的输出梯度 \(\nabla Y_1, \nabla
Y_2\);Rank 1 拿到针对 \(T_3,
T_4\) 的输出梯度 \(\nabla Y_3, \nabla
Y_4\)。
- 链式求导与局部门控梯度计算(Local Rank Compute):
- 在 Rank 0 上,\(\nabla Y\) 乘以本地 Router 的概率标量,同时求出 Router 概率本身的梯度分支 \(\nabla P_{\text{router}}\)。
- BWD 通信 1(All-to-All - 逆演 FWD Combine):
- 目的:将 FFN 节点的输出梯度发还给真正执行该计算的 Expert 所在 Rank。
- 动作:Rank 0 将 \(T_2\) 的梯度 \(\nabla Y_2\) 发往 Rank 1;Rank 1 将 \(T_3\) 的梯度 \(\nabla Y_3\) 发往 Rank 0。
- Expert FFN 梯度计算(Local Expert FFN Bwd):
- Rank 0 (Expert 0) 收到 \(T_1, T_3\) 的梯度:
- 计算权重梯度:算出 \(\nabla W_{\text{Expert 0}}\)(更新本地 Expert 0 权重,仅本地累加,无需跨卡 All-Reduce)。
- 计算输入激活梯度:算出针对输入特征的梯度 \(\nabla X_1^{\text{in}}, \nabla X_3^{\text{in}}\)。
- Rank 1 (Expert 1) 收到 \(T_2, T_4\) 的梯度:
- 计算权重梯度:算出 \(\nabla W_{\text{Expert 1}}\)。
- 计算输入激活梯度:算出 \(\nabla X_2^{\text{in}}, \nabla X_4^{\text{in}}\)。
- Rank 0 (Expert 0) 收到 \(T_1, T_3\) 的梯度:
- BWD 通信 2(All-to-All - 逆演 FWD Dispatch):
- 目的:将计算好的特征激活梯度送回 Token 原始所属的 Rank。
- 动作:Rank 1 将 \(\nabla X_2^{\text{in}}\) 发回给 Rank 0;Rank 0 将 \(\nabla X_3^{\text{in}}\) 发回给 Rank 1。
- Router 与 Attention 梯度计算(Local Router & Pre-Layers
Bwd):
- Rank 0 拿到了属于本地 Token \(T_1, T_2\) 的完整激活梯度,结合第一步算出的 Router 分支梯度,求出对本地 Router 权重 \(W_r\) 的梯度分量 \(\nabla W_r^{(0)}\)。
- 激活梯度继续向后传递给本地的 Self-Attention 和 LayerNorm。
- 参数同步(All-Reduce for DP / Router):
- 在 Step 结束更新参数前,全局对 DP 复制的参数(如 Router 权重 \(W_r\) 和 Self-Attention 权重)执行 All-Reduce 求和同步,而 Expert 权重 \(\nabla W_{\text{Expert}}\) 保持本地更新。
- 链式求导与局部门控梯度计算(Local Rank Compute):
4.5 Expert, Model and Data Parallelism
当同时混用三种并行范式(DP + EP + 每个 Expert 的 MP)时,系统会面临极度复杂的双重通信叠加:
- 专家路由通信(All-to-All):来自专家并行(EP),负责将 Token 跨设备分发给对应的专家 Core。
- 隐层特征规约通信(All-Reduce):来自模型并行(MP),在每层 FFN 前向和反向传播中,需要对被切分的 \(d_{ff}\) 隐层求和。
在单 Core 显存上限、单 Token FLOPs、All-to-All 网络带宽以及 All-Reduce 延迟之间寻找最佳平衡点变得极其困难,最匹配的切分映射通常需要通过工程实测(Empirically determined)来确定。
4.6 Towards Trillion Parameter Models
两个大规模模型:395B 和 1571B 模型超参数和实验结果:
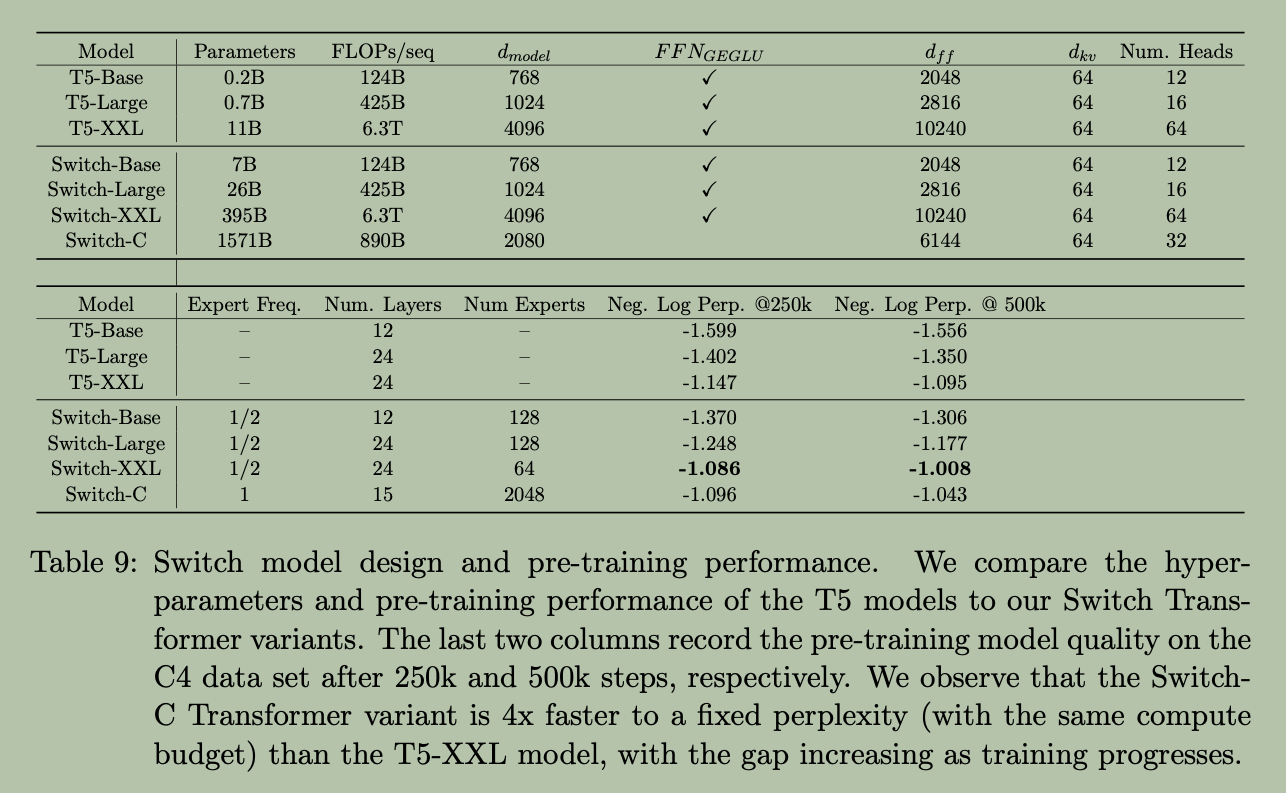
- Switch-C(纯专家并行路线):
- 设计:放弃模型并行(MP=1),完全依赖专家并行(EP+DP)。因此其骨架维度较窄(\(d_{model}=2080\)),单 Token FLOPs 仅为 T5-XXL 的 14%。
- 优势:避开了模型并行的跨卡 All-Reduce 通信,在训练 2048 个专家、1.6 万亿参数的全过程中展现出极佳的稳定性,未出现任何训练发散崩溃。
- Switch-XXL(高 FLOPs 混合路线):
- 设计:单 Token FLOPs 与 T5-XXL 完全对齐(6.3T),采用了专家并行 + 模型并行 + 数据并行(EP+MP+DP)的三维混合切分。
- 权衡:拥有极高的计算密度与单步收敛效率,但受限于超高
FLOPs、大维度与低精度(
bfloat16)的叠加,训练过程中偶发稳定性问题。
5. Conclusion
- Switch Transformer
- 简化 MoE Top-K 取值 1;
- bf16 训练(Selective Precision);
- 训练并行策略(DP + EP + MP);