DeepSpeed-MoE: Advancing Mixture-of-Experts Inference and Training to Power Next-Generation AI Scale
- DeepSpeed-MoE: Advancing Mixture-of-Experts Inference and Training to Power Next-Generation AI Scale
- arXiv 提交日期:14 Jan 2022(发表于 ICML 2022)
- 代码:DeepSpeed
- 作者:
摘要
随着当下超大密集模型(Dense Models)的训练逐渐触及硬件资源供给与能力的极限,混合专家模型(Mixture-of-Experts, MoE)凭其相比同等质量密集模型大幅降低训练成本的优势,成为了最具前景的模型架构之一。从早期工作在编码器-解码器(Encoder-Decoder)模型上的验证,到本论文及同期探索在自回归语言模型(Auto-Regressive Language Models)上实现的 5 倍训练成本节省,MoE 的训练效率已被充分证实。 然而,由于 MoE 架构参数总量极为庞大且结构特殊,如何提供高速的 MoE 模型推理依然是一个极具挑战且尚未解决的难题,严重阻碍了其工程落地。
为了攻克这一瓶颈,我们推出了 DeepSpeed-MoE——作为 DeepSpeed 框架的一部分,它提供了端到端的 MoE 训练与推理完整解决方案:1)架构与压缩创新:提出全新的 MoE 架构设计与模型压缩技术,将 MoE 模型参数量最大压缩 3.7 倍。2)推理系统优化:构建了高度优化的分布式推理系统,相比现有的 MoE 推理方案,实现了 7.3 倍的延迟降低与成本节省。
相比同等质量的密集模型,DeepSpeed-MoE 能够以前所未有的规模和效率运行海量 MoE 模型,推理速度提升高达 4.5 倍,部署成本降低 9 倍。我们希望本论文的技术创新与系统实现能为大模型领域开辟一条清晰的新路径,加速推动行业从密集模型向稀疏 MoE 模型转型,让使用更少资源训练和部署更高质量的模型成为可能。
1. Introduction
- 背景:同样是老生常谈的:扩展 Dense 模型所需的算力要求过高,需要一种模型结构,能够在相同的模型质量下,需要更少的计算,也就是:MoE 模型。但是,MoE 模型在当时(2022 年)主要在 Encoder-Decoder 架构和序列到序列任务上被验证了有效性,没有在自回归的 Decoder-only 模型上被探索过。
- MoE 模型本身存在的 问题:
- 内存要求过大:MoE 模型参数量过大,但是参数效率较低,部分任务上大参数量 MoE 模型性能不如参数更小的 Dense 模型,且大参数量导致了庞大的内存需求,导致训练和推理性能低下。
- 推理性能有限:
- 参数量大带来了多 GPU 推理需求,但是多 GPU 推理技术没有专门针对 MoE 模型优化;
- 推理经常是内存带宽受限的,MoE 模型由于参数量大,对内存带宽需求也更高。
- 本文提出的 解决方案:
- 扩展 MoE 模型到自回归的 NLG(Natural Language Generation)任务,并证明了在相同模型质量前提下,MoE 模型对比 Dense 模型训练成本减少 5 倍;
- 提出新的 Pyramid-Residual MoE (PR-MoE) 模型架构,提高了 MoE
模型参数效率;
- PR-MoE(Pyramid-Residual MoE):结合金字塔结构(仅在最有效的深层配置较多专家)与残差结构(固定 Dense MLP 主干 + 动态残差专家),在不损伤模型质量前提下将参数量削减高达 3 倍。
- MoS(Mixture-of-Students):提出阶段性知识蒸馏(Staged Knowledge Distillation),将 PR-MoE 模型进一步压缩高达 3.7 倍。
- 开发了 DeepSpeed-MoE 推理系统,针对 MoE
模型推理专门优化,能够在几百张 GPUs 进行高效的推理;
- 相比现有 MoE 推理方案实现了 7.3 倍的延迟降低与成本缩减,将万亿参数 MoE 的推理延迟压低至 25ms 以内。
- 结合模型与系统优化,比同等质量的 Dense 模型推理快 4.5 倍、便宜 9 倍。
2. DeepSpeed-MoE for NLG: Reducing the Training Cost of Language Models by 5 Times
2.1 MoE based NLG Model Architecture
- 基于 Decoder-only Transformer 模型结构(类似于
GPT),每隔一层 用 MoE 替换 FFN;
We use “350M+MoE-128” to denote a MoE model that uses 350M dense model as the base model and adds 128 experts on every other feedforward layer. That is to say, there are in total 12 MoE layers for both 350M+MoE-128 and 1.3B+MoE-128.
- Router 仅选择的一个 expert(Top-K 取值为 1);
- 每 token 激活参数量与 Dense 模型保持一致;
2.2 Training and Evaluation Settings
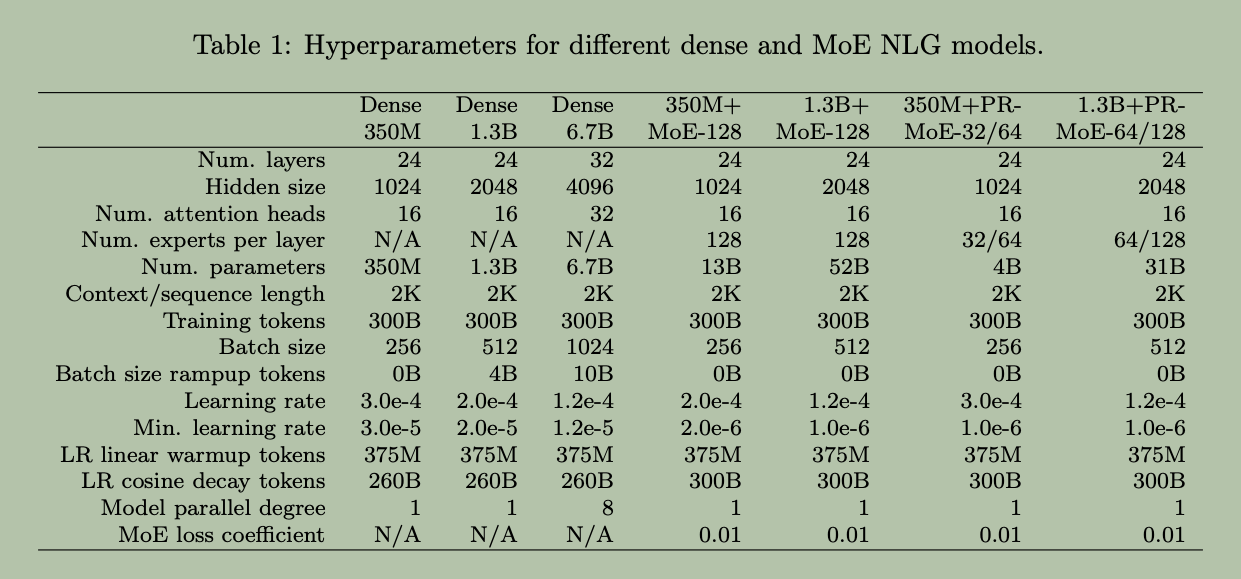
- 硬件与算力规模:在 128 张 NVIDIA Ampere A100 GPU 上,使用统一的 300B Tokens 训练集(MT-NLG 数据集)分别训练 Dense 与 MoE 模型。
- 超参数拟合:鉴于 MoE 总参数量远大于 Dense 模型,论文发现使用更低的初始学习率和更长的衰减周期能显著提升收敛效果。
- 评测维度:不仅比较预训练阶段的 Token-wise 验证集 Loss,还在 6 个经典的零样本下游任务上验证泛化能力,包括补全预测(LAMBADA)、常识推理(PIQA)、阅读理解(BoolQ, RACE-h)以及问答(TriviaQA, WebQs)。
2.3 MoE Leads to Better Quality for NLG Models
主要结论:
- MoE 模型验证 loss 下降曲线比 Dense 模型更快(相同训练 tokens loss
更小);
- MoE 模型达到相同验证 loss,激活参数量仅需相同验证 loss 的 Dense 模型的四分之一到五分之一;
- 下游零样本任务性能结论,与验证 loss 结论整体一致;
- 对比之前已有 MoE 工作,本文提出方法达到相同模型质量所需参数更少,即参数效率更高。
2.4 Same Quality with 5x Less Training Cost
- 等量 FLOPs,更高质量:由于 Top-1 路由使单 Token 计算 FLOPs 与 1.3B
Dense 基本持平,
1.3B+MoE-128实际上是以 1.3B 的训练算力达到了 6.7B Dense 的模型质量,实现了 5 倍的有效计算量削减。 - 实测吞吐提升:在 128 张 A100 GPU 上,
6.7B Dense的训练吞吐为 70 samples/sec,而1.3B+MoE-128达到了 372 samples/sec,实现了 5 倍的实测训练吞吐提升与成本节省。
3. PR-MoE and MoS: Reducing the Model Size and Improving Parameter Efficiency
前一节证明了 MoE 模型在相同模型质量下,训练成本方面的优势。但是,由于 MoE 模型参数量巨大,在推理时对 GPU 显存大小和带宽的需求仍然很大。本届研究解决的问题是:如何减少 MoE 模型的参数规模,提升参数效率?
- PR-MoE 模型架构:相同模型质量下,模型参数量减少 3 倍。
- Mixture-of-Students (MoS) 知识蒸馏:从训练好的 PR-MoE 模型中蒸馏,以进一步减小模型规模,优化推理成本和耗时。
3.1 PR-MoE: Pyramid-Residual-MoE for Smaller Model Size and Fast Inference
- 观察与动机:
- 现象一:深层网络更受益于多专家
- 直觉灵感:借鉴计算机视觉(CV)领域“浅层学习通用表征、深层学习特定目标表征”的规律。
- 验证实验:对比将 MoE
层仅放在前半段(
First-Half-MoE)与仅放在后半段(Second-Half-MoE)的表现。 - 结论:
Second-Half-MoE的效果显著优于First-Half-MoE,证明 Transformer 深层比浅层更需要大量专家分流。因此没必要在所有层均匀平铺专家,浅层减少专家数量即可形成金字塔结构(Pyramid-MoE)。
- 现象二:固定主干 + 动态残差可替代 Top-2 路由
- 直觉灵感:传统 Top-2 路由(每个 Token 传给 2
个专家)虽然精度高,但 All-to-All 通信量翻倍。 Top-2
的本质是用第二个专家去修正第一个专家的输出。
- 后续 DeepSeekMoE shared expert 的直接来源。
- 本文从工程视角出发(减少 All2All 通信量);而 DeepSeekMoE 从算法视角出发(组合数增长 & 通用知识交给共享专家学习以提升路由专家专业化)。
- 验证实验:对比动态 Top-2
路由(
Top2-MoE)与“固定 1 个共享 Dense MLP + 动态选 1 个 Top-1 专家”的残差结构(Residual-MoE)。 - 结论:两者泛化精度完全对齐,但
Residual-MoE仅产生 Top-1 级别的通信量,训练耗时缩短了 10% 以上。
- 直觉灵感:传统 Top-2 路由(每个 Token 传给 2
个专家)虽然精度高,但 All-to-All 通信量翻倍。 Top-2
的本质是用第二个专家去修正第一个专家的输出。
- 现象一:深层网络更受益于多专家
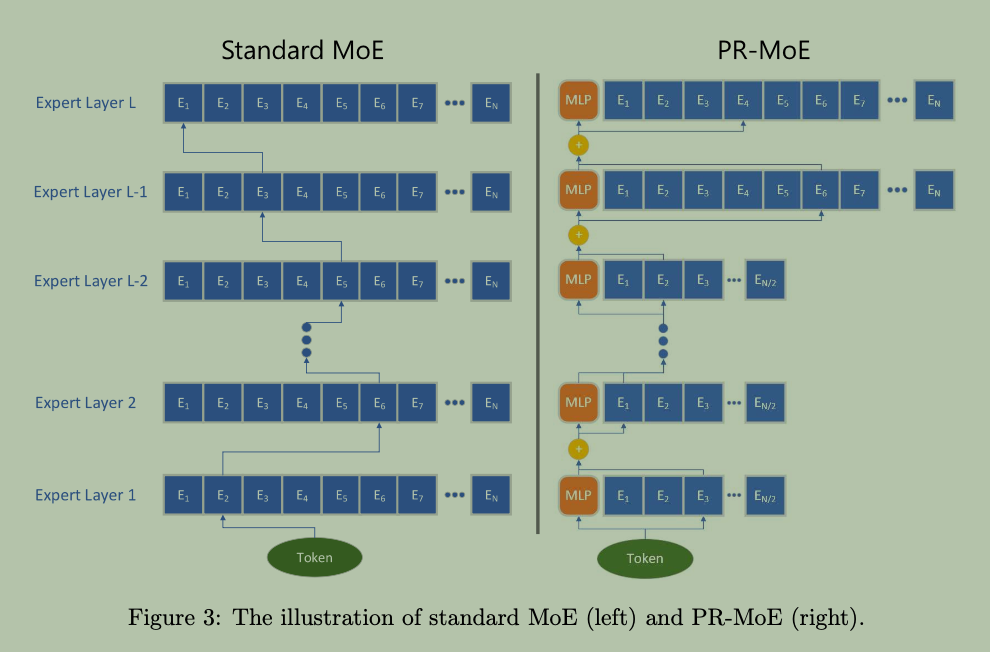
- 模型结构:如上图右侧所示,结合 Pyramid 与 Residual 设计:
- 浅层配置少专家(如 32/64),深层配置多专家(如 64/128);
- 每层均为“共享 Dense MLP + 动态 Top-1 专家”的残差并行结构。
- 系统设计:
- 问题:PR-MoE 各层专家数量不同,传统固定专家并行度(Expert Parallelism, EP)会导致 GPU 算力不均(设置 EP 为最大专家数时)或显存溢出(设置 EP 为最小专家数时);
- Solution:
- DeepSpeed-MoE 拓展了多专家与多数据并行(Multi-Expert & Multi-Data Parallelism),例如 128 张 GPU 运行 EP={32, 64, 128} 配合 DP={4, 2, 1},确保每张 GPU 恰好处理 1 个专家,消除负载不均并保持极致训练效率。
- 实验效果:
- 参数量削减:
350M+PR-MoE-32/64(4B 参数)达到了与350M+MoE-128(13B 参数)相当的精度,参数量减少至不到 1/3。1.3B+PR-MoE-64/128(31B 参数)对比1.3B+MoE-128(52B 参数),参数量仅为原来的 60%,下游任务精度持平甚至略有提升。
- 参数量削减:
3.2 Mixture-of-Students: Distillation for Even Smaller Model Size and Faster Inference
- Student 模型架构:
- 保持 MoE 稀疏结构:以往研究多将 MoE 蒸馏为 Dense 模型(丢失了 MoE 推理的稀疏计算优势)。MoS 保持 Teacher 和 Student 均为 PR-MoE 架构,仅将 Student 的专家分支深度进行缩减(如从 24 层缩减至 21 层,深度减少 12.5%)。
- 阶段知识蒸馏:
- 现象发现:实验发现,如果在整个预训练过程持续进行蒸馏(Full KD),Student 的精度反而不如从头训练的 Student。
- 原因分析:PR-MoE 已经大幅压缩了容量,进一步缩减层数后 Student 处于容量受限(Underfitting)状态。训练后期同时优化硬标签交叉熵(CE)与 Teacher 软标签(KL 散度)会让模型顾此失彼。
- 解决方案(Staged KD):在前 400K 步同时使用 CE 损失和 KL 散度蒸馏引导;400K 步后停止蒸馏损失,仅使用硬标签语言模型损失继续优化。
- 实验效果:
- 精度无损保留:采用 Staged KD 后,21 层的 Student
模型(
3.5B与27B参数)保留了 Teacher 模型(4B与31B)99.5% 和 99.1% 的下游任务精度。 - 累积压缩收益:PR-MoE 与 MoS 结合后,将原始 52B 的 MoE 模型压缩至 27B,整体模型尺寸降至 1/3.7,显著降低了推理显存占用与显存读取开销。
- 精度无损保留:采用 Staged KD 后,21 层的 Student
模型(
4. DeepSpeed-MoE Inference: Serving MoE Models at Unprecedented Scale and Speed
- 推理阶段 batch size
通常较小,因此推理时延主要取决于从内存加载模型权重的耗时。因此,推理性能主要取决于以下两个因素:
- 模型大小(the overall model size)
- PR-MoE 模型架构与 MoS 蒸馏。
- 内存带宽(the overall achievable memory bandwidth)
- 开发多 GPU 推理系统,最大化多卡聚合内存带宽以加速推理。
- 模型大小(the overall model size)
4.1 Design of DeepSpeed-MoE Inference System
MoE 模型推理特性:
- 最佳视角(Best-case):对于单 Token(Top-1 路由),它在每一层仅激活 1 个专家,其关键计算路径(Critical Data Path)仅相当于基底 Dense 模型的大小(例如 1.3B+MoE-128 模型中,每个 Token 仅触发 1.3B 参数的计算)。
- 最坏视角(Worst-case):在一个 Batch(例如一个 Sentence 或 Paragraph)中,不同 Token 会激活不同的专家,导致整卡/集群依然需要将全部 520 亿(甚至万亿)参数完整加载进显存。由于推理本质上是显存带宽受限(Memory Bandwidth Bound)的,频发的数据读取使得传统系统的推理速度极其缓慢。
DeepSpeed-MoE 推理系统核心设计目标:通过多维并行分发与通信协同,将整机的实际推理性能全面推向“最佳视角”。具体优化技术:
- Token 路由与分组聚合:将具有相同计算路径(目标专家)的 Token 组合在一起,减少单设备的数据重组开销。
- 并行协同通信调度:针对不同并行策略重叠并优化 All-to-All 通信。
- 算子/Kernel 级融合:优化 Transformer 和 MoE 相关算子以提升单设备计算效率。
4.2 Flexible Combination of Tensor-Slicing, Expert-Slicing, Data Parallelism, and Expert Parallelism
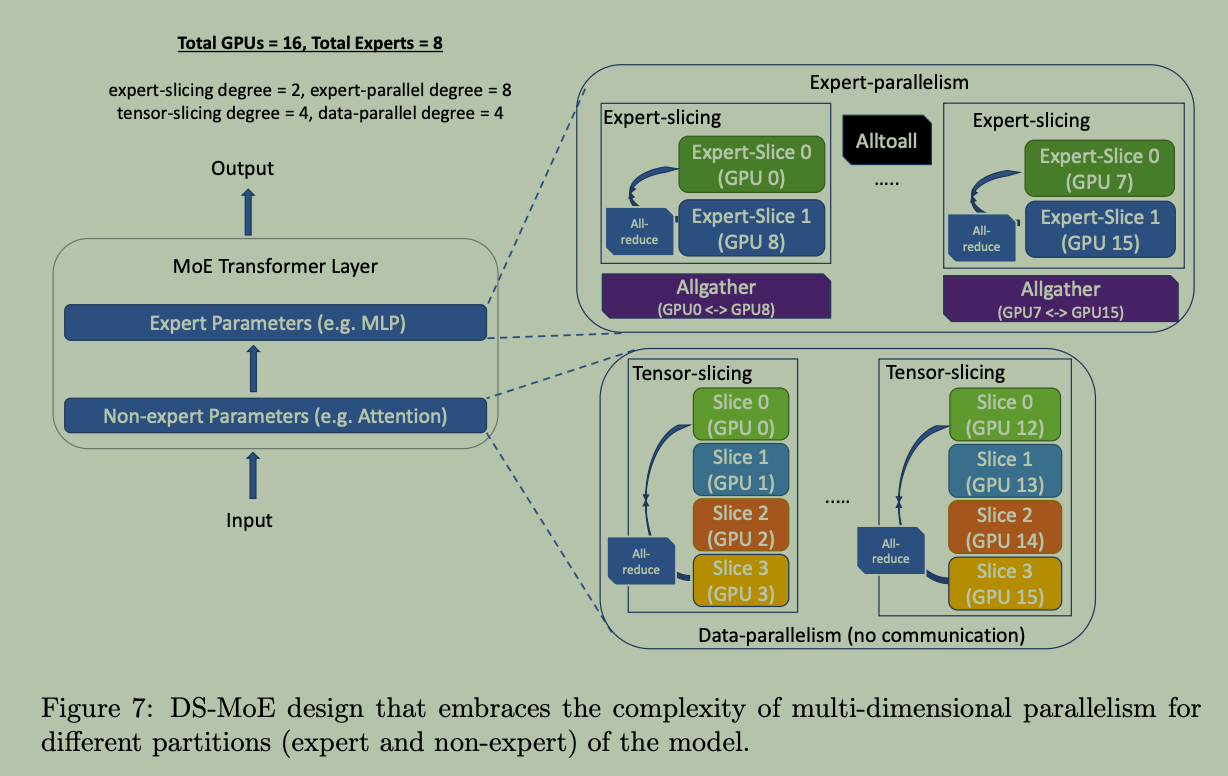
- 同时使用以下并行技术
- EP 与 expert 参数切分
- 专家并行(Expert Parallelism, EP):将 128 个专家分散部署在不同的 GPU 上,使得每张 GPU 仅需加载和处理发往本卡专家的 Token 组。
- 专家切片(Expert-Slicing):在延迟极度敏感的场景下,将单个专家内部的权重矩阵进一步沿行列切分到多张 GPU 上(类似张量并行)。
- DP 与非 expert Tensor 切分(TP)
- 张量切片(Tensor-Slicing, TP):在单节点内利用 NVLink 的高带宽,将 Attention 矩阵切分到组内 GPU,避免单卡显存装不下超大非专家参数。
- 数据并行(Data Parallelism, DP):在跨节点间使用 DP 复制非专家参数,避免跨节点张量并行带来的高昂通信延迟。
- EP 与 expert 参数切分
4.3 Optimized Communication Subsystem: Grouping and Routing Tokens More Efficiently
标准 Top-1 路由依赖 All-to-All 全局跨卡通信,随着 GPU
节点增加,通信开销呈线性 \(O(p)\)
增长(\(p\) 为 EP,即 EP Group 内 GPU
数量),成为严重瓶颈。针对这个问题,进行以下两点优化:
- Hierarchical All-to-all
- Parallelism Coordinated Communication Optimization
Hierarchical All-to-all
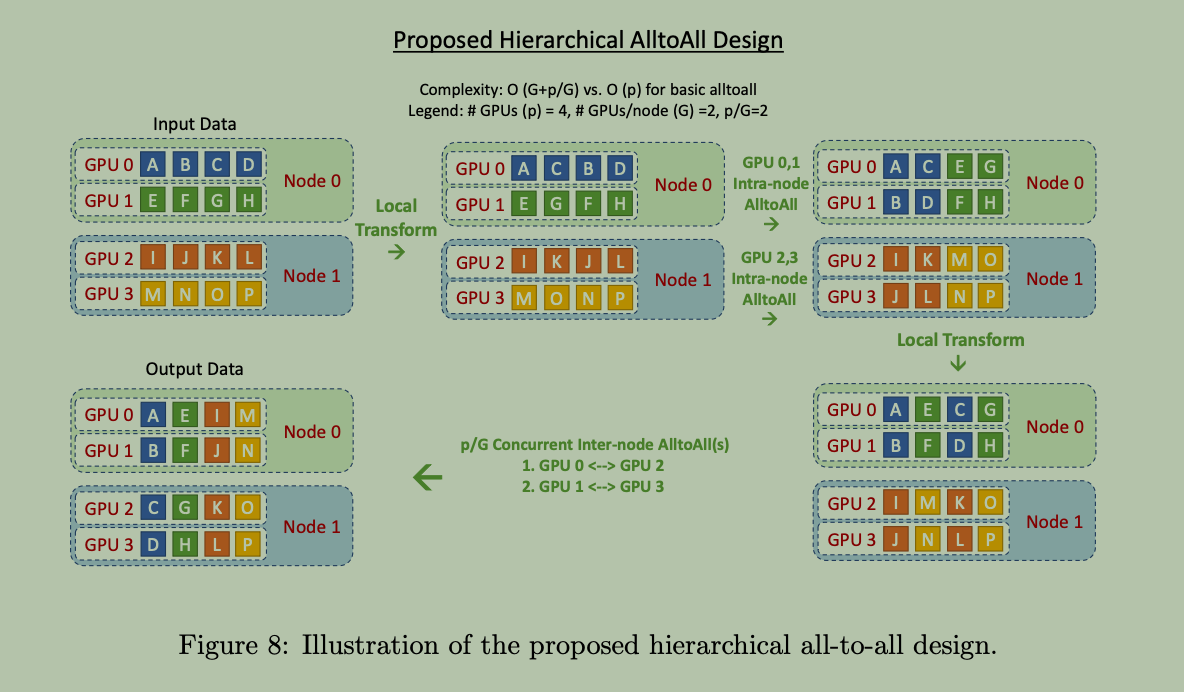
- 采用“节点内 All-to-All \(\rightarrow\) 跨节点 P2P 传输 \(\rightarrow\) 节点内 All-to-All”的两阶段树状算法。将通信 Hop 复杂度从 \(O(p)\) 降低为 \(O(G + p/G)\)(其中 \(G\) 为单节点 GPU 数,\(p\) 为总卡数),显著降低了小 Batch 场景下的网络延迟。
Parallelism Coordinated Communication Optimization
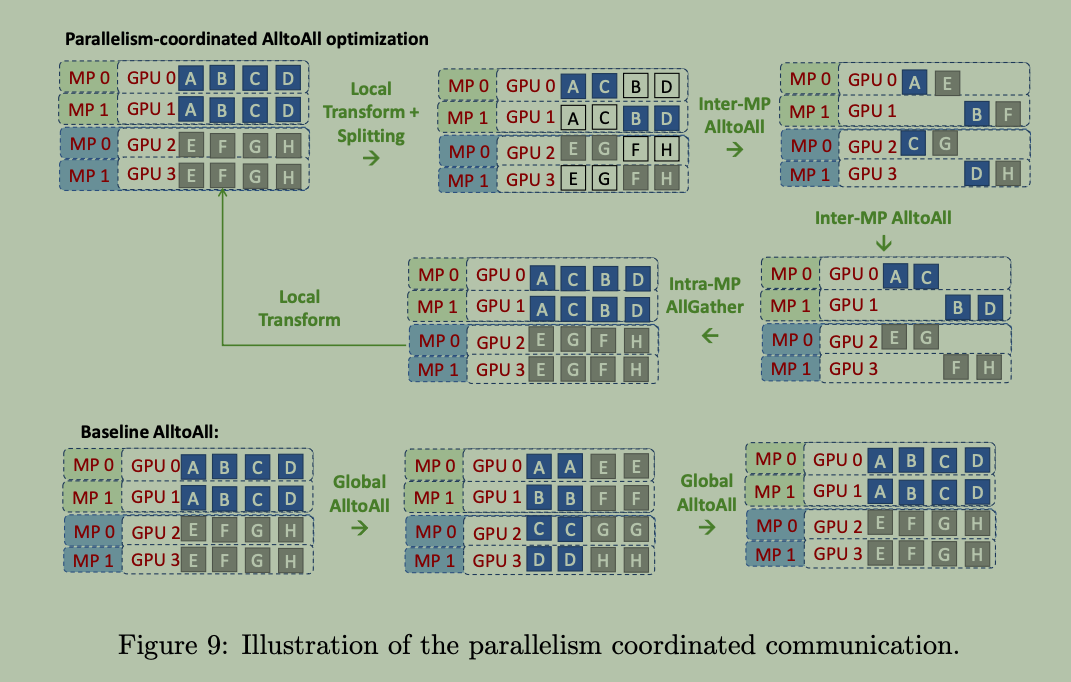
- 利用张量并行(TP)在组内复制数据的特性,打破以往将并行模式视为黑盒的传统。在前向传输时,只在共享相同
TP Rank 的设备子集中发起 All-to-All 路由;计算完成后再执行组内
All-Gather 补充数据。
- 通信延迟上限直接从 \(O(p)\) 降至 \(O(p/L)\)(\(L\) 为张量并行度)。以 128 张 GPU 配合 8-way TP 为例,跨卡通信范围直接从 128 张卡缩小到 16 张卡。
上图解释说明:
- Step 1: 本地转换与拆分(Local Transform & Splitting):
- GPU 0 和 GPU 1 不再全网乱发,而是分工协作:
- GPU 0(MP 0):只提取并负责分发发往 MP 0 梯队(GPU 0, GPU 2) 的 Token。
- GPU 1(MP 1):只提取并负责分发发往 MP 1 梯队(GPU 1, GPU 3) 的 Token。
- Step 2: 组内路由(Inter-MP AlltoAll)
- 此时,原本混乱的全局 All-to-All 被切割为两个互相独立的子通信组:
- 子组 1(MP 0 组):仅在
GPU 0和GPU 2之间进行 All-to-All 通信。 - 子组 2(MP 1 组):仅在
GPU 1和GPU 3之间进行 All-to-All 通信。 - 效果:单次通信的参与卡数从原本的 4 张卡直接折半降低到了 \(p/L = 4/2 = 2\) 张卡。
- Step 3: 专家 MLP 前向计算
- 4 张 GPU 分别调用各自本地的 Expert 计算前馈结果。
- Step 4: 结果聚合与回传(Inter-MP AlltoAll + Intra-MP AllGather)
- 计算完成后,输出需要返回给下一个 Attention/TP 层:
- 先做一次 Inter-MP AlltoAll,把专家计算结果发回给刚才负责它的 GPU。
- 此时,
GPU 0只有发给 MP 0 的结果,GPU 1只有发给 MP 1 的结果。 - 最后,在 TP 组内部(GPU 0 与 GPU 1 之间、GPU 2 与 GPU 3 之间)执行一次极快的组内 AllGather(Intra-MP AllGather),互相补齐数据,完美恢复下一个 TP 层所需的全量输入。
4.4 Highly Optimized Transformer and MoE Related Kernels
传统的 MoE 门控路由和 Token 重排依赖于稀疏-密集矩阵乘法(Sparse-Dense Einsum),其算子复杂度高达 \(\mathcal{O}(S \times E \times M \times c_e)\),(其中,\(S, E, M\) 分别表示序列长度、专家数量、隐藏层维度,\(c_e\) 表示专家容量,通常较小)其中大量计算都在与零相乘(零乘法冗余)。
优化方法:
- Gating 内核融合:将 Top-k 选择、基于 Blelloch Scan 算法的 GPU 并行前缀和(Cumsum)计算以及 Scatter 映射融合至单个 C++/CUDA Kernel,显式生成 Token-to-Expert 密表征映射表(Mapping Table)。
- 数据布局变换(Layout Transformation):摒弃掩码矩阵与稀疏 Einsum,直接利用映射表对内存地址进行显式重排(Sort & Re-order)。
- 复杂度降维:将算子复杂度从 \(\mathcal{O}(S \times E \times M \times c_e)\) 直接削减至 \(\mathcal{O}(S \times M \times c_e)\),与专家数 \(E\) 完成解耦,使算子相关延迟降低了 6 倍以上。
4.5 Performance Evaluation of DS-MoE Inference
在最高 256 张 A100 GPU 集群上的实测数据表明:
- 同时实现低延迟与超线性(Super-Linear)吞吐扩展: 在 Dense 模型中,增加 GPU 做模型并行虽然能降低延迟,但通信开销会导致单卡吞吐下降。但在 DS-MoE 中,随着 GPU 数量增加(如从 8 卡扩到 64 卡),单 GPU 承担的专家数减少(从 16 个降至 2 个),数据局部性(Data Locality)大幅提升,使得单卡吞吐量随卡数增加反而上升,表现出独特的超线性扩展能力。
- 前所未有的部署规模: 相比 PyTorch Baseline 实现了 7.3 倍的延迟降低与吞吐提升;在 256 张 GPU 上,万亿(1 Trillion)参数规模的 MoE 模型推理延迟被压低至 25ms 以内。
- 与 PR-MoE / MoS 压缩叠加: 使部署 349B 规模 MoE 模型所需的最少硬件资源减少了一半(从 32 张 A100 减少到 16 张 A100)。
- 彻底逆转对同等质量 Dense 模型的推理劣势: 在传统框架下,MoE 推理比 Dense 模型更慢更贵。而结合了系统与架构优化的 DS-MoE 彻底翻转了这一局面——对于 1.5 万亿参数的 MoE(对标 175B GPT-3 密集模型),实现了 4.5 倍更快的推理速度,以及 9 倍更低的部署成本。
5. Looking Forward to the Next Generation of AI Scale
- DeepSpeed MoE
- PR-MoE & MoS
- Inference Optimization
- Communication
- Hierarchical All2All
- Parallelism Coordinated Communication Optimization
- Kernel
- Fused Gating related kernel
- Sparse GEMM -> Dense GEMM
- Communication