DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models
- DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models
- arXiv 提交日期:11 Jan 2024
- GitHub:DeepSeek-MoE
- 作者:
摘要
在大语言模型时代,混合专家(MoE)架构是在扩展模型参数规模时控制计算成本的一项极具前景的架构。然而,像 GShard 这样在 \(N\) 个专家中激活 Top-\(K\) 个专家的传统 MoE 架构,在确保专家专业化(即让每个专家获取互不重叠且高度聚焦的知识)方面面临着严峻挑战。
为此,我们提出了旨在实现极致专家专业化的 DeepSeekMoE 架构。该架构主要包含两大策略:1)细粒度专家分割:将专家细分为 \(mN\) 个并从中激活 \(mK\) 个,从而实现更灵活的激活专家组合;2)共享专家隔离:隔离出 \(K_s\) 个专家作为共享专家,专门捕获通用知识并减少路由专家中的参数冗余。
从 2B 参数的小规模实验开始,我们证明了 DeepSeekMoE 2B 取得了与 GShard 2.9B 相当的性能,而后者的专家参数量和计算量是前者的 1.5 倍。此外,DeepSeekMoE 2B 极度逼近了相同总参数量下 Dense 稠密模型的性能表现(这设定了 MoE 模型的理论性能上限)。随后,我们将 DeepSeekMoE 扩展到 16B 参数,结果表明其仅需约 40% 的计算量即可达到与 LLaMA2 7B 相当的性能。进一步地,我们在将 DeepSeekMoE 扩展至 145B 参数的初步尝试中,持续验证了其相比 GShard 架构的显著优势,并且仅需 28.5%(甚至可能低至 18.2%)的计算量即可取得与 DeepSeek 67B 媲美的性能。
1. Introduction
- 已有 MoE 模型存在的问题:knowledge hybridity and knowledge
redundancy, which limit the expert specialization, i.e., each expert
acquires non-overlapping and focused knowledge.
- Knowledge Hybridity:现有的 MoE 实践通常只设置较少数量的专家(如 8 个或 16 个),因此分配给某个特定专家的 token 往往涵盖多种不同的知识。这迫使该专家在其参数中容纳截然不同类型的知识,而这些知识很难在计算中同时发挥作用。
- Knowledge Redundancy:分配给不同专家的 token 可能会需要相同的通用知识。结果,多个专家会在各自的参数中重复学习并保留这些共享知识,从而导致专家参数的冗余。
- 这些问题共同阻碍了现有 MoE 架构实现极致的专家专业化,使其难以触及 MoE 模型的理论性能上限。
- 本文提出的解决方法:DeepSeekMoE
- Fine-Grained Expert Segmentation:保持总参数量恒定的同时,将专家在 FFN 中间隐藏层维度进行更细粒度的切分。因此,在计算量不变的情况下,通过激活更多细粒度专家实现了专家更加灵活和适应性的组合。同时允许更高程度的专家专门化。
- Shared Expert Isolation:隔离部分专家作为总是被激活的共享专家,以捕捉通用知识,同时消除了其他 routed experts 的冗余重复知识。
主要实验结果:
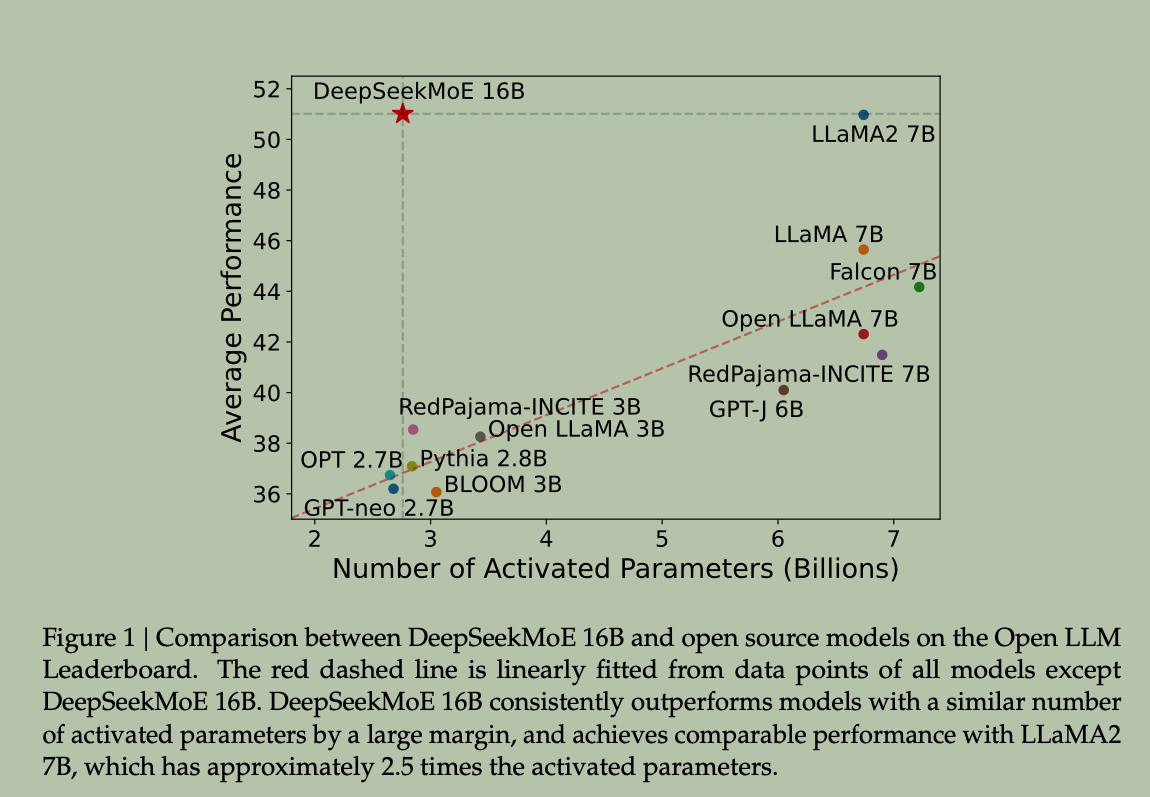
- 相同激活参数量性能更好
2. Preliminaries: Mixture-of-Experts for Transformers
标准 Transformer 模块
一个标准的 Transformer 模型由 \(L\) 层相同的 Block 堆叠而成。在每个 Block 中,输入 Token 序列经过自注意力机制(Self-Attention)和前馈网络(FFN)处理:
\[ \mathbf{u}_{1:T}^l = \text{Self-Att}(\mathbf{h}_{1:T}^{l-1}) + \mathbf{h}_{1:T}^{l-1} \]
\[ \mathbf{h}_t^l = \text{FFN}(\mathbf{u}_t^l) + \mathbf{u}_t^l \]
其中,\(\mathbf{u}_t^l \in \mathbb{R}^d\) 表示第 \(t\) 个 token 在第 \(l\) 层经过注意力模块后的隐藏状态,\(\mathbf{h}_t^l \in \mathbb{R}^d\) 表示经过 FFN 模块并叠加残差连接后的最终输出隐藏状态。
传统 MoE 模型
常规 MoE 语言模型构建方式是:按一定间隔用 MoE 层替换 Transformer 中的标准 FFN 层。
- 专家构成:一个 MoE 层由 \(N\) 个专家网络组成,每个专家的结构与标准 FFN 完全一致(即 \(\text{FFN}_i\))。
- 路由机制:门控路由模块负责将每个 token 动态分配给 \(K\) 个专家(例如 Switch Transformer 中 \(K=1\),GShard 中 \(K=2\))。
如果第 \(l\) 层的 FFN 被替换为 MoE 层,其输出 hidden state \(\mathbf{h}_t^l\) 的计算分为三步:
- 计算 token 与专家的亲和度得分(Affinity Score):
\[ s_{i,t} = \text{Softmax}_i \left( (\mathbf{u}_t^l)^T \mathbf{e}_i^l \right) \] 其中 \(\mathbf{e}_i^l\) 是第 \(l\) 层中第 \(i\) 个专家的质心向量(Centroid),通过计算隐藏向量 \(\mathbf{u}_t^l\) 与专家质心的内积,经由 Softmax 得到匹配得分。
- 稀疏门控选择(Sparse Gate Value):
\[ g_{i,t} = \begin{cases} s_{i,t}, & s_{i,t} \in \text{Topk}(\{s_{j,t} \mid 1 \leqslant j \leqslant N\}, K) \\ 0, & \text{otherwise} \end{cases} \] 使用 \(\text{Topk}\) 函数只保留得分最高的前 \(K\) 个专家的权重,未被选中的 \(N-K\) 个专家的门控值直接置 0。
- 专家输出加权求和与残差连接:
\[ \mathbf{h}_t^l = \sum_{i=1}^N \left( g_{i,t} \text{FFN}_i(\mathbf{u}_t^l) \right) + \mathbf{u}_t^l \] 只有被选中的 \(K\) 个专家会参与该 token 的前向计算,最后将结果按门控权重加权求和,并叠加残差。
门控向量 \(g_{i,t}\) 具有显著的稀疏性(Sparsity):在 \(N\) 个专家中,只有 \(K\) 个专家的门控值为非零5。这保证了即使模型总参数量随着 \(N\) 的增加大幅扩展,每个 token 实际激活的计算开销(FLOPs)依然控制在仅计算 \(K\) 个专家的较低水平。
3. DeepSeekMoE Architecture
DeepSeekMoE 模型结构如下图所示:
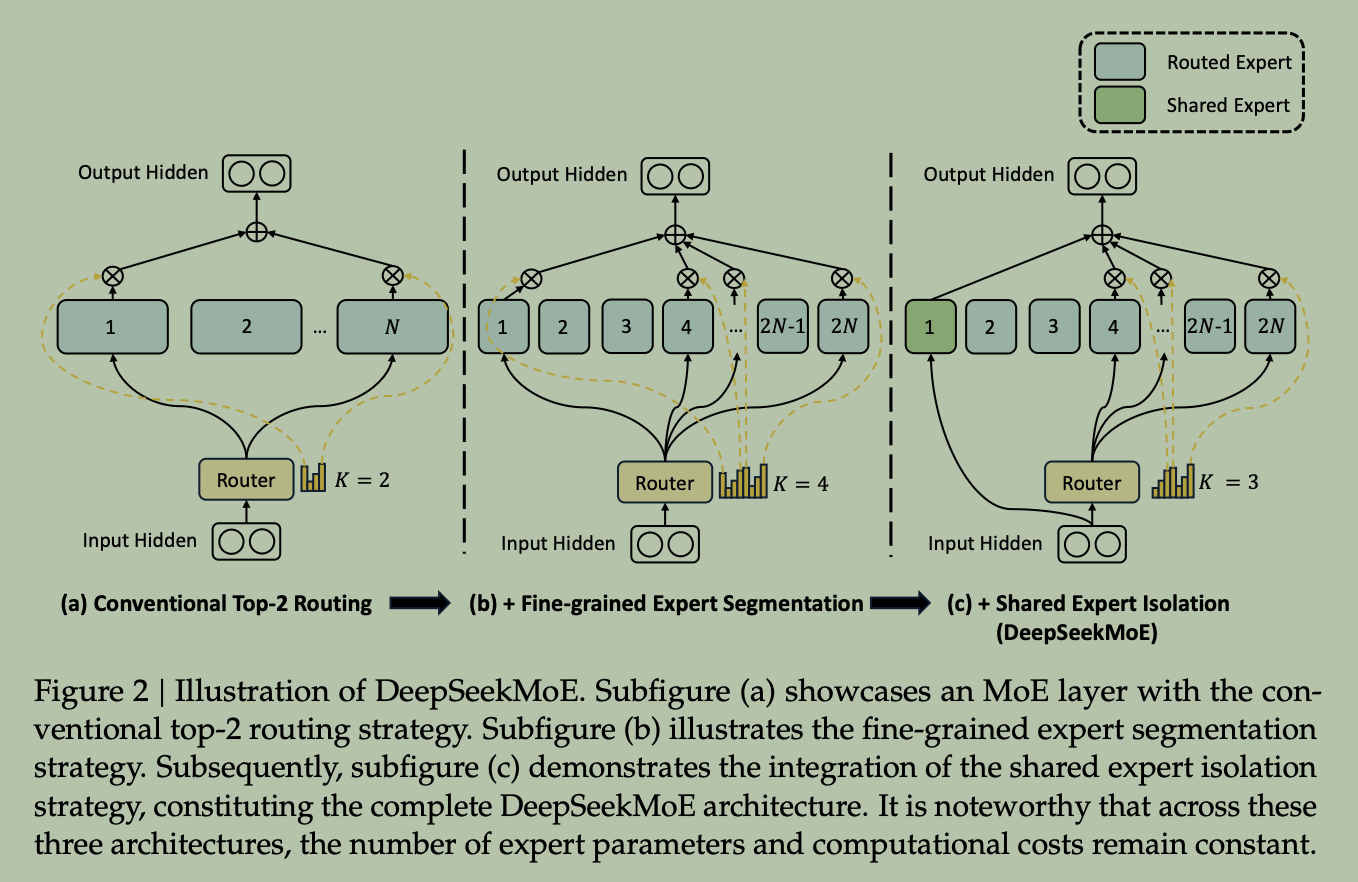
- 细粒度专家切分;
- 共享专家隔离。
3.1 Fine-Grained Expert Segmentation
- 保持专家参数量和计算成本相同,将传统单层中的 \(N\) 个大 FFN
专家,在中间隐藏层维度(intermediate hidden dimension)上切分为 \(m\) 倍,得到 \(mN\) 个较小的专家(每个小专家的参数量为标准
FFN 的 \(\frac{1}{m}\))。同时,将单
Token 激活的专家数量也扩大 \(m\)
倍,即从 Top-\(K\) 增加到 Top-\(mK\)。
- 例子:假设 Transformer 模型的主干维度 \(d_{model} = 512\),原本每个 FFN
专家的中间层维度 \(d_{inter} = 2048\):
- 切分前(传统 64 个大专家):
- 矩阵 Shape:
- 输入升维投影 \(W_{in}\):形状为 \(512 \times 2048\)
- 输出降维投影 \(W_{out}\):形状为 \(2048 \times 512\)
- 专家数量:共 64 个大专家。
- 路由激活:假设选择 Top-2 激活,激活参数对应计算量为 \(2 \times (512 \times 2048 \times 2)\)。
- 矩阵 Shape:
- 细粒度切分后(按 \(m=4\) 切分):
- 中间隐层维度:缩小为 \(\frac{2048}{4} = 512\)。
- 矩阵 Shape:
- 输入升维投影 \(W_{in}\):形状缩减为 \(512 \times 512\)
- 输出降维投影 \(W_{out}\):形状缩减为 \(512 \times 512\)
- 专家数量:由 64 个拆分为 \(64 \times 4 = 256\) 个细粒度小专家。
- 路由激活:为了保持总计算量(FLOPs)不变,激活的小专家数量相应扩大 4 倍,即从选 Top-2 变为选 Top-8。
- 切分前(传统 64 个大专家):
- 例子:假设 Transformer 模型的主干维度 \(d_{model} = 512\),原本每个 FFN
专家的中间层维度 \(d_{inter} = 2048\):
- 数学形式:
\[ \mathbf{h}_t^l = \sum_{i=1}^{mN} g_{i,t} \text{FFN}_i(\mathbf{u}_t^l) + \mathbf{u}_t^l \] 其中门控权重 \(g_{i,t}\) 表示从 \(mN\) 个小专家中选取亲和度得分最高的 Top-\(mK\) 个。
组合数学角度理解
保持计算开销(激活参数量)恒定的同时,激活专家的组合灵活度(Combinatorial Flexibility)呈指数级暴增。 例如在 \(N=16, K=2\) 的传统 GShard 设定下,选择组合仅有:
\[ \binom{16}{2} = 120 \text{ 种} \] 若将每个专家切分为 4 个小专家(\(m=4\),即从 64 个小专家中选 8 个),组合数暴增至:
\[ \binom{64}{8} = 4,426,165,368 \text{ 种(超 44 亿种)} \] 这种超强的组合灵活性使得模型能够将复杂知识更加精准地分解到不同小专家中,实现更聚焦的知识分布(Expert Specialization)。
3.2 Shared Expert Isolation
细粒度分割大幅提升了组合表达能力,但不同 Token 依然需要用到语言模型中的通用基础知识(如语法规则、句子结构)。如果全靠动态路由,多个路由专家依然会在各自参数中重复学习这些通用知识,造成参数冗余。
- 核心做法:从所有小专家中显式指定 \(K_s\) 个专家作为共享专家(Shared Experts)。共享专家不受门控网络控制,对所有 Token 无条件全量激活。
- 动态路由调整:为了保持总计算量恒定,剩余的路由专家数量变为 \(mN - K_s\),动态路由选择的激活专家数量调整为 \(mK - K_s\)。
- 公式表达:
\[ \mathbf{h}_t^l = \underbrace{\sum_{i=1}^{K_s} \text{FFN}_i(\mathbf{u}_t^l)}_{\text{共享专家(确定性激活)}} + \underbrace{\sum_{i=K_s+1}^{mN} g_{i,t} \text{FFN}_i(\mathbf{u}_t^l)}_{\text{路由专家(动态 Top-}(mK-K_s)\text{)}} + \mathbf{u}_t^l \]
- 本质与作用:共享专家扮演了“通用知识池”的角色,把全局共性知识从路由模块中强行解耦出去。路由专家不再需要浪费参数去学习通用特征,从而能够丢掉包袱,彻底专注于特定领域的特异性知识。
3.3 Load Balance Consideration
在自适应门控路由中,模型极易出现“路由崩溃”(Routing Collapse,即某些专家总是被选中,而大部分专家得不到训练)或硬件设备间计算负载不均的问题。为此,DeepSeekMoE 设计了双层约束损失。
专家级负载均衡损失(Expert-Level Balance Loss)
用于防止路由崩溃,公式为:
\[ \mathcal{L}_{\text{ExpBal}} = \alpha_1 \sum_{i=1}^{N'} f_i P_i \]
- \(\alpha_{1}\) 为超参数,表示专家级平衡因子。
- \(N' = mN - K_s\) 表示路由专家的总数。
- \(f_i\) 是路由到专家 \(i\) 的 Token 实际比例, \(P_i\) 是所有 Token 路由到专家 \(i\) 的平均门控概率。
- 通过最小化 \(\mathcal{L}_{\text{ExpBal}}\),鼓励每个路由专家被均匀选择。
设备级负载均衡损失(Device-Level Balance Loss)
在分布式训练/推理中,专家通常被分组部署在不同的 GPU 设备上。如果对每个专家强加过于严格的平衡约束,会严重损伤专家的专业化分工(compromise model performance)。因此,作者提出了设备级别的软约束: 将路由专家分为 \(D\) 个组 \(\{E_1, E_2, ..., E_D\}\) 并部署到 \(D\) 个 GPU 上,计算设备间平均负载:
\[ \mathcal{L}_{\text{DevBal}} = \alpha_2 \sum_{i=1}^{D} f'_i P'_i \] 其中 \(f'_i\) 和 \(P'_i\) 分别为设备 \(i\) 上包含的所有专家的平均选择比例与平均选择概率。
- 实践策略:设置较小的专家级系数 \(\alpha_1\)(仅用于防崩溃,避免过度约束专家专业化),同时设置较大的设备级系数 \(\alpha_2\)(确保硬件跨卡计算量平稳,消除硬件瓶颈)。
4. Validation Experiments
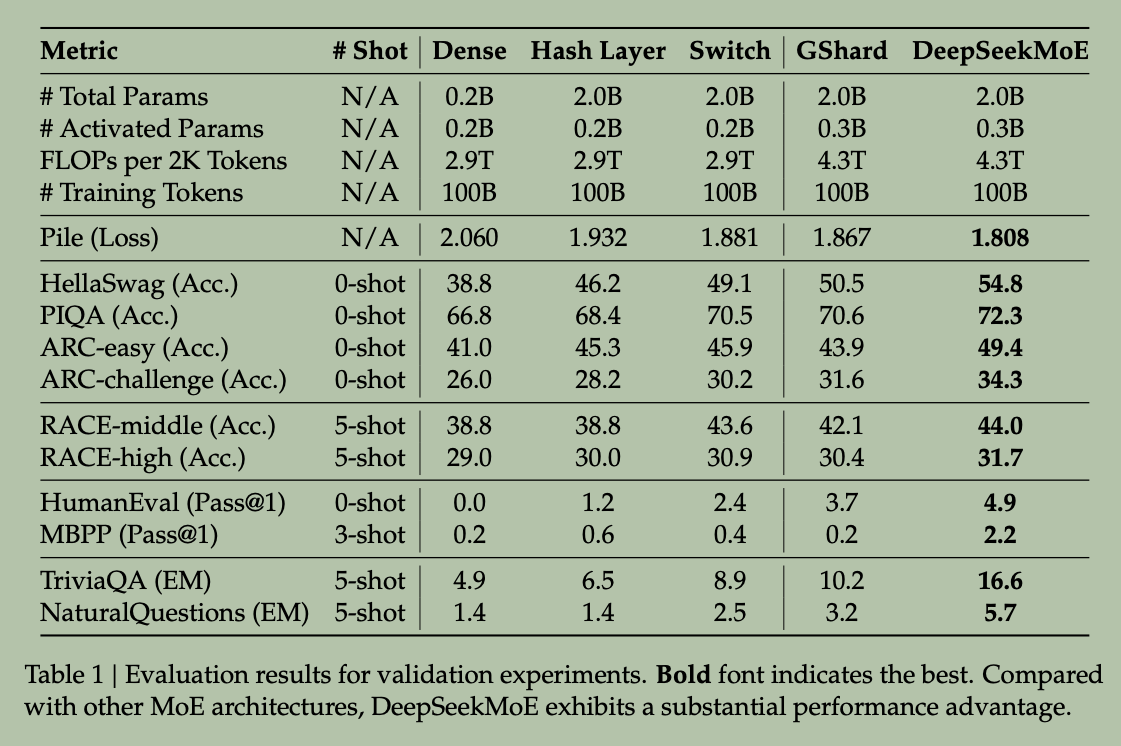
- 在保持总参数量(2.0B)和训练条件完全相同的设定下,DeepSeekMoE 在全部 11 项评估指标上均对 GShard 取得了压倒性优势。
其他实验内容略。
5. Scaling up to DeepSeekMoE 16B
With the DeepSeekMoE architecture, we scale up our MoE model to a larger scale with 16B total parameters and train it on 2T tokens. Our results demonstrate that compared with LLaMA2 7B, DeepSeekMoE 16B achieves superior performance with only about 40% of computations.
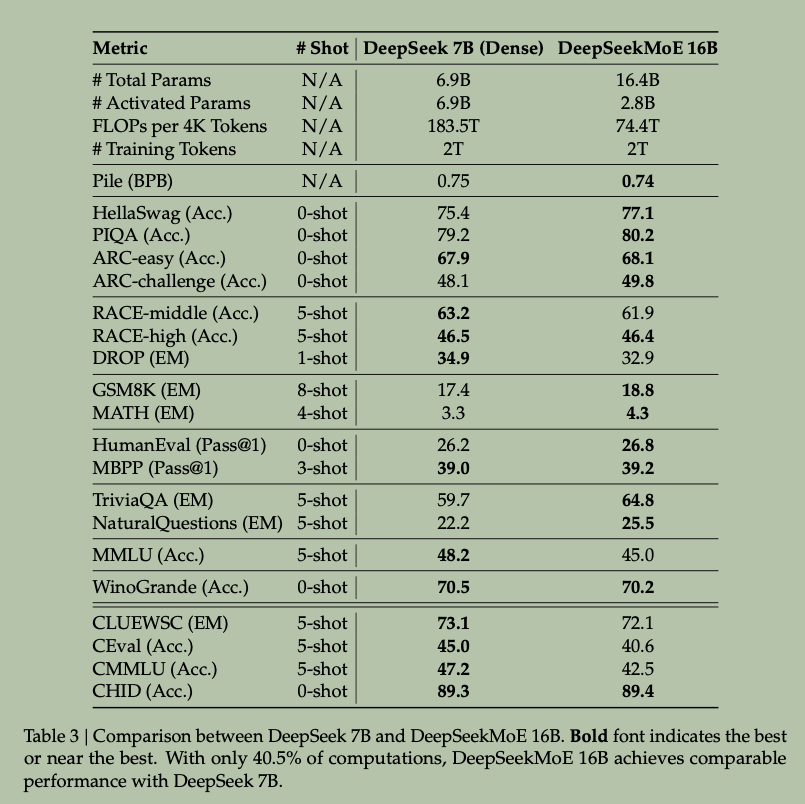
- DeepSeekMoE 16B 仅使用约 40% 的计算量(2.8B 激活参数),就取得了与 DeepSeek 7B Dense 及 LLaMA2 7B 相当或更优的综合性能。
- 模型结构特殊变化:第一层用单一 FFN 而不是 MoE,因为观察到第 1 层的负载均衡收敛速度极其缓慢。
第 5 节成功证明了 DeepSeekMoE 架构具备极强的可扩展性(Scalability),能够在真实的大规模(16B/2T Token)训练中,以 40% 的计算成本完美兑现超越同规模 Dense 模型的性价比优势。
6. Alignment for DeepSeekMoE 16B
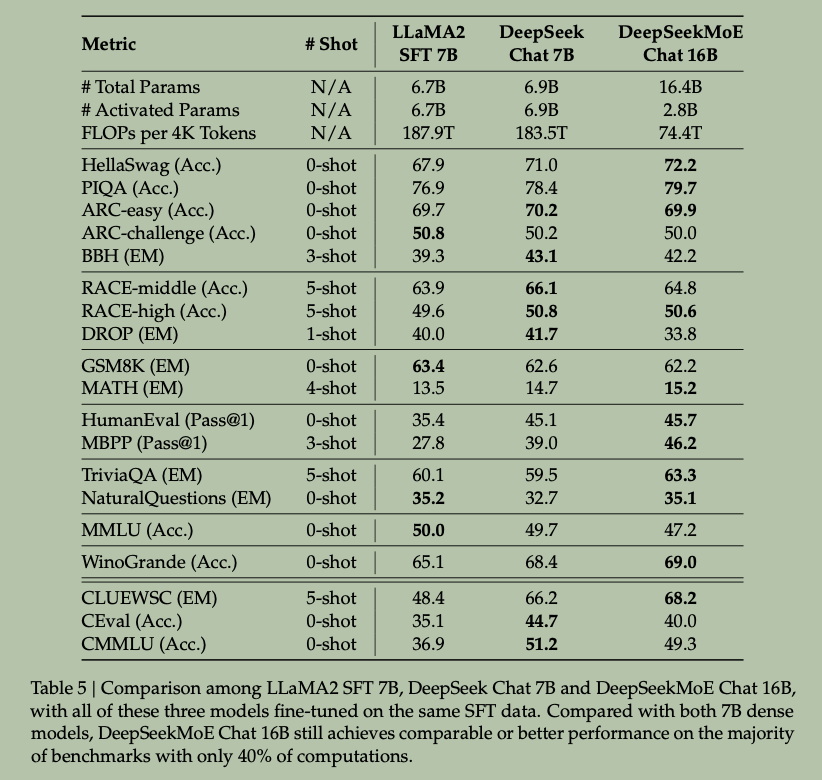
- 本节通过将 DeepSeekMoE 16B 对齐为对话模型(DeepSeekMoE Chat 16B),验证了稀疏架构在经过 SFT 后的实用价值。
- 在代码生成、常识推理、阅读理解等任务上超越或持平 Dense 模型。
7. DeepSeekMoE 145B Ongoing
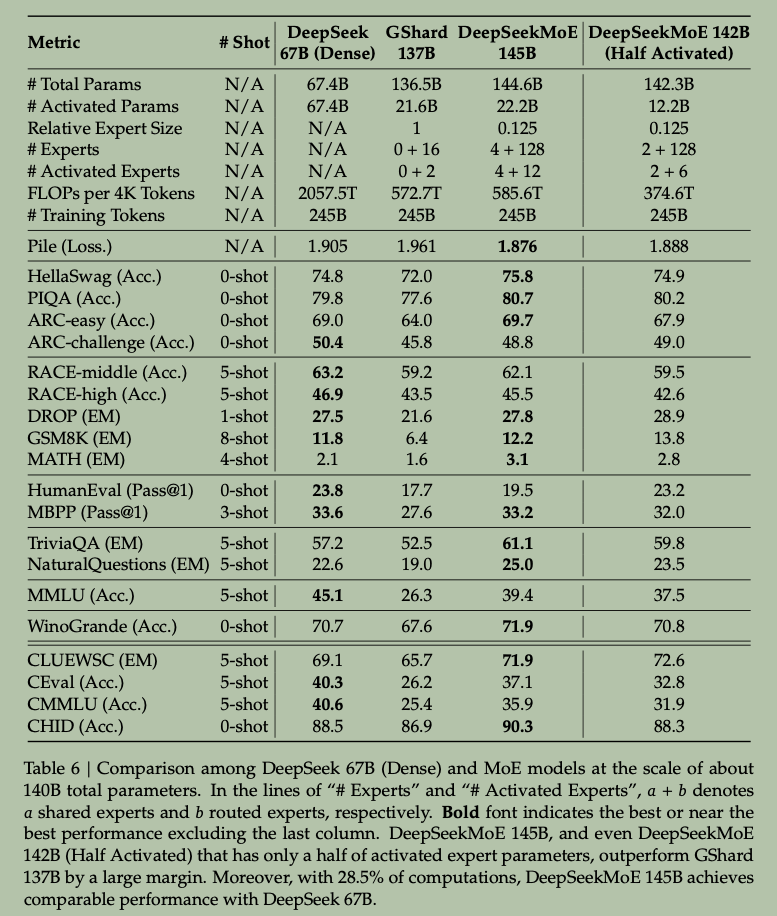
进一步扩展 DeepSeekMoE 模型参数量从 16B 到 145B。在仅训练 245B Tokens 的初步探索中,模型便展现出了对传统 GShard 架构的压倒性优势,并证明了仅需约 28.5%(甚至低至 18.2%) 的计算量即可媲美 DeepSeek 67B 稠密模型。
8. Conclusion
- DeepSeekMoE
- 细粒度专家切分(FFN 中间层维度切分);
- 共享专家隔离(学习通用知识,减少路由专家冗余参数,提高专家专业化);
9. MoE 发展路径总结:GShard -> Switch Transformer -> DeepSpeed MoE -> DeepSeekMoE
从 GShard 到 DeepSeekMoE 的演进,本质上是一部 “如何在控制单 Token 计算量(FLOPs)的前提下,不断提升专家参数利用效率、解决路由不稳定性并实现极致知识解耦” 的发展史。
9.1 四代核心架构综合对比表
| 对比维度 | GShard (2020) | Switch Transformer (2021) | DeepSpeed-MoE / PR-MoE (2022) | DeepSeekMoE (2024) |
|---|---|---|---|---|
| 核心目标 | 提出条件计算框架,实现 Transformer 参数量的稀疏扩展。 | 简化路由算法,降低通信开销,提升稀疏模型训练稳定性。 | 解决自回归生成模型中 MoE 参数量过大的显存与推理瓶颈。 | 解决传统 MoE 中的“知识杂糅”与“知识冗余”,追求极致的专家专业化。 |
| 专家切分粒度 | 粗粒度:每个专家为标准完整尺寸 FFN,隐藏层维度无切分。 | 粗粒度:隐藏层维度与标准 FFN 完全对齐。 | 异构粗粒度:浅层少专家、深层多专家的金字塔大 FFN 结构。 | 细粒度:将 FFN 中间隐层维度按 \(\frac{1}{m}\) 切分为 \(mN\) 个小专家。浅层采用 FFN 而不是 MoE。 |
| 门控路由与激活 | Top-2 路由:每个 Token 选 2 个大专家,配合随机路由。 | Top-1 路由:每个 Token 仅选择 1 个大专家(Switch Routing)。 | Residual Top-1:固定 1 个 Dense 主干 + 动态选 1 个路由专家。 | 共享 + Top-\((mK-K_s)\):激活 \(K_s\) 个共享小专家 + 动态路由选多个小专家。 |
| 通用知识处理 | 无共享专家设计,路由专家需自行重学通用特征。 | 无共享专家设计,全局通用特征靠单一路由专家承载。 | 工程视角雏形:引入固定 Dense FFN 作为残差主干承担基础计算。 | 算法视角彻底解耦:隔离 \(K_s\) 个共享专家全量激活,路由专家无冗余专注特异知识。 |
| 组合灵活性 | \(\binom{N}{2}\) 种组合(如 16 选 2 为 120 种)。 | \(N\) 种组合,缺少组合多样性。 | 有限的组合模式,依赖残差修正。 | \(\binom{mN-K_s}{mK-K_s}\) 种组合(几十亿级爆发),精准匹配复杂上下文。 |
| 负载均衡机制 | 组内容量分配 + 可微辅助 Loss \(\mathcal{L}_{\text{aux}}\)。 | 可微辅助 Loss(包含专家数 \(N\) 缩放)+ 容量因子。 | 多专家多数据并行(EP+DP),解决金字塔各层专家数不均问题。 | 双层均衡:专家级 Loss(弱,防崩溃)+ 设备级 Loss(强,保跨 GPU 平衡)。 |
| 关键工程创新 | GShard 声明式标注 API 与 XLA 编译器 SPMD 自动分片。 | 选择性高精度(Router 转 fp32)与 0.1x 缩放初始化。 | 树状阶梯 All-to-All 通信与并行协调优化,MoS 阶段蒸馏。 | 专有 CUDA/Triton 算子融合(小矩阵 GEMM 融合),单卡 40GB 可直接部署 16B 模型。 |
| 主要局限与代价 | 易发生知识杂糅与跨专家参数冗余,参数利用效率不高。 | 强依赖单个专家的全能性,缺乏组合拟合复杂知识的能力。 | 固定 Dense 主干尺寸较大,未在算法层面探索隐层维度的切分。 | 专家切分过细易降低 GPU GEMM 算子利用率;Attention 权重占比偏低限制多选题能力。 |
9.2 核心数学公式演进对比
1. GShard (Top-2 路由与连续可微辅助 Loss)
输入向量与专家质心计算 Softmax 得到门控权重,每个 Token 动态分发给 Top-2 专家:
\[ s_{i,t} = \text{Softmax}_i \left( (\mathbf{u}_t^l)^T \mathbf{e}_i^l \right) \]
为平滑推动门控网络将 Token 均匀分配给所有专家,GShard 将离散计数重构为连续可微辅助 Loss:
\[ \mathcal{L}_{\text{aux}} = \frac{1}{E} \sum_{e=1}^{E} \left( \frac{c_e}{S} \cdot m_e \right) \]
其中 \(\frac{c_e}{S}\) 是路由到专家 \(e\) 的实际 Token 比例, \(m_e = \frac{1}{S} \sum_{s=1}^S g_{s,e}\) 为软路由概率均值。
2. Switch Transformer (Top-1 路由与专家数放缩 Loss)
简化路由至 Top-1(Switch Routing),仅激活 1 个专家:
\[ p_i(x) = \frac{e^{h(x)_i}}{\sum_{j=1}^N e^{h(x)_j}} \]
辅助 Loss 乘以专家总数 \(N\),确保 Loss 数值不会随着专家数扩展而发生量级漂移:
\[ \text{Loss}_{\text{aux}} = \alpha \cdot N \cdot \sum_{i=1}^N f_i \cdot P_i \]
其中 \(f_i\) 为实际分配比例, \(P_i\) 为 Router 概率分配均值。
3. DeepSeekMoE (细粒度分割与共享隔离)
每个大专家的隐层维度切分为原来的 \(\frac{1}{m}\),获得 \(mN\) 个小专家;显式指定 \(K_s\) 个小专家作为固定全量激活的共享专家,剩余 \(mN - K_s\) 个路由小专家选 Top-\((mK - K_s)\):
\[ s_{i,t} = \text{Softmax}_i \left( (\mathbf{u}_t^l)^T \mathbf{e}_i^l \right) \]
\[ g_{i,t} = \begin{cases} s_{i,t}, & s_{i,t} \in \text{Topk}\left({s_{j,t} \mid K_s + 1 \leqslant j \leqslant mN}, mK - K_s\right) \\ 0, & \text{otherwise} \end{cases} \]
\[ \mathbf{h}_t^l = \underbrace{\sum_{i=1}^{K_s} \text{FFN}_i(\mathbf{u}_t^l)}_{\text{共享专家(确定性激活)}} + \underbrace{\sum_{i=K_s+1}^{mN} g_{i,t} \text{FFN}_i(\mathbf{u}_t^l)}_{\text{路由专家(动态 Top-}(mK-K_s)\text{)}} + \mathbf{u}_t^l \]
结合专家级与设备级双层均衡损失:
\[ \mathcal{L}_{\text{ExpBal}} = \alpha_1 \sum_{i=1}^{N'} f_i P_i, \quad \mathcal{L}_{\text{DevBal}} = \alpha_2 \sum_{i=1}^{D} f'_i P'_i \]
9.3 演进脉络解构
1 | |
- GShard 阶段:首次将稀疏门控混合专家(MoE)成功应用到 Transformer 架构中。提出了固定专家容量(Expert Capacity)与溢出透传机制,配合可微辅助 Loss,奠定了稀疏条件计算的基石。
- Switch Transformer 阶段:主张路由极简主义,将路由简化为 Top-1,极大地降低了计算与跨卡通信开销。同时提出选择性高精度(Selective Precision)(仅 Router 内部转 fp32)与 0.1x 缩放初始化,首次实现了 low-precision(bf16)下万亿参数稀疏模型的稳定训练。
- DeepSpeed-MoE 阶段:从工程与参数效率视角重构架构,提出 PR-MoE。观察到深层网络更受益于多专家,构建了浅层少专家、深层多专家的金字塔结构;并采用“固定 Dense MLP 主干 + 动态 Top-1 路由”的残差结构,成为了“共享专家”的直接雏形。
- DeepSeekMoE
阶段:从算法视角出发,解决知识杂糅与知识冗余问题:
- 细粒度专家分割:将隐藏层维度切分为 \(\frac{1}{m}\),激活专家的组合模式数呈指数级暴增(从百级别暴增至数十亿级),大幅提升知识拼装灵活性。
- 共享专家隔离:显式隔离固定激活的共享专家,专门承载全局共性知识,让路由专家能够彻底专注在领域特异性知识上。