ZeRO: Memory Optimizations Toward Training Trillion Parameter Models
- ZeRO: Memory Optimizations Toward Training Trillion Parameter Models
- arXiv 提交日期:4 Oct 2019(Megatron-LM v1 paper 提交约 2 周后,即:17 Sep 2019 -> 4 Oct 2019)
- 代码:DeepSpeed ZeRO
- 作者:
摘要
大型深度学习模型能够带来显著的准确率提升,但训练数十亿至万亿参数量的模型极具挑战。现有的解决方案(如数据并行和模型并行)在将这些模型装入有限的设备显存中时存在根本局限,难以同时兼顾计算效率、通信效率和开发效率。为此,我们开发了一种全新的解决方案——零冗余优化器(Zero Redundancy Optimizer,简称 ZeRO)。通过优化显存占用,ZeRO 在大幅提升训练速度的同时,极大地扩展了可高效训练的模型规模。ZeRO 消除了数据并行和模型并行训练中的显存冗余,同时保持了低通信量与高计算粒度,使我们能够以持续的高效率将模型规模与设备数量成正比地扩展。我们对显存需求和通信量的分析表明:借助当今的硬件,ZeRO 具备扩展至超过 1 万亿参数的潜力。
我们实现并评估了 ZeRO:在 400 张 GPU 上,它以超线性加速训练了超过 1000 亿(100B)参数的大模型,实现了 15 Petaflops 的吞吐量。与当时最先进的技术(SOTA)相比,这代表着模型规模扩大了 8 倍,可达到的性能提升了 10 倍。在易用性方面,ZeRO 可以在不需要模型并行(这对科学家来说更难应用)的情况下,训练高达 130 亿(13B)参数的大模型(例如,大于 Megatron GPT 8.3B 和 T5 11B)。最后但也同样重要的是,研究人员利用 ZeRO 的系统性突破创建了当时全球最大的语言模型(170 亿参数),并取得了创纪录的准确率。
1. Introduction
- 已有并行策略的问题
- DP:模型规模被单 device 内存大小限制(内存效率低)。
- MP(TP):需要机内高带宽互联,扩展到多机效率下降严重(通信效率低)。
- PP:流水线气泡影响效率,增大 batch size 虽然能够减少气泡比例,但是训练效果可能变差(相同 FLOPs step 数变少,参数更新次数变少)(计算效率低)。
- 训练时内存占用分析:
- 模型状态(model states):
- 优化器状态(如 Adam 的 momentum and variances)
- 梯度
- 参数
- 其他状态(residual states):
- 激活值
- 临时 buffer
- 未使用的内存碎片
- 模型状态(model states):
- 本文提出的方法:ZeRO—Zero Redundancy Optimizer
Optimizing Model State Memory
- DP 本身在不同 device 的模型状态都是重复的;
- ZeRO-DP 通过切分 DP 的模型状态,同时实现高内存效率和高计算/通信效率;
- ZeRO-DP 三个优化级别,如下图所示:
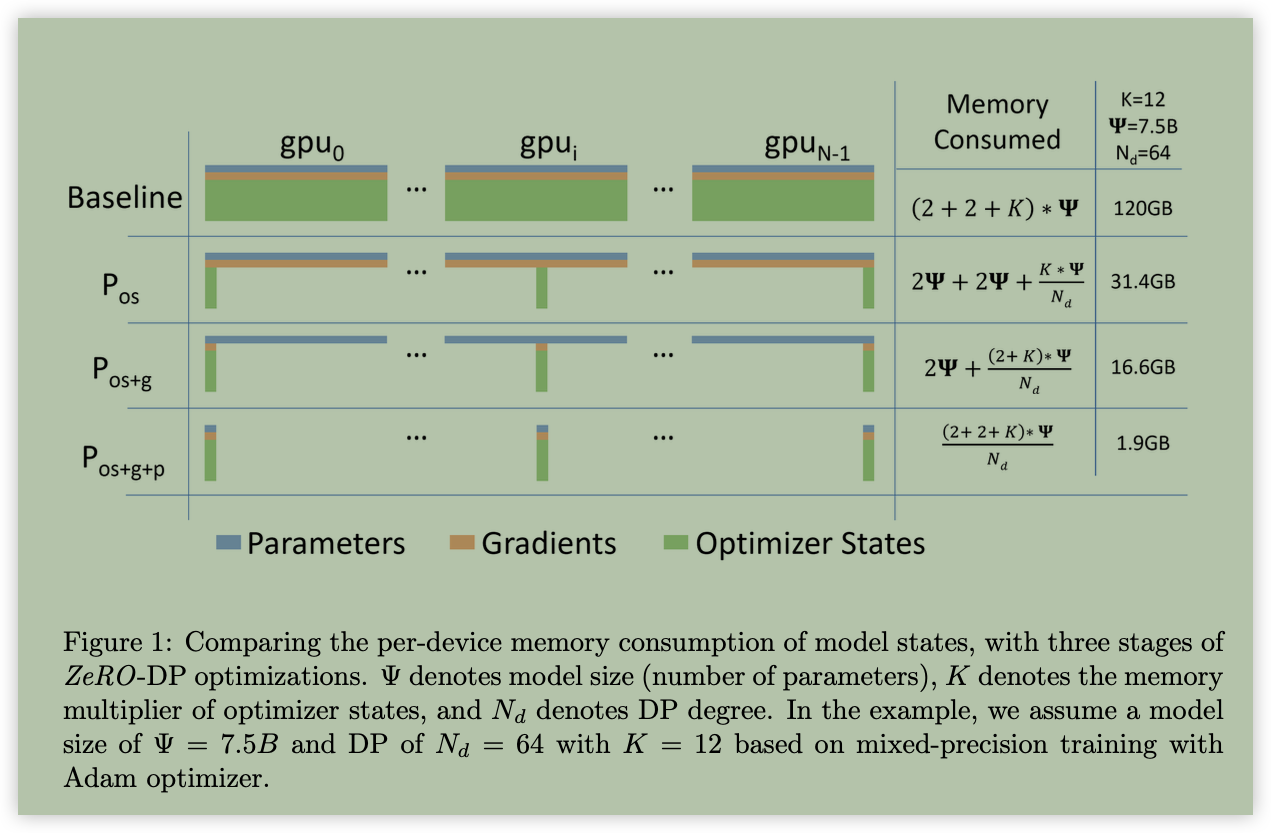
- 仅切分优化器状态:4x 内存减少,通信量与 DP 相同;
- 额外切分梯度:8x 内存减少,通信量与 DP 相同;
- 额外切分模型参数:内存减少与 DP 大小 \(N_d\) 相同,通信量对比 DP 增加 50%;
Optimizing Residual State Memory
- 提出 ZeRO-R 优化 activations, temporary buffers, and unusable memory
fragments 的内存占用;
- activations:梯度检查点 & 开启 MP 时进行激活值切分 & CPU Offload;
- temporary buffers:设置一个合适的大小,以达到内存和计算效率的平衡;
- memory fragments:根据张量的生命周期特征进行主动显存管理,预分配连续内存;
ZeRO and MP
- 如果使用 MP 的唯一目的是为了在单卡上放下一个大模型,那么在 ZeRO 出现后,MP 的吸引力大幅下降;
- 需要结合 MP 的场景:
- 对于超大规模模型,激活值内存占用很大时,可以使用 MP 结合 ZeRO-R 减少激活值内存占用;
- 如果在数千张 GPU 的大规模集群上完全使用纯数据并行(DP),全局 Batch Size(单卡 Batch Size \(\times\) 卡数 \(N_d\))会被拉得非常庞大。但深度学习训练存在临界 Batch Size(Critical Batch Size)——一旦 Batch Size 超过临界值,梯度的噪声信息会严重缺失,多算的数据无法换来等比例的收敛速度,甚至会导致模型不收敛。引入 MP 可以在保持集群总 GPU 数量不变的前提下,降低数据并行度 \(N_d\),从而将全局 Batch Size 控制在对算法收敛最友好的合理区间内。
Implementation & Evaluation
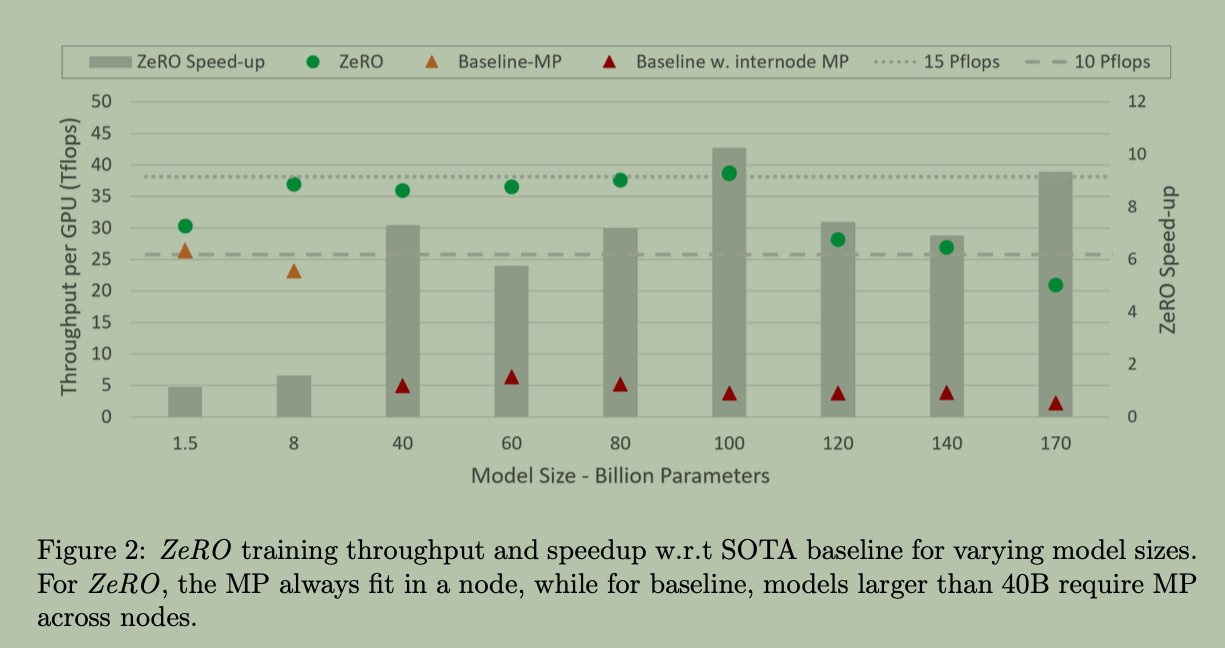
- 模型规模与吞吐量突破:结合 16 路机内模型并行,ZeRO-100B 成功驱动了 170B 参数 的模型,而纯 Megatron-LM 在超过 40B 参数后性能急剧崩溃。在 8B 到 100B 模型区间,集群保持了 15 PetaFlops 的总吞吐(平均单卡超过 38 TFLOPS,算力利用率超过硬件峰值的 30%),比 Megatron-LM 提升了最高 10 倍 的训练速度。性能崩塌的根本原因在于,Megatron-LM 跨节点时通信带宽从 NVLink 的 300 GB/s 骤降到 InfiniBand 的 12.5 GB/s2;而 ZeRO-100B 保持机内 MP、机间 DP,回避了跨节点细粒度通信。
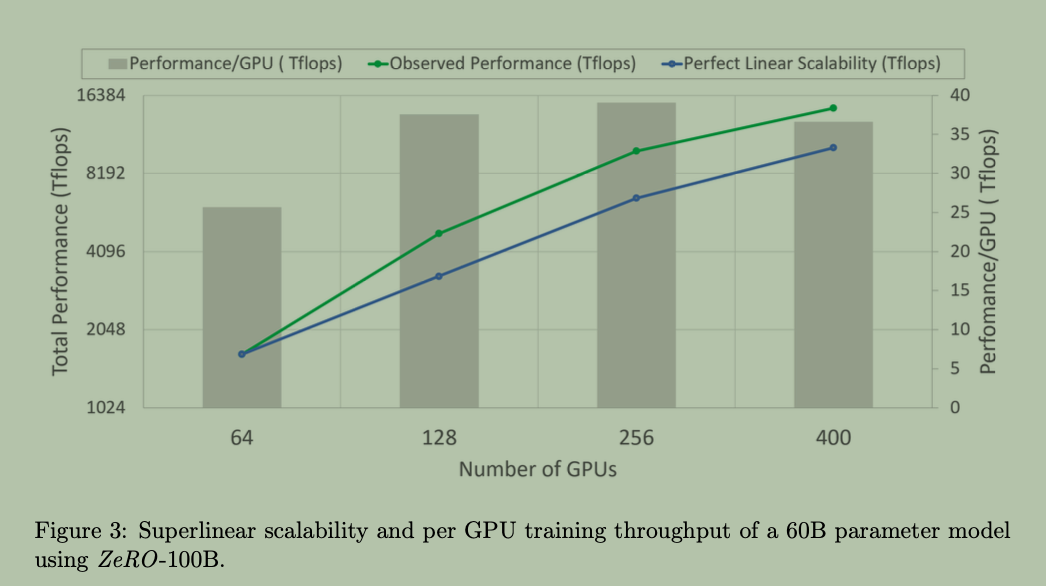
- 超线性扩展性(Super-Linear Scalability):针对 60B 模型,当 GPU 卡数从 64 扩展到 400 张时,整体吞吐量展现出了超线性加速。这是因为随着卡数 \(N_d\) 增加,ZeRO-DP 进一步摊薄了单卡显存;省出来的显存允许单卡运行更大的 Batch Size,进而提高了算术强度(Arithmetic Intensity)和 GPU 算力利用率。
2. Where Did All the Memory Go?
训练时内存分布情况:
- 模型状态:
- 优化器状态
- 梯度
- 参数
- 其他状态:
- 激活值
- 临时 buffers
- 内存碎片
2.1 Model States: Optimizer States, Gradients and Parameters
以 Adam 优化器为例,需要保存以下状态:
- 动量:the time averaged momentum
- 方差:variance of the gradients
Mixed-Precision Training
- 混合精度训练:
- 模型权重和激活值以 16 位(fp16) 存储,以在 forward/backward 计算时利用 GPU Tensor Core 加速;
- 优化器以 fp32 格式保存一份模型参数复制,以及优化器状态,以防止浮点数下溢和数值更新失效;
假设模型参数量为 \(\Psi\),各部分占用的显存空间如下:
- FP16 参数(Parameters):占用 \(2\Psi\) 字节。
- FP16 梯度(Gradients):占用 \(2\Psi\) 字节。
- FP32 Adam 优化器状态(Optimizer States):
- FP32 主权重副本(Master Weights):占用 \(4\Psi\) 字节。
- FP32 一阶动量(Momentum):占用 \(4\Psi\) 字节。
- FP32 二阶方差(Variance):占用 \(4\Psi\) 字节。
用系数 \(K\) 表示优化器状态相对于参数量的显存倍数,对于混合精度 Adam 优化器,\(K = 12\)。
将上述三部分相加,训练一个参数量为 \(\Psi\) 的模型,其模型状态所需的最小显存总开销为:
\[ \text{Memory}_{\text{Model States}} = 2\Psi + 2\Psi + K\Psi = 2\Psi + 2\Psi + 12\Psi = 16\Psi \text{ 字节} \]
以 1.5B 参数的 GPT-2 模型 为例(\(\Psi = 1.5 \times 10^9\)):
- FP16 权重本身:\(1.5 \times 10^9 \times 2 \text{ Bytes} = \mathbf{3\text{ GB}}\)。
- FP16 梯度:\(1.5 \times 10^9 \times 2 \text{ Bytes} = \mathbf{3\text{ GB}}\)。
- FP32 优化器状态:\(1.5 \times 10^9 \times 12 \text{ Bytes} = \mathbf{18\text{ GB}}\)。
- 模型状态显存总计:\(1.5 \times 10^9 \times 16 \text{ Bytes} = \mathbf{24\text{ GB}}\)。
2.2 Residual Memory Consumption
- Activations:
- 生成原因与体积:前向传播过程中,神经网络每一层的中间输出(激活值)都需要被保留在显存中,以便在反向传播时用于计算梯度。激活值显存的大小与模型层数、隐藏层维度、序列长度(Sequence Length)以及 Batch Size 呈正比例关系。
- 定量示例:以 1.5B 参数的 GPT-2 为例(序列长度为 1K,Batch Size 为 32),如果不做任何优化,仅保存激活值就需要消耗高达 60 GB 的显存。
- 传统解法及其局限:常规的优化手段是使用激活重计算(Activation Checkpointing),即只保留少量的检查点(Checkpoints),其余激活值在反向传播需要时重新计算。这虽然能以增加约 33% 的重计算开销为代价,将 1.5B GPT-2 的激活显存压低至 8 GB;但对于百亿/千亿参数规模的模型来说依然不够。例如,一个 100B 参数的 GPT 类模型,即便开启了激活重计算,在 Batch Size 为 32 时,激活显存依然高达 60 GB。
- Temporary buffers:
- 生成原因与体积:在分布式训练中,为了跑满硬件通信带宽(消息越大通信吞吐越高),类似梯度 All-Reduce 或梯度范数(Gradient Norm)计算等操作,通常需要先将离散的张量打平(Flatten)并融合(Fuse)进一个连续的临时 Buffer 中。
- 定量示例:虽然 FP16 训练时的梯度本身是 FP16 格式,但为了保持数值精度,这些融合缓冲区通常必须分配为 FP32 格式。对于一个 1.5B 参数的模型,仅单次融合所需的一个 FP32 缓冲区就会占据 6 GB 的显存;当模型规模达到数百亿或上千亿时,这类临时缓冲区的显存开销将非常庞大。
- Memory Fragmentation:
- 生成原因:训练过程中存在不同生命周期的张量交错申请与释放。例如,前向传播中保留的激活检查点是长生命周期的,而临时重算出的激活值是短生命周期的。这种交错分配会导致连续的显存空间被割裂成大量微小的闲置碎片。
- 致命后果:当系统试图申请一块较大的连续显存时,即便剩余的总闲置显存大于请求量,也会因为找不到足够的连续空间而直接抛出 OOM 错误。
- 极端观察:作者在训练超大模型时观察到,在某些极端情况下,即便系统剩余可用显存高达 30% 以上,也会因为严重碎片化而遭遇 OOM 崩塌。
3. ZeRO: Insights and Overview
ZeRO 优化点:
- ZeRO-DP:ZeRO-DP aimed at reducing the memory footprint of the model states.
- ZeRO-R:ZeRO-R targeted towards reducing the residual memory consumption.
3.1 Insights and Overview: ZeRO-DP
提出 ZeRO-DP 基于以下三项关键洞察:
- DP 比 MP 具有更好的扩展效率,因为 MP 减小了计算粒度,同时增加了通信负担;而 DP 通信量更小,且计算粒度更大。
- DP 内存效率低,因为模型状态在所有 DP 进程间复制;MP 那些效率高,因为其切分了模型状态;
- DP 和 MP 都会在整个训练过程中静态保留所需的所有模型状态,但实际上并非所有状态在任何时刻都是必需的。例如,每一层对应的模型参数,仅在该层的前向传播和反向传播计算期间才被需要。
Solution: ZeRO-DP
- 既保留了数据并行(DP)的高训练效率,又获得了模型并行(MP)的高显存利用效率;
- 切分(Partitioning)代替复制(Replication)
- 优化器状态、梯度和参数不再在所有卡上静态复制。
- 只要集群包含 \(N_d\) 张卡,模型状态就被切成 \(N_d\) 份分管,从而实现:单卡显存占用随着卡数 \(N_d\) 的增加呈严格的线性下降(Linear Scaling)。
- 动态通信调度:ZeRO-Stage 3
不再将所有参数静态保存在每张卡上,而是采用了动态通信调度(Dynamic
Communication Schedule)
- 平时切分保存:每张 GPU 只需要永久保存全模型参数的 \(\frac{1}{N_d}\) 切片。
- 用时动态拉取:前向计算到第 \(L\) 层前,后台异步发起
All-Gather,从其他 GPU 拉取第 \(L\) 层的完整参数。 - 算完立即释放:第 \(L\) 层前向计算一结束,立即将临时收集到的全量参数从显存中丢弃(Discard),只保留本地切片。
- 反向重复此过程:反向传播计算到第 \(L\) 层时,再次拉取第 \(L\) 层参数计算梯度,算完再次丢弃。
3.2 Insights and Overview: ZeRO-R
3.2.1 Reducing Activation Memory
两项洞察:
- 模型并行导致了激活值的盲目复制:在使用传统模型并行时,虽然网络层的参数被切分到了不同 GPU 上,但为了保证计算对齐,激活值却在各个 MP 进程间被完全复制保存了。例如,在并行计算一个 Linear 层时,每张 GPU 都必须各自保存一份完整的输入激活值才能完成本地矩阵乘法。
- 超大模型拥有极高的“算术强度”:对于 GPT-2 规模及更大的模型,其算术强度非常高(\(\ge 10\text{K}\)),并且随着隐藏层维度 \(h\) 线性增加。这意味着矩阵计算消耗的时间远远长于数据传输的时间,即便在较窄的网络带宽下,激活值搬运的通信开销也能被前向/反向的 GEMM 计算完全掩盖。
Solution
- 激活切分(\(P_a\)):ZeRO-R 消除了 MP
中的激活值复制,将激活检查点按 MP 维度切分分摊保存(每张 GPU 仅存 \(\frac{1}{N_m}\)),在反向传播计算前夕再通过一次
All-Gather动态重构。 - CPU 卸载(\(P_{a+cpu}\)):得益于极高的算术强度,对于超大模型,甚至可以把切分后的激活检查点顺畅地卸载到 CPU 内存中,将 GPU 上的激活显存占用逼近至零,而整体训练吞吐几乎不受损。
3.2.2 Managing Temporary buffers
- 引入固定大小缓冲区,强制将融合 Buffer 的容量上限设定为一个常数(例如几十兆字节),使其既能维持高硬件通信吞吐,又完全不随模型参数量的膨胀而增长。
3.2.3 Managing fragmented Memory
- 痛点与洞察:长/短生命周期张量的交错申请
显存碎片的产生,根源在于训练过程中长生命周期张量与短生命周期张量在显存中的交错申请与释放:
- 前向传播:保存的激活检查点是_长生命周期_对象,而随算随丢的临时中间激活值是_短生命周期_对象。
- 反向传播:积累的参数梯度是_长生命周期_对象,而计算过程中产生的临时激活梯度是短生命周期对象。 这种频繁的交错割裂了连续显存空间,导致 PyTorch 显存分配器需要花费大量时间去寻找合适块,甚至出现剩余 30% 总显存却因找不到连续块而惨遭 OOM 崩溃的极极端情况。
- 解法机制(\(M_D\)):ZeRO-R 执行在线去碎片化(On-the-fly Memory Defragmentation)。它为激活检查点和梯度提前预分配连续的显存大块,张量一经生成就直接复制存入该连续区域。这不仅从源头上阻止了显存碎片的产生,还省去了分配器反复搜索闲置块的时间。
4. Deep Dive into ZeRO-DP
4.1 \(P_{os}\) : Optimizer State Partitioning
- 设 DP 大小为 \(N_d\)
,将优化器状态切分为 \(N_d\) 等份,每个
rank 保存各自 partition,每个 DP 进程仅更新自己对应 partition 的 \(\frac{1}{N_d}\) 优化器状态和 \(\frac{1}{N_d}\) 的模型参数。
- 每个 step 解释需要进行
AllGather获取所有更新后的参数。
- 每个 step 解释需要进行
- 通信分析:ReduceScatter 梯度 + AllGather 更新后参数
- 显存预分配:在反向传播开始前,每张 GPU 上就已经静态分配好了全量梯度(\(2\Psi\) 字节)的显存空间。
- 按 Bucket 异步
AllReduce:反向传播倒序计算时,每当算满一个梯度
Bucket,立刻在后台发起异步
ReduceScatter。此时前台继续计算下一层的反向梯度——计算与通信 overlap。 - 持久存储不释放:
ReduceScatter归约完成后,得到的梯度依然保存在显存中(每个 Rank 都持久持有所有参数的梯度,或者各 Rank 均保留完整梯度 Buffer)。 - 优化器更新:直到整个反向传播结束,进入
optimizer.step()时,Rank \(i\) 只需要去读取全量梯度中属于它分管的那 \(\frac{1}{N_d}\) 切片,来更新它分管的 \(\frac{1}{N_d}\) 优化器状态。更新完成后做一次AllGather恢复全量 FP16 参数。 - 梯度累积不需要额外通信量。
- 内存分析:
- 单卡模型状态显存从标准 DP 的 \(4\Psi + K\Psi\)(即 \(16\Psi\))降至 \(4\Psi + \frac{K\Psi}{N_d}\)。
4.2 \(P_g\) : Gradient Partitioning
- 既然第 \(i\) 张 GPU 只负责更新第
\(i\)
个切片的参数,那么它在反向传播中就只需要属于该切片的归约梯度。在反向传播逐层算出梯度时,系统直接触发
Reduce-Scatter,仅将梯度聚合并发送给对应的分管 GPU。一旦归约完成,非本卡分管的梯度显存立即释放。 - 通信分析:
- 无全量梯度常驻显存:不再分配全量 \(2\Psi\) 梯度的常驻显存,仅分配局部切片 Buffer(\(\frac{2\Psi}{N_d}\))以及 1~2 个固定大小的临时 Bucket 显存用于通信。
- 按 Bucket 异步
Reduce-Scatter:反向传播计算梯度时,使用
ReduceScatter通信原语,同样按 Bucket 与计算异步重叠。 - 即时销毁(Discard on-the-fly):一旦某个 Bucket 的
ReduceScatter通信完成,当前 Rank 把属于自己的 \(\frac{1}{N_d}\) 梯度切片存入局部 Buffer 后,立刻把这个 Bucket 里非本 Rank 负责的其他梯度显存清空/释放。 - 每个 step 完成后进行
AllGather获取所有更新后参数。 - 梯度累积需要额外通信量:每个 micro-batch backward 时就要触发
ReduceScatter通信。
- 内存分析:
- 梯度显存从 \(2\Psi\) 降至 \(\frac{2\Psi}{N_d}\)。结合 \(P_{os}\),总模型状态显存开销降至 \(2\Psi + \frac{14\Psi}{N_d}\)。
4.3 \(P_p\): Parameter Partitioning
- 连 FP16 参数本身也切分 \(N_d\)
份,每张 GPU 仅永久存储分管的 \(\frac{1}{N_d}\)
参数切片。在前向传播和反向传播逐层计算时,利用神经网络的时间局部性,在前向/反向算到某一层之前,通过广播(
All-Gather)按需动态拉取全量参数,计算完成后立即丢弃非本地切片。 - 通信分析:
- 参数按层动态拉取与释放(FWD &
BWD):在前向和反向传播中,算到某一层/Bucket 前通过
pre_hook动态发起AllGather拉取该层全量 FP16 参数;计算完成后通过post_hook立即销毁临时参数 Buffer。 - 按 Layer 异步预取与 Overlap:前台计算当前 Layer
的同时,后台异步 Comm Stream 提前发起下一层(或反向上一层)参数的
AllGather预取,将参数拉取通信与计算完全 overlap。 - 梯度的 Reduce-Scatter
与即时销毁:反向传播算出的梯度填入临时 Bucket 后触发
Reduce-Scatter,通信完成后仅将本 Rank 负责的 \(\frac{1}{N_d}\) 梯度切片存入本地常驻 Buffer,其余非本地梯度立刻清空/释放。 - 取消 step 结尾的全局
AllGather:
optimizer.step()更新完本地 \(\frac{1}{N_d}\) 参数切片后无需在 step 结尾做全局参数AllGather,下一个 step 前向传播会自动按层重新拉取。 - 总通信量:单步总通信量为 \(3\Psi\)(前向拉取参数 \(1\Psi\) + 反向拉取参数 \(1\Psi\) + 梯度散列归约 \(1\Psi\)),相比标准 DP(\(2\Psi\))仅增加 50% 通信量。
- 梯度累积需要额外通信量:每个 micro-batch backward 时就要触发
AllGather和ReduceScatter通信。
- 参数按层动态拉取与释放(FWD &
BWD):在前向和反向传播中,算到某一层/Bucket 前通过
- 内存分析:
- 单卡模型状态显存直接降至 \(\frac{16\Psi}{N_d}\),与数据并行度 \(N_d\) 呈严格的线性反比关系。
4.4 Implication on Model Size
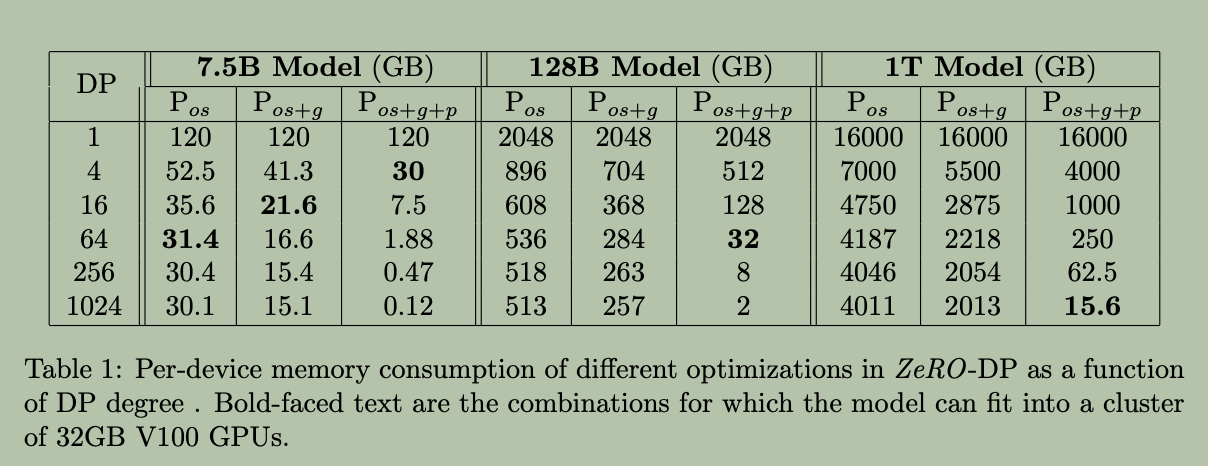
- 不同模型规模在不同 ZeRO/DP 设置下单 device 内存需求。
5. Deep Dive into ZeRO-R
5.1 \(P_a\): Partitioned Activation Checkpointing
- 在 MP 中,激活值在不同 device 间有重复。\(P_a\)
消除了这种冗余,在算完一层前向传播后,将激活检查点按照 MP 维度(度数为
\(N_m\))切分存储,每张 GPU 仅保存
\(\frac{1}{N_m}\)
的切片;在反向传播需要重计算时,通过
AllGather动态恢复全量激活值。 - \(P_{a+cpu}\)(CPU 卸载):对于极端超大模型,可进一步将切分后的激活检查点推送到 CPU 内存中存储,反向传播前夕再异步拉回 GPU。
- 通信分析:
- 反向重计算前增加了一次激活值的
AllGather通信,但对于 Transformer 架构,其算术强度大,增加的通信量仅占 MP 原生通信量的不足 10%。 - 节省出的显存允许开大 Batch Size,从而将数据并行的通信量降低,总体效率反而显著提升。
- 反向重计算前增加了一次激活值的
- 内存分析:
- 单卡激活检查点显存占用降低 \(N_m\) 倍。
5.2 \(C_B\) : Constant Size Buffers
- 机制:高性能分布式库(如 NVIDIA Apex 或
Megatron)为了提升通信吞吐,会在执行
AllReduce或计算梯度范数(Gradient Norm)时,将离散张量打平并融合进一个连续的临时 Buffer 中。在传统实现中,该 Buffer 的大小与模型参数量成正比(例如 3B 参数模型的 FP32 融合 Buffer 会独占 12 GB 显存)。 - 优化:\(C_B\) 强制使用高性能的常数大小缓冲区,其容量上限被锁死在固定数值(如几十 MB),完全不随模型参数量的膨胀而增长。
5.3 \(M_D\): Memory Defragmentation
- 机制:显存碎片产生于训练过程中长生命周期张量与短生命周期张量的频繁交错申请与释放:
- 前向传播:长生命周期的激活检查点与短生命周期的重算中间激活值交错。
- 反向传播:长生命周期的参数梯度与短生命周期的激活梯度交错。 这种割裂会导致系统即便拥有 30% 以上的空闲显存,也可能因找不到足够的连续空间而触发 OOM,或导致分配器耗费大量 CPU 时间检索连续块。
- 优化:\(M_D\) 采用在线去碎片策略,为激活检查点和梯度提前预分配连续内存大块(Pre-allocated Contiguous Buffers)。张量一经生成便直接拷贝存入该连续区域。
6. Communication Analysis of ZeRO-DP
6.1 Data Parallel Communication Volume
- backward 时需要进行梯度的 AllReduce 操作,具体由以下两个步骤组成:
- ReduceScatter
- AllGather
- 两步通信量都是 \(\Psi\) ,总通信量为 \(2\Psi\) 。
6.2 ZeRO-DP Communication Volume
6.2.1 Communication Volume with \(P_{os+g}\)
- backward 时进行 ReduceScatter 通信,获取每个进程对应分片梯度 reduce 后结果。
- 每个进程更新完自己负责参数后,进行 AllGather 通信,获取全量更新后参数。
- 总通信量 \(2\Psi\) 与 DP 完全相同。
6.2.2 Communication Volume with \(P_{os+g+p}\)
- 通信过程如下:
- 前向传播(FWD):按层/Bucket 动态通过
AllGather拉取全量 FP16 参数,传输量为 \(\Psi\)。 - 反向传播(BWD):再次按层/Bucket 动态通过
AllGather拉取全量 FP16 参数,传输量为 \(\Psi\)。 - 梯度归约:反向传播算出的梯度通过
ReduceScatter归约散列至分管 Rank,传输量为 \(\Psi\)。
- 前向传播(FWD):按层/Bucket 动态通过
- \(P_p\) 单步总通信量为 \(3\Psi\),仅为标准 DP 通信量的 1.5 倍。
7. Communication Analysis of ZeRO-R
\(P_a\)(激活检查点切分)对模型并行(MP)通信的影响
- 通信增加量分析:在标准的 Megatron-LM
模型并行中,每个 Transformer 模块(包含 FWD、FWD 重计算、BWD)共触发 6
次
AllReduce,总通信量为 \(12 \times \text{seq\_len} \times \text{hidden\_dim}\)。开启 \(P_a\) 后,仅需在反向传播重计算前对激活检查点发起 1 次AllGather,通信量仅为 \(1 \times \text{seq\_len} \times \text{hidden\_dim}\)。 - 结论:\(P_a\) 带来的额外通信开销不足原生 MP 通信量的 10%。
\(P_a\) 对数据并行(DP)通信的间接优化(MP + DP 混合场景)
- 显存与 Batch Size 联动:\(P_a\) 将激活检查点显存压减 \(N_m\) 倍(MP 度数,例如在 DGX-2 节点上 \(N_m = 16\)),允许单卡 Batch Size 提升高达 \(N_m\) 倍。
- DP 通信量大幅降低:由于数据并行(DP)的通信开销与 Batch Size 呈反比,通过 \(P_a\) 扩大的 Batch Size 可以使 DP 通信量降低一个数量级。
- Trade-off 收益:仅以增加小于 10% 的 MP(节点内/高带宽)通信量为代价,换取了 DP(跨节点/低带宽)通信量降低一个数量级,大幅提升了系统的整体吞吐。
\(P_{a+cpu}\)(激活 CPU 卸载)的通信 Trade-off
- PCIe 数据搬运代价:将切分后的激活检查点卸载至 CPU 内存,相比 \(P_a\) 增加了 2 倍的 PCIe 双向数据传输(GPU 到 CPU 写入,CPU 到 GPU 读回)。
- 适用条件:当单卡显存极度紧张导致 Batch Size 过小、DP 通信成为严重性能瓶颈时开启。只要 PCIe 搬运延迟小于 DP 通信被压缩节省出的时间,系统就能实现吞吐的净提升。
8. Step Towards 1 Trillion Parameters
- MP 存在的问题与 ZeRO 解决方法:
- 传统 SOTA 框架(如 Megatron-LM)仅能在单个 DGX-2 节点内高效扩展 16~20B 参数的模型;一旦跨节点扩展模型并行(MP),会因节点间带宽限制(从 NVLink 300 GB/s 降至 InfiniBand 12.5 GB/s)导致吞吐剧烈下降。
- ZeRO 彻底打破了这一瓶颈:开启全部优化(\(P_{os+g+p}\))时,仅靠纯数据并行(DP)即可在 1024 张 GPU 上训练 1 万亿(1 Trillion)参数的模型;若结合节点内 16 路模型并行(MP=16)与跨节点 64 路数据并行(DP=64),同样能在 1024 张 GPU 上高效装下并训练万亿参数模型。
- 算力差距与资源挑战:
- 虽然 ZeRO 从系统架构和显存层面解决了万亿参数模型“装得下、跑得动”的问题,但当前硬件集群的算力(FLOPs)不允许在合理时间内训练 1T 参数量模型。
9. Conclusion
- ZeRO
- ZeRO 1:
- 切分优化器状态;
- backward 时
ReduceScatter获取梯度 Reduce 后结果分片,更新本 rank 负责的参数切片; - step 末尾:
AllGather获取全部更新后的参数;
- ZeRO 2:
- 切分优化器状态+梯度;
- backward 时
ReduceScatter获取梯度 Reduce 后结果分片;每个 micro-batch backward 时都需要触发ReduceScatter通信; - 每个 step 完成后
AllGather通信获取全部更新后参数。
- ZeRO 3:
- 切分优化器状态+梯度+参数;
- forward/backward 时都需要先
AllGather获取本层全量参数;backward 时每个 micro-batch 都需要ReduceScatter通信获取梯度 Reduce 后的结果分片; - 通信量对比普通 DP 增加 50%。
- ZeRO 1:
- 其他内存优化方法:
- 结合 MP 切分激活值 & offload 激活值到 CPU。
- 固定常量 buffer 大小,兼顾内存效率与计算/通信效率。
- 预先分配连续内存,消除内存碎片。