TensorFlow: A system for large-scale machine learning
TensorFlow: A system for large-scale machine learning
- OSDI 2016
- paper link
阅读该 paper 主要要了解:
- TensorFlow 诞生背景
- DistBelief 存在的问题
- 设计原则
- 关键概念&实现(TensorFlow execution model)
- 如何支持大规模训练(Extensibility case studies)
Background & Motivation
DistBelief 存在的问题:
- Defining new layers:实现新层时需要使用 C++(machine learning researchers 一般并不熟悉)。
- Refining the training algorithms:由于 PS 架构限制,不能方便的修改优化算法的实现(需要修改 server)。
- Defining new training algorithms:PS 架构无法实现一些更复杂的模型训练,如:RNN、GAN、RL 算法模型等。
- 专为大规模神经网络在数据中心训练设计,难以适配更多的其他环境,如:
- 提交数据中心训练前在本地工作站运行 debug
- 训练完成后部署为在线服务
- 手机等设备部署
Design principles
TensorFlow 核心抽象:
- dataflow-based programming abstraction that allows users to deploy applications on distributed clusters, local workstations, mobile devices, and custom-designed accelerators.
示例代码:
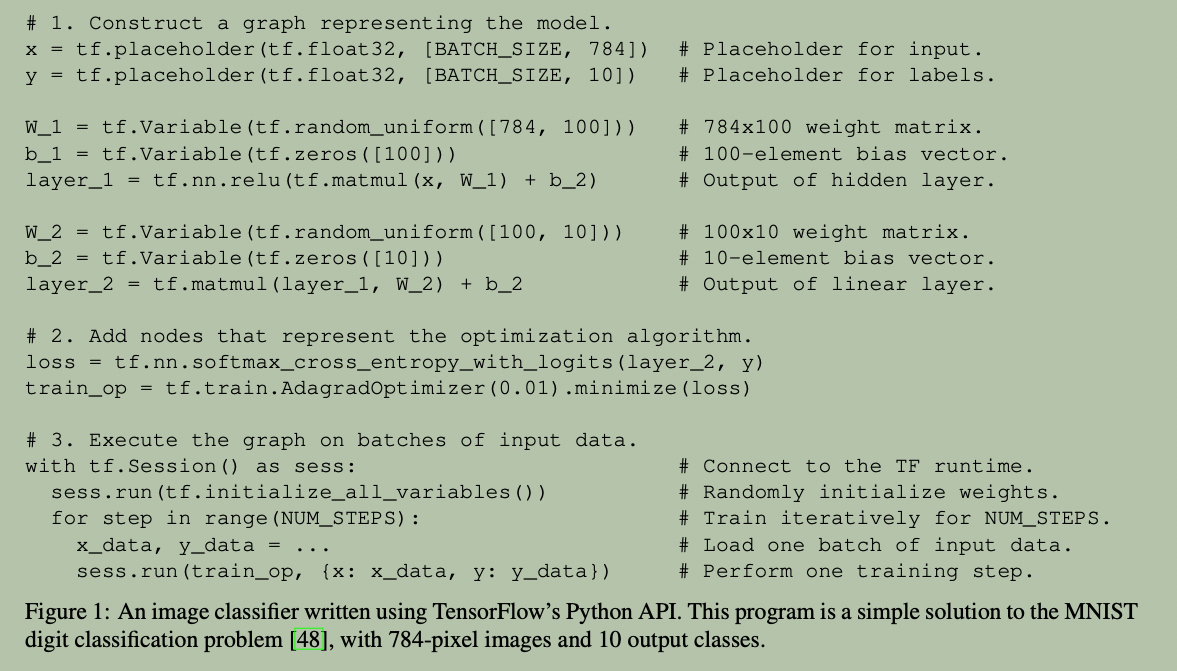
核心设计原则:
- Dataflow graphs of primitive operators:
- 使用 dataflow 表示模型
- 数据(tensor)通过算子(functional operators)表示流动,组织为计算图(dataflow)
- Deferred execution:
- 两阶段:定义 -> 执行
- the first phase defines the program (e.g., a neural network to be trained and the update rules) as a symbolic dataflow graph with placeholders for the input data and variables that represent the state.
- the second phase executes an optimized version of the program on the set of available devices.
- 静态图,能够感知更多信息,进行更好的优化
- 例如:利用计算图的结构,同时 launch 多个互相独立的 kernel,以提高 GPU 利用率。
- 缺点:control flow 实现更复杂,需要显式作为节点表示在计算图中。
- 两阶段:定义 -> 执行
- Common abstraction for heterogeneous accelerators:
- 支持 CPU、GPU、TPU 等不同 device
- 支持不同 device 的抽象(device 必须实现的方法):
- issuing a kernel(某个 operator 的实现) for execution
- allocating memory for inputs and outputs
- transferring buffers to and from host memory
- 例如:矩阵乘法可以在不同 device 上有不同的实现版本
TensorFlow execution model
Dataflow graph elements
TensorFlow 计算图的基本构成:顶点代表操作(Operation),边代表张量(Tensor)。即计算由操作完成,数据以张量形式在边上游走。
Tensors
- 本质:n
维数组,元素类型为少数原始类型(
int32、float32、string)。 - 自然对应常见数学运算的输入和输出:
- 矩阵乘法:两个 2-D 张量 → 一个 2-D 张量
- 批量 2-D 卷积:两个 4-D 张量 → 另一个 4-D 张量
Operations
- 接受 \(m \ge 0\) 个张量作为输入,产生 \(n \ge 0\) 个张量作为输出。
Stateful operations: variables
- 拥有一个可变缓冲区,用于存储训练中模型的共享参数。
- 无输入,产生一个引用句柄(reference handle),作为读写缓冲区的类型化能力。
Read操作:输入引用句柄 \(r\),输出变量的值 \(\text{State}[r]\)(稠密张量)。- 修改操作:如
AssignAdd输入引用句柄 \(r\) 和张量值 \(x\),执行 \(\text{State}[r] \leftarrow \text{State}[r] + x\)。后续Read(r)会输出更新后的值。
Stateful operations: queues
- 支持更高级的协调机制。
- 最简单的是
FIFOQueue,拥有内部张量队列,支持并发访问,按先进先出顺序。 - 其他队列:随机顺序、优先级顺序,确保输入数据被适当地采样。
- 类似
Variable,FIFOQueue也产生引用句柄,可被标准队列操作消费:Enqueue:将输入推入队尾。Dequeue:弹出队首元素并输出。
- 阻塞行为:
Enqueue在队列满时阻塞。Dequeue在队列空时阻塞。- 在输入预处理流水线中,这种阻塞提供背压(backpressure),并支持同步。
- 队列 + 动态控制流可以实现子图之间的流式计算(streaming computation)。
补充:概念模型 vs 实现视角
- 论文视角:顶点 = 操作,边 = 张量。这是经典数据流架构的纯粹定义,张量无独立身份,是边上的值。
- 实现视角(如 minitorch):节点 = 操作 +
数据节点,张量是节点的
output属性,边隐含在input_nodes引用中。 - 两者描述同一张 DAG,只是抽象层次不同:一个以边为中心,一个以节点为中心。
Partial and concurrent execution
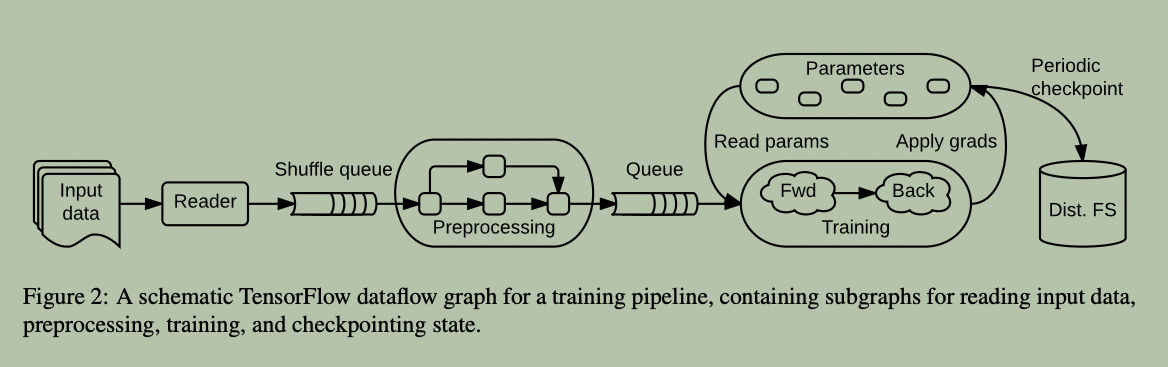
- TensorFlow 用一张数据流图表示应用中所有可能计算,但执行时只执行客户端声明所需的子图。
- 客户端通过
feed指定输入边、fetch指定输出边;运行时剪枝图,仅保留必要操作。 - 每次 API 调用称为一个 step;同一张图上支持多个 step 并发执行。
- 有状态操作(变量、队列)允许 step 间共享数据,并在需要时同步。
- 上图表示的典型训练应用包含多个并发子图:
- 核心训练子图:依赖模型参数和输入队列,多个 step 基于不同批次更新模型 → 数据并行训练。
- 预处理子图:解码、扰动输入记录,填充输入队列。
- I/O 子图:从分布式文件系统读取记录。
- 检查点子图:周期性运行,用于容错。
- 灵活性来源:可变状态 + 队列协调,使用户能在用户级代码中定义复杂训练流程,无需修改运行时。
- 默认并发执行是异步的,适合弱一致性算法(如异步 SGD);TensorFlow 也提供同步原语以支持同步训练。
Distributed execution
TensorFlow 通过数据流图显式表达子计算之间的通信,使同一程序可部署到 GPU 集群、TPU 集群或手机。本节回答两个问题:
1. 计算图如何映射到 device(Placement)
- 每个操作驻留在特定设备(CPU/GPU/TPU 等)上;设备负责执行分配给它的操作的内核(kernel)。
- 同一操作可注册多个内核,针对特定设备或数据类型特化;逐元素操作(Add、Sub 等)可用不同编译器为 CPU/GPU 编译同一份内核。
- 放置算法:为每个操作计算可行设备集,计算必须同置(colocated)的操作集,并为每个同置组选择满足条件的设备。
- 隐式约束:有状态操作及其状态必须在同一设备。
- 显式约束:用户可指定部分设备偏好,如“某 task 中任意设备”或“任意 task 中的 GPU”;典型训练应用通过客户端编程结构添加约束,例如将参数分布到一组 PS 任务。
- 灵活性:简单启发式对新手够用;专家可手动放置以平衡多任务、多设备间的计算、内存和网络需求。
2. 分布式执行时计算图如何划分,引入哪些通信
- 放置后,针对一个 step 的部分子图,TensorFlow 将操作划分成 per-device 子图。
- 设备 \(d\) 的子图包含分配给 \(d\) 的所有操作;跨设备边界的边被替换为
Send和Recv操作。 Send:单输入,张量可用时立即发送到指定设备,用 rendezvous key 命名值。Recv:单输出,阻塞直到指定 rendezvous key 的值在本地可用,然后产生该值。Send/Recv对多种设备类型对有特化实现(§5)。- 优化低延迟重复执行:剪枝、放置、分区后,子图缓存在各自设备;客户端 session 维护 step 定义到缓存子图的映射,大图上的分布式 step 只需向每个参与任务发一个小消息即可启动。节)。
Dynamic control flow
核心原语(借用自经典动态数据流架构)
- Switch(解复用器):输入一个数据和一个控制信号,由控制信号决定两个输出中哪一个产生值;未被选中的输出收到特殊的
dead value,该值递归传播到图中的
Merge。 - Merge(复用器):至多将一个非 dead 输入转发到输出;若两个输入都是 dead,则输出 dead。
- Conditional(if):用
Switch根据运行时布尔张量执行两个分支之一,用Merge合并分支输出。 - While loop:更复杂,使用
Enter、Exit、NextIteration算子保证循环结构良构。
分布式执行与自动微分
- 迭代执行可重叠;条件分支与循环体可跨多设备/多进程划分。
- 分区步骤增加协调逻辑:协调每个设备上每次迭代的开始与终止,并决定循环的终止。
- TensorFlow 支持对控制流构造自动微分:
- 自动微分把计算梯度的子图加入数据流图。
- TensorFlow 将其划分到(可能分布式的)设备上并行计算梯度。
- 实现方式:在前向传播中记录控制流决策,在反向传播中按逆序重放这些决策。
Extensibility case studies
Differentiation and optimization
TensorFlow 支持自动求导,其实现就是 LLM Systems 课程中介绍的经典步骤:
- 拓扑排序
- 反向传播,支持多路梯度累加
对控制流求导的支持:
- We have extended the algorithm to differentiate conditional and iterative subcomputations by adding nodes to the graph that record the control flow decisions in the forward pass, and replaying those decisions in reverse during the backward pass.
- 核心:记录 forward 时决策,backward 时重放以选择正确的反向传播路径。
Training very large models
语言模型的 word embedding 占据大量参数。
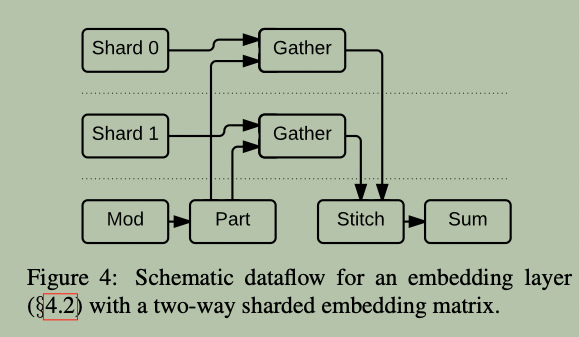
- Shard 0 / Shard 1:按行分片的 embedding 变量,分布在不同的 PS 任务上。
Gather:从分片张量中提取稀疏行;与对应变量同置(colocate),避免把参数搬到 worker 再计算。Part(dynamic partition):把输入索引按目标分片划分成变长张量,决定哪些索引去哪个 shard。Stitch(dynamic stitching):把各分片的部分结果重新组装成单个结果张量。Sum:图中示意最终聚合结果。- 每个算子都有对应梯度 → 支持自动微分(§4.1) → 反向产生稀疏更新,只作用于最初被 gather 的值。
Fault tolerance
- We implement user-level checkpointing for fault tolerance.
- Save
- Restore
Implementation
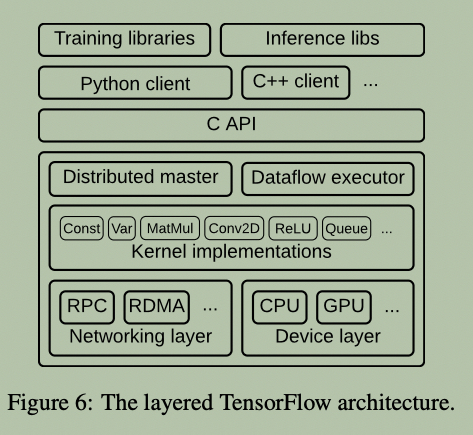
- The core TensorFlow library: implemented in C++ for portability and performance.
- The distributed master: translates user requests into execution across a set of tasks. Also do possible optimization.
- The dataflow executor in each task:handles requests from the master, and schedules the execution of the kernels that comprise a local subgraph. dispatches kernels to local devices and runs kernels in parallel when possible.
- Specialize Send and Recv operations for each pair of source and
destination device types.
cudaMemcpyAsync- DMA
- For transfers between tasks, TensorFlow uses multiple protocols, including gRPC over TCP, and RDMA over Converged Ethernet.
- Client languages:Python & C++.
- 总结:C API 分离用户代码与核心运行时;Distributed master 负责剪枝、分区和跨任务协调;Dataflow executor 负责本地子图调度与并行执行;Networking 和 Device 层分别处理通信与设备特化。
TensorFlow: A system for large-scale machine learning
https://arcsin2.cloud/posts/2026/10/3469689404/