Transformer: Attention Is All You Need
- Attention Is All You Need
- 发表于 NIPS 2017(arXiv 提交日期:12 Jun 2017)
- 作者:
Abstract
主流的序列转换模型基于复杂的循环或卷积神经网络,这些网络包含一个编码器和一个解码器。性能最佳的模型还通过注意力机制连接编码器和解码器。我们提出了一种新的简单网络架构——Transformer,它完全基于注意力机制,彻底摒弃了循环和卷积。在两个机器翻译任务上的实验表明,Transformer 模型在翻译质量上更优,同时更具并行性,训练时间显著减少。我们的模型在 WMT 2014 英德翻译任务上达到了 28.4 BLEU,比现有的最佳结果(包括集成模型)高出 2 BLEU 以上。在 WMT 2014 英法翻译任务上,我们的模型在 8 个 GPU 上训练 3.5 天后,建立了新的单模型最优 BLEU 分数 41.8,这只是文献中最佳模型训练成本的一小部分。我们通过将 Transformer 成功应用于大规模和有限训练数据下的英语成分句法分析,表明它能很好地泛化到其他任务。
1. Introduction
在 Transformer 论文发表的 2017 年,序列建模/翻译等任务的 SOTA 模型还是 RNN、LSTM、Gated RNN 模型。这些模型的循环特性:根据隐藏状态 \(h_{t-1}\) 和位置 \(t\) 的输入(\(x_{t}\)),更新隐藏状态到 \(h_{t}\),即:\(h_{t} = f\left( h_{t-1}, x_{t} \right)\) 。这种内在的顺序依赖性,限制了循环模型的并行性和训练效率(尤其是在处理长序列输入时,这种限制更加明显)。
在当时,一些模型已经引入了注意力机制,连接 encoder 和 decoder,并在不少任务上取得了不错的效果。注意力机制对比循环模型最大区别是:它允许对输入或输出序列中的依赖关系进行建模,而 不必考虑其距离(RNN 后面的词如果要感知前面词的信息,必须通过 \(h_{t} = f\left( h_{t-1}, x_{t} \right)\) 公式进行多次循环迭代;而注意力机制每个位置可以直接和序列中任意位置直接计算建模关系)。
在本文中,作者提出了一种摒弃循环、转而完全依赖注意力机制来捕捉输入与输出之间全局依赖的模型架构:Transformer。Transformer 允许显著更多的并行化,并且在 8 块 P100 GPU 上训练仅 12 小时后,就能达到翻译质量的新最优水平。
2. Background
为了解决 RNN 难以并行的问题,Extended Neural GPU、ByteNet 和 ConvS2S 提出了使用卷积神经网络来并行计算所有输入和输出位置的隐藏表示。但是,这些模型 关联来自两个任意输入或输出位置的信号所需的操作数 随位置之间的距离增长:ConvS2S 为线性增长,ByteNet 为对数增长。这使得学习远距离位置之间的依赖关系更加困难。在 Transformer 中,这一操作数被减少到 常数 级别,尽管代价是由于对注意力加权位置进行平均而降低了有效分辨率;通过 3.2 节所述的多头注意力来抵消这一影响。
自注意力,有时也称为内部注意力,是一种 将单个序列的不同位置相互关联 以计算该序列表示的注意力机制。自注意力已成功应用于多种任务,包括阅读理解、摘要总结、文本蕴含以及学习任务无关的句子表示。
端到端记忆网络(End-to-end memory networks)基于 循环注意力机制(在记忆上进行多次迭代的注意力读取,引入了注意力机制但是仍有循环结构),而不是序列对齐的循环(即 RNN 的形式),并且已被证明在简单语言问答和语言建模任务上表现良好。
Transformer 是第一个完全依赖自注意力来计算其输入和输出表示、而不使用序列对齐 RNN 或卷积的转换模型。下文将描述 Transformer,阐明自注意力的动机,并讨论其相对于当时已有的部分其他模型的优势。
3. Model Architecture
大多数性能好的序列转换模型具有 encode-decoder 架构,其中 encoder 负责将输入序列 \(\left( x_1, x_2, ..., x_n \right)\) 映射为连续表示 \(\mathbf{z} = \left(z_1, z_2, ..., z_n\right)\) 。给定 \(\mathbf{z}\),decoder 每次生成输出序列 \(\left(y_1, y_2, ..., y_m \right)\) 中一个符号。在逐个符号生成时,模型是 自回归的(auto-regressive),每次生成时把之前生成的符号作为额外的输入。
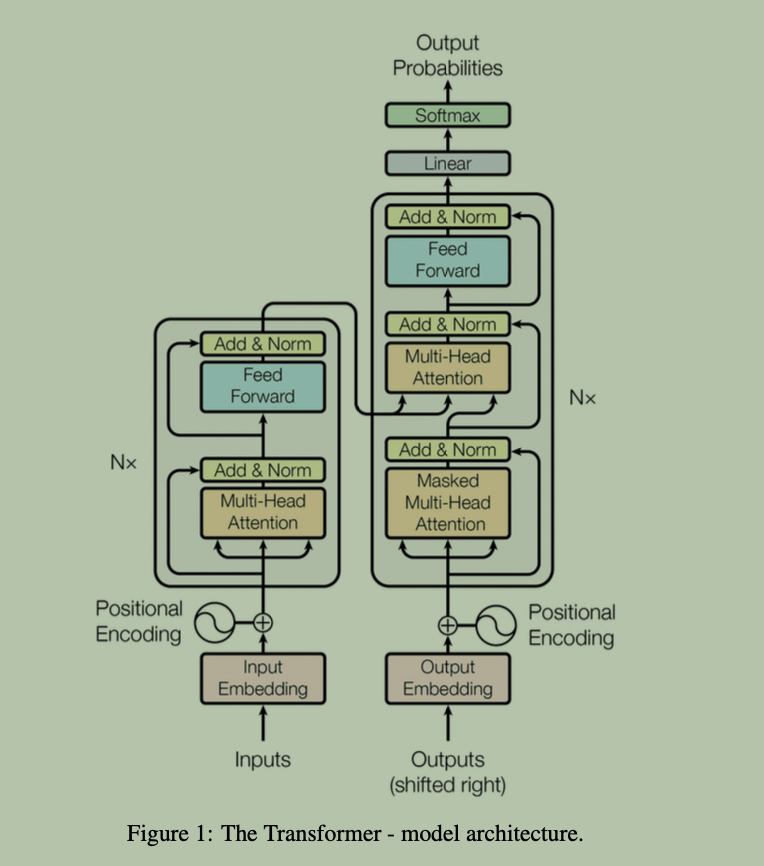
Transformer 沿用了这一整体架构,对 encoder 和 decoder 都使用堆叠的自注意力层和逐位置的全连接层,分别如图 1 的左半部分和右半部分所示。
3.1 Encoder and Decoder Stacks
Encoder: Encoder 由 \(N = 6\) 个架构完全相同的层堆叠而成。每层内包括两个子层。第一个是多头自注意力机制;第二个是简单的全连接 FFN。在两个子层周围采用了残差连接,然后跟着一个 Layer Norm。也就是说,每个子层的输出是:\(\text{LayerNorm}\left( x + \text{Sublayer}\left(x\right) \right)\) ,其中 \(\text{Sublayer}\left(x\right)\) 是子层的实现函数。为了便于这些残差连接,模型中的所有子层以及嵌入层都产生维度 \(d_{model} = 512\) 的输出。
Decoder: Decoder 同样由 \(N = 6\) 个架构完全相同的层堆叠而成。除了每个 encoder layer 中的两个子层外,decoder 还插入了第三个子层,该子层对 encoder 的输出执行多头注意力。与 encoder 类似,在每个子层周围采用残差连接,随后进行 Layer Norm。此外,还修改了 decoder 中的自注意力子层(图 1 右下角的子层)以防止位置关注后续位置。这种掩码,结合输出嵌入偏移一个位置这一事实,确保了位置 \(i\) 的预测只能依赖于小于 \(i\) 的位置上的已知输出。
3.2 Attention
注意力函数可以描述为将一个查询和一组键值对映射到一个输出,其中查询、键、值和输出都是向量。输出被计算为值的加权和,其中分配给每个值的权重由查询与相应键的兼容性函数(compatibility function)计算得出。
3.2.1 Scaled Dot-Product Attention
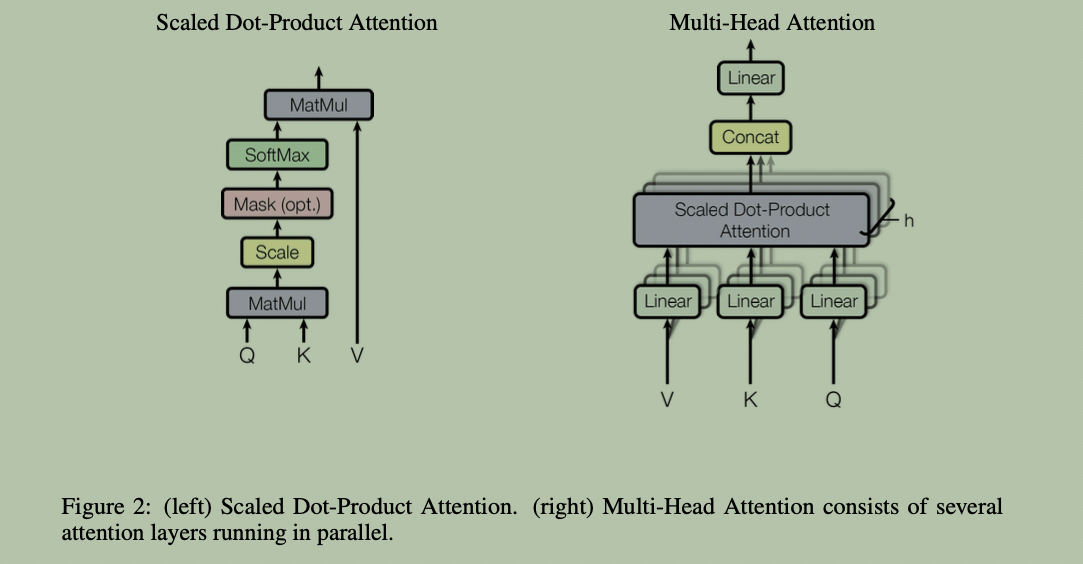
本文采用的 Attention 主要改动在于引入了 “scaled”,也就是除以 \(\sqrt{d_{k}}\) 这个操作,作者称其为 “缩放点积注意力”(Scaled Dot-Product Attention)(上述图 2)。输入由维度为 \(d_k\) 的查询和键,以及维度为 \(d_v\) 的值组成。计算查询与所有键的点积,将每个点积除以 \(\sqrt{d_k}\),然后应用 softmax 函数以获得作用于值的权重。
在实践中,同时在一组查询上计算注意力函数,将它们打包成矩阵 \(Q\)。键和值也分别打包成矩阵 \(K\) 和 \(V\)。按如下方式计算输出矩阵:
\[ \text{Attention}(Q,K,V)=\text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V \tag{1} \]
两种最常用的注意力函数是加性注意力和点积(乘法)注意力。点积注意力与本文算法相同,只是少了 \(\frac{1}{\sqrt{d_k}}\) 这一缩放因子。加性注意力使用一个带有单个隐藏层的前馈网络来计算兼容性函数。虽然两者在理论复杂度上相似,但在实践中,点积注意力要快得多,也更节省空间,因为它可以使用高度优化的矩阵乘法代码来实现。
当 \(d_k\) 较小时,两种机制表现相似;但当 \(d_k\) 较大时,未缩放的加性注意力优于点积注意力。可能的原因是,对于较大的 \(d_k\),点积的数值会变得很大,从而将 softmax 函数推入梯度极小的区域。为了抵消这种影响,将点积缩放 \(1/\sqrt{d_k}\)。
为了说明点积为何会变大,假设 \(q\) 和 \(k\) 的分量是均值为 0、方差为 1 的独立随机变量。那么它们的点积 \(q \cdot k = \sum_{i=1}^{d_k} q_i k_i\) 的均值为 0,方差为 \(d_k\)。
补充:为什么 scaled 能改善梯度?
设 softmax 输入为 \(z_i\),输出为 \(p_i\):
\[ p_i=\frac{e^{z_i}}{\sum_j e^{z_j}},\qquad \frac{\partial p_i}{\partial z_i}=p_i(1-p_i) \]
这里 \(z_i\) 是第 \(i\) 个位置的 query-key 点积分数,\(p_i\) 是归一化后的注意力权重。当 \(p_i\) 接近 \(0\) 或 \(1\) 时,导数趋近于 \(0\),即 softmax 进入饱和区,梯度消失。
点积 \(q\cdot k\) 的方差为 \(d_k\),所以 \(d_k\) 越大,点积数值越大、波动越剧烈,softmax 越容易饱和。除以 \(\sqrt{d_k}\) 后:
\[ \operatorname{Var}\left(\frac{q\cdot k}{\sqrt{d_k}}\right)=1 \]
softmax 输入尺度被拉回稳定范围,避免进入梯度极小区,训练更稳定。
3.2.2 Multi-Head Attention
本文没有使用 \(d_{\text{model}}\) 维的键、值和查询来执行单一的注意力函数,而是将查询、键和值用不同的、可学习的线性投影进行 \(h\) 次线性投影,分别投影到 \(d_k\)、\(d_k\) 和 \(d_v\) 维。然后,在这些投影后的查询、键和值版本上,并行地执行注意力函数,产生 \(d_v\) 维的输出值。这些输出值被拼接起来,并再次进行投影,得到最终的值,如上面图 2 所示。
多头注意力允许模型在不同位置同时关注来自不同表示子空间的信息。如果只有一个注意力头,平均操作会抑制这一点。
\[ \text{MultiHead}(Q,K,V)=\text{Concat}(\text{head}_1,\dots,\text{head}_h)W^O \]
其中
\[ \text{head}_i=\text{Attention}(QW_i^Q,KW_i^K,VW_i^V) \]
这里的投影是参数矩阵 \(W_i^Q \in \mathbb{R}^{d_{\text{model}}\times d_k}\),\(W_i^K \in \mathbb{R}^{d_{\text{model}}\times d_k}\),\(W_i^V \in \mathbb{R}^{d_{\text{model}}\times d_v}\),以及 \(W^O \in \mathbb{R}^{h d_v \times d_{\text{model}}}\)。
本文采用 \(h=8\) 个注意力头。对于每一个头,使用 \(d_k=d_v=d_{\text{model}}/h=64\)。由于每个头的维度降低,总计算成本与全维度的单头注意力相似。
3.2.3 Applications of Attention in our Model
Transformer 以三种不同方式使用多头注意力:
- 在 “encoder-decoder attention” 层(图一右中)中,查询来自前一个 decoder 层,而记忆的键和值来自 decoder 的输出。这允许 decoder 中的每个位置关注输入序列中的所有位置。这模仿了序列到序列模型中典型的 encoder-decoder 注意力机制。
- encoder 包含自注意力层。在自注意力层中,所有键、值和查询都来自同一处,在这里是 encoder 前一层的输出。encoder 中的每个位置可以关注 encoder 前一层的 所有位置。
- 类似地,decoder 的自注意力层允许 decoder 中的每个位置关注 decoder 中直到并包括该位置的所有位置。为了防止 decoder 中的信息向左流动,以保持自回归特性,通过在缩放点积注意力内部将 softmax 输入中所有对应非法连接的数值掩蔽掉(设为 \(-\infty\))来实现这一点。见图 2。
3.3 Position-wise Feed-Forward Networks
FFN 子层(带有 ReLU 激活函数):
\[ \text{FFN}\left(x\right) = \max\left( 0, xW_1 + b_1 \right)W_2 + b_2 \tag{2} \]
FFN 输入和输出维度是 \(d_{model} = 512\),中间层维度是 \(d_{ff} = 2048\)。
3.4 Embeddings and Softmax
与其他序列转换模型类似,Transformer 使用可学习的 embeddings 将输入 tokens 和输出 tokens 转换为维度为 \(d_{\text{model}}\) 的向量;使用可学习线性变换和 softmax 函数,将 decoder 输出转换为预测的下一 token 概率。在 Transformer 模型中,在两个 embedding 层和 pre-softmax 线性变换之间共享同一个权重矩阵。在 embedding 层中,将这些权重乘以 \(\sqrt{d_{\text{model}}}\)。
为什么 embedding 层权重需要乘以 \(\sqrt{d_{\text{model}}}\) ?
embedding 矩阵通常用较小的随机值初始化,例如均值为 0、方差为 \(\frac{1}{d_{\text{model}}}\),因此 embedding 向量每个元素的尺度约为 \(\frac{1}{\sqrt{d_{\text{model}}}}\)。而位置编码使用 sin/cos 函数,每个维度的值大致在 \([-1,1]\) 内,尺度相对固定。
如果直接把 embedding 与位置编码相加,位置编码的数值会明显大于 embedding,导致位置信息压过词义信息。乘以 \(\sqrt{d_{\text{model}}}\) 后:
\[ \frac{1}{\sqrt{d_{\text{model}}}} \times \sqrt{d_{\text{model}}} = 1 \]
embedding 向量的元素尺度被拉到约 1,与位置编码的尺度大致匹配。这样两者相加时贡献更均衡,不会一方主导另一方,有助于训练稳定。
3.5 Positional Encoding
由于 Transformer 模型结构不包含循环、卷积,为了使模型能够利用序列的顺序,必须注入一些关于序列中 tokens 的相对或绝对位置的信息。为此,在 encoder 和 decoder 底部的输入 embeddings 上加上“位置编码”。位置编码与 embeddings 具有相同的维度 \(d_{\text{model}}\),因此两者可以相加。位置编码有很多选择,可以是学习得到的,也可以是固定的。
本文使用不同频率的正弦和余弦函数:
\[ PE_{(pos, 2i)} = \sin\left(\frac{pos}{10000^{2i/d_{\text{model}}}}\right) \]
\[ PE_{(pos, 2i+1)} = \cos\left(\frac{pos}{10000^{2i/d_{\text{model}}}}\right) \]
其中 \(pos\) 是位置,\(i\) 是维度。也就是说,位置编码的每个维度对应一个正弦曲线。波长从 \(2\pi\) 到 \(10000 \cdot 2\pi\) 形成等比数列。选择这个函数,是因为假设它能让模型很容易地学会按相对位置进行关注,因为对于任何固定的偏移量 \(k\),\(PE_{pos+k}\) 都可以表示为 \(PE_{pos}\) 的线性函数。
本文还尝试了使用学习得到的位置 embeddings,并发现这两种版本产生了几乎相同的结果。最终选择正弦版本,因为它可能使模型能够外推到比训练期间遇到的序列长度更长的序列。
关于位置编码补充说明
波长计算与等比数列
第 \(i\) 个维度的波长为
\[ \lambda_i = \frac{2\pi}{10000^{-2i/d_{\text{model}}}} = 2\pi \cdot 10000^{2i/d_{\text{model}}} \] 相邻维度波长比为
\[ \frac{\lambda_{i+1}}{\lambda_i} = 10000^{2/d_{\text{model}}} \] 因此构成等比数列。以 \(d_{\text{model}}=512\) 为例,公比为
\[ 10000^{1/256} = 10^{1/64} \approx 1.0366 \] 波长从 \(2\pi \approx 6.283\) 开始,到 \(i=255\) 时约为 \(60600\),接近 \(10000 \cdot 2\pi \approx 62830\)。为什么选择 10000
10000 是经验性折中,决定了最低频率和最长波长。最长波长约为 \(10000 \cdot 2\pi \approx 62832\),足以覆盖常见训练序列长度(如 512、1024、2048)。它不是硬性截断,理论上可计算任意长序列,但序列远长于训练长度时,低频维度的相位会进入模型未见过的区域,外推效果有限。后续工作(如相对位置编码、RoPE)专门改进这一问题。维度越大频率越低、波长越长
维度索引 \(i\) 增大 \(\Rightarrow\) \(10000^{2i/d_{\text{model}}}\) 增大 \(\Rightarrow\) 频率降低 \(\Rightarrow\) 波长变长。
设计目的:类比二进制多尺度编码,高频维度捕捉局部顺序,低频维度捕捉全局结构;多频率组合保证每个位置编码唯一;同时让相对位置偏移 \(k\) 表现为 \(PE_{pos}\) 的线性函数,便于模型学习相对位置关系。相位 \(pos / 10000^{2i/d_{\text{model}}}\) 的取值范围
对固定 \(pos\),当 \(i=0\) 时分母为 1,相位最大为 \(pos\);当 \(i\) 最大时分母接近 10000,相位约为 \(pos/10000\)。
全局 \(pos \in [0, L-1]\),所以相位大致在 \(0\) 到 \(L-1\) 之间。例如 \(d_{\text{model}}=512\)、\(L=512\) 时:- \(i=0, pos=511\):相位为 \(511\);
- \(i=255, pos=511\):相位约为 \(511/9646 \approx 0.053\)。
- \(i=0, pos=511\):相位为 \(511\);
关于线性的说明
论文说“对于任何固定偏移 k,PE_{pos+k} 可以表示为 PE_{pos} 的线性函数”,这里的“线性”不是指位置编码作为 pos 的函数是线性的,而是指:
存在一个只依赖 k、与 pos 无关的矩阵 M_k,使得: \[ PE_{pos+k}=M_k\,PE_{pos} \] 虽然每个分量是 sin/cos,但由三角函数的和角公式,它们恰好满足这种线性关系。
对每一对维度 \((2i,2i+1)\),频率为
\[
\omega_i=\frac{1}{10000^{2i/d_{\text{model}}}}
\]
有
\[
PE_{pos,2i}=\sin(\omega_i pos),\qquad
PE_{pos,2i+1}=\cos(\omega_i pos)
\]
偏移 \(k\) 后:
\[ \sin(\omega_i(pos+k)) = \sin(\omega_i pos)\cos(\omega_i k) + \cos(\omega_i pos)\sin(\omega_i k) \]
\[ \cos(\omega_i(pos+k)) = \cos(\omega_i pos)\cos(\omega_i k) - \sin(\omega_i pos)\sin(\omega_i k) \]
写成矩阵形式:
\[ \begin{bmatrix} PE_{pos+k,2i}\\ PE_{pos+k,2i+1} \end{bmatrix} = \begin{bmatrix} \cos(\omega_i k) & \sin(\omega_i k)\\ -\sin(\omega_i k) & \cos(\omega_i k) \end{bmatrix} \begin{bmatrix} PE_{pos,2i}\\ PE_{pos,2i+1} \end{bmatrix} \]
这个 \(2\times 2\) 矩阵只依赖 \(k\) 和 \(i\),与 \(pos\) 无关。把所有维度拼起来,就得到一个分块对角矩阵 \(M_k\),因此
\[ PE_{pos+k}=M_k\,PE_{pos} \]
意义:Transformer 的注意力计算大量使用线性投影。如果相对位置关系可以表示为线性变换,模型就更容易学会“关注相对位置 \(k\)”这种模式,而不需要学习复杂的非线性映射。
4. Why Self-Attention
本节对比自注意力层与循环/卷积层的异同。它们都用来将变长序列表示 \(\left( x_1,x_2,...,x_n\right)\) 映射到另一个序列 \(\left(x_1,x_2,...,x_n\right)\) ,其中 \(x_{i},z_{i} \in \mathbf{R}^{d}\) 。为了论证使用自注意力的动机,考虑三个理想目标:
- 每层的总计算复杂度。
- 可并行化的计算量,以所需的最小顺序操作数来衡量。
- 网络中长距离依赖之间的路径长度。学习长距离依赖是许多序列转换任务中的关键挑战。影响学习此类依赖能力的一个关键因素是前向和后向信号在网络中必须经过的路径长度。输入和输出序列中任意位置组合之间的这些路径越短,就越容易学习长距离依赖。因此,本文还比较了由不同层类型组成的网络中任意两个输入和输出位置之间的最大路径长度。
Table 1: Maximum path lengths, per-layer complexity and minimum number of sequential operations for different layer types. \(n\) is the sequence length, \(d\) is the representation dimension, \(k\) is the kernel size of convolutions and \(r\) is the size of the neighborhood in restricted self-attention.
| Layer Type | Complexity per Layer | Sequential Operations | Maximum Path Length |
|---|---|---|---|
| Self-Attention | \(O(n^2 \cdot d)\) | \(O(1)\) | \(O(1)\) |
| Recurrent | \(O(n \cdot d^2)\) | \(O(n)\) | \(O(n)\) |
| Convolutional | \(O(k \cdot n \cdot d^2)\) | \(O(1)\) | \(O(\log_k(n))\) |
| Self-Attention (restricted) | \(O(r \cdot n \cdot d)\) | \(O(1)\) | \(O(n/r)\) |
如上面表 1 所示,自注意力层以常数个顺序执行的操作连接所有位置,而循环层需要 \(O(n)\) 个顺序操作。在计算复杂度方面,当序列长度 \(n\) 小于表示维度 \(d\) 时,自注意力层比循环层更快,而机器翻译中最先进模型所使用的句子表示(如 word-piece 和 byte-pair 表示)通常就是这种情况。为了改善涉及非常长序列的任务的计算性能,可以将自注意力限制为仅考虑输入序列中以相应输出位置为中心、大小为 \(r\) 的邻域。这会将最大路径长度增加到 \(O(n/r)\)。
核宽度 \(k<n\) 的单个卷积层无法连接所有输入和输出位置对。要做到这一点,在连续核的情况下需要堆叠 \(O(n/k)\) 个卷积层,而在膨胀卷积的情况下需要 \(O(\log_k(n))\) 个卷积层,这增加了网络中任意两个位置之间最长路径的长度。卷积层通常比循环层更昂贵,高出 \(k\) 倍。然而,可分离卷积将复杂度显著降低到 \(O(k \cdot n \cdot d + n \cdot d^2)\)。然而,即使 \(k=n\),可分离卷积的复杂度也等于自注意力层和逐位置前馈层的组合,这正是 Transformer 模型中采用的方法。
作为附带好处,自注意力可以产生更具可解释性的模型。本文检查了模型中的注意力分布,并在附录中展示和讨论了示例。不仅各个注意力头明显学会了执行不同的任务,许多注意力头还表现出与句子句法和语义结构相关的行为。
5. Training
本节描述模型的训练方案。
5.1 Training Data and Batching
训练在标准 WMT 2014 英德数据集上进行,该数据集包含约 450 万个句子对。句子使用 byte-pair encoding 进行编码,其共享的源-目标词汇表约有 37000 个 token。对于英法翻译,使用了规模显著更大的 WMT 2014 英法数据集,包含 3600 万个句子,并将 token 切分为 32000 个 word-piece 词汇表。句子对按近似序列长度分批在一起。每个训练批次包含一组句子对,其中大约有 25000 个源 token 和 25000 个目标 token。
5.2 Hardware and Schedule
模型在配备 8 块 NVIDIA P100 GPU 的一台机器上训练。对于使用本文所述超参数的 base 模型,每个训练步大约耗时 0.4 秒。base 模型总共训练了 100,000 步,即 12 小时。对于 big 模型(见表 3 最后一行),每步时间为 1.0 秒。big 模型训练了 300,000 步(3.5 天)。
5.3 优化器
使用 Adam 优化器,参数为 \(\beta_1 = 0.9\)、\(\beta_2 = 0.98\)、\(\epsilon = 10^{-9}\)。在训练过程中,学习率按照以下公式变化:
\[ \text{lrate} = d_{\text{model}}^{-0.5} \cdot \min\left(\text{step\_num}^{-0.5},\ \text{step\_num} \cdot \text{warmup\_steps}^{-1.5}\right) \tag{3} \]
这对应于在前 \(\text{warmup\_steps}\) 个训练步中线性增加学习率,此后按步数的平方根倒数成比例降低学习率。其中设置 \(\text{warmup\_steps} = 4000\)。
5.4 Regularization
训练期间采用了三种正则化:
残差 Dropout: 对每个子层的输出应用 dropout,然后再将其加到子层输入上并进行归一化。此外,对 encoder 和 decoder 堆叠中 embeddings 与位置编码的和也应用 dropout。对于 base 模型,使用的丢弃率为 \(P_{\text{drop}} = 0.1\)。
标签平滑: 训练期间采用了值为 \(\epsilon_{ls} = 0.1\) 的标签平滑。这会损害困惑度,因为模型学会变得更加不确定,但会提高准确率和 BLEU 分数。
6. Results
6.1 Machine Translation
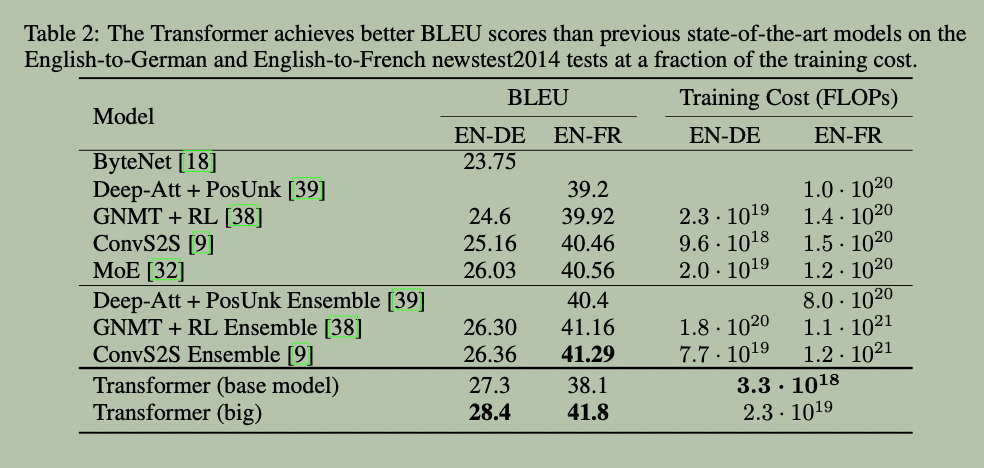
在 WMT 2014 英德翻译任务上,big transformer 模型(表 2 中的 Transformer (big))比此前报告的最佳模型(包括集成模型)高出 2.0 BLEU 以上,创造了新的最优 BLEU 分数 28.4。该模型的配置列于表 3 最后一行。在 8 块 P100 GPU 上训练耗时 3.5 天。即使是 base 模型,也超越了此前发表的所有模型和集成模型,而训练成本仅为任何竞争模型的一小部分。
在 WMT 2014 英法翻译任务上,big 模型达到了 41.0 的 BLEU 分数,超越了此前发表的所有单模型,而训练成本不到此前最优模型的 \(1/4\)。用于英法翻译的 Transformer (big) 模型使用的 dropout 率为 \(P_{\text{drop}} = 0.1\),而不是 0.3。
对于 base 模型,使用了对最后 5 个检查点取平均得到的单个模型,这些检查点每 10 分钟写入一次。对于 big 模型,对最后 20 个检查点取平均。使用了 beam size 为 4、长度惩罚 \(\alpha = 0.6\) 的 beam search。这些超参数是在开发集上实验后选定的。推理时将最大输出长度设为输入长度 + 50,但在可能时提前终止。
表 2 总结了结果,并将翻译质量和训练成本与文献中的其他模型架构进行了比较。训练一个模型所用的浮点运算次数,通过将训练时间、使用的 GPU 数量以及每块 GPU 持续单精度浮点容量的估计值相乘来估算。
6.2 Model Variations
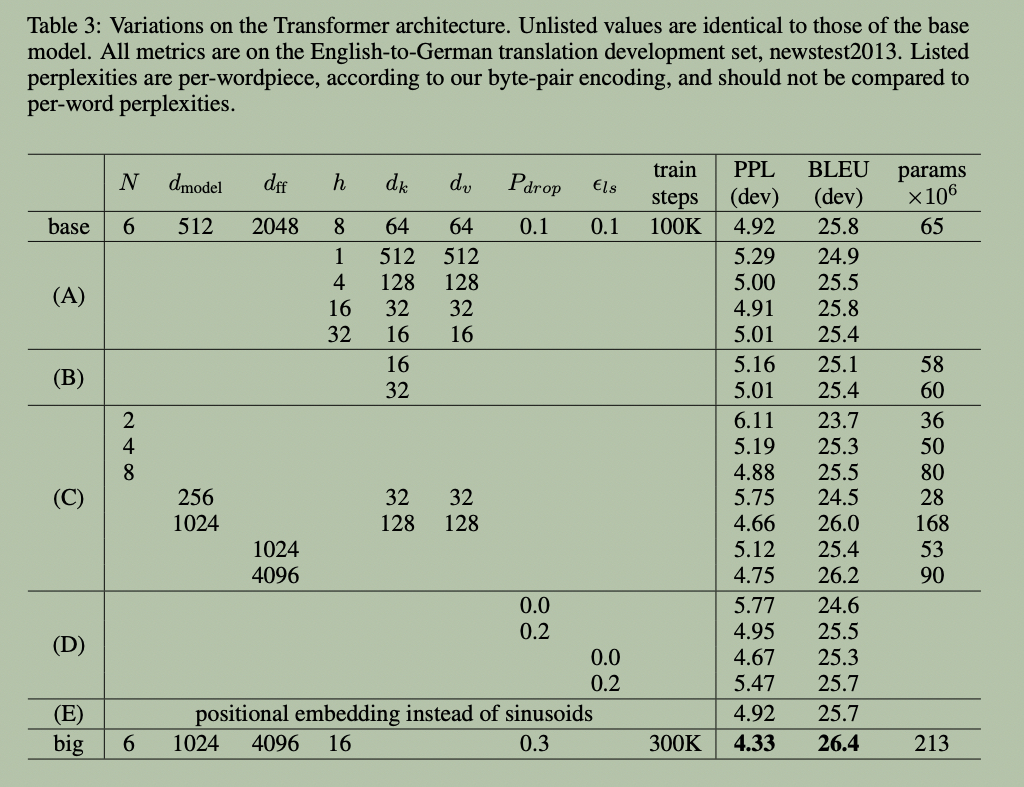
为了评估 Transformer 不同组件的重要性,以不同方式改变 base 模型,测量在开发集 newstest2013 上英德翻译性能的变化。使用上一节所述的 beam search,但不使用检查点平均。表 3 展示了这些结果。
在表 3 的 (A) 行中,改变注意力头数量以及注意力 key 和 value 的维度,同时保持计算量不变,如 3.2.2 节所述。单头注意力比最佳设置差 0.9 BLEU,而头数过多时质量也会下降。
在表 3 的 (B) 行中,观察到减小注意力 key 大小 \(d_k\) 会损害模型质量。这表明确定兼容性并不容易,比点积更复杂的兼容性函数可能是有益的。在 (C) 和 (D) 行中进一步观察到如预期的更大的模型更好,且 dropout 对避免过拟合非常有帮助。在 (E) 行中,用学习得到的位置 embeddings 替换正弦位置编码,并观察到与 base 模型几乎相同的结果。
6.3 English Constituency Parsing
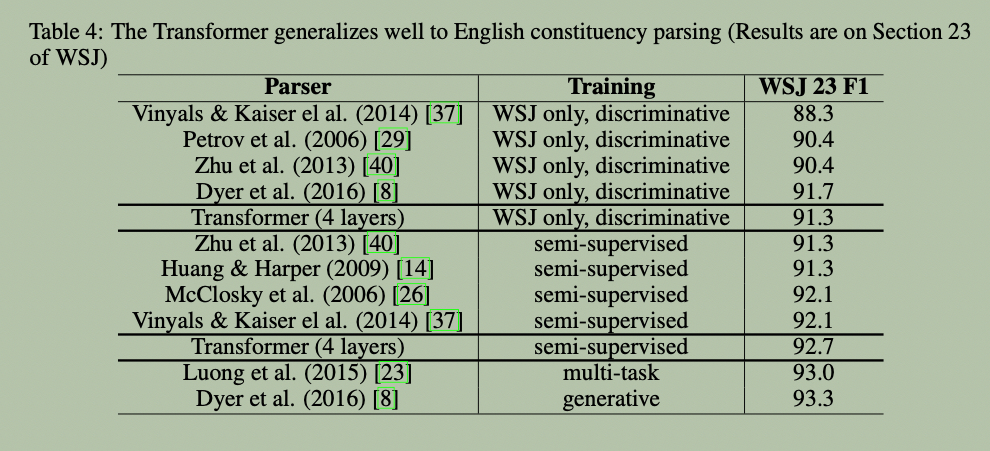
为了评估 Transformer 能否泛化到其他任务,本文在英语成分句法分析上进行了实验。该任务存在一些特定挑战:输出受到强结构约束,且明显长于输入。此外,RNN 序列到序列模型在小数据场景下一直未能取得最优结果。
本文在 Penn Treebank 的 Wall Street Journal(WSJ)部分上训练了一个 4 层 Transformer,\(d_{\text{model}} = 1024\),约 4 万条训练句子。本文还在半监督设置下训练该模型,使用更大的高置信度和 BerkleyParser 语料库,包含约 1700 万条句子。仅 WSJ 设置使用 16K token 的词汇表,半监督设置使用 32K token 的词汇表。
本文仅进行了少量实验,以在 Section 22 开发集上选择 dropout(包括注意力 dropout 和残差 dropout,见 5.4 节)、学习率和 beam size,所有其他参数均与英德 base 翻译模型保持不变。推理期间,将最大输出长度增加到输入长度 + 300。仅 WSJ 和半监督设置均使用 beam size 为 21、\(\alpha = 0.3\)。
表 4 中的结果表明,尽管没有进行任务特定的调参,Transformer 的表现仍出奇地好,除 Recurrent Neural Network Grammar 外,优于此前报告的所有模型。
与 RNN 序列到序列模型相比,即使仅在 4 万条句子的 WSJ 训练集上训练,Transformer 也优于 BerkeleyParser。
7. Conclusion
在这项工作中,我们提出了 Transformer,这是第一个完全基于注意力的序列转换模型,用多头自注意力取代了 encoder-decoder 架构中最常用的循环层。
对于翻译任务,Transformer 的训练速度显著快于基于循环层或卷积层的架构。在 WMT 2014 英德和 WMT 2014 英法翻译任务上,我们均达到了新的最优水平。在前一个任务上,我们最好的模型甚至超越了此前报告的所有集成模型。
我们对基于注意力的模型的未来感到兴奋,并计划将其应用于其他任务。我们计划将 Transformer 扩展到涉及文本以外的输入和输出模态的问题,并研究局部、受限的注意力机制,以高效处理图像、音频和视频等大型输入和输出。使生成过程更少依赖顺序是我们的另一个研究目标。
用于训练和评估模型的代码可在 https://github.com/tensorflow/tensor2tensor 获取。