PMPP Chapter 02: Heterogeneous data parallel computing
以 RGB 图片 -> 灰度图片转换为例,说明 Data Parallel 如何运行并行计算:
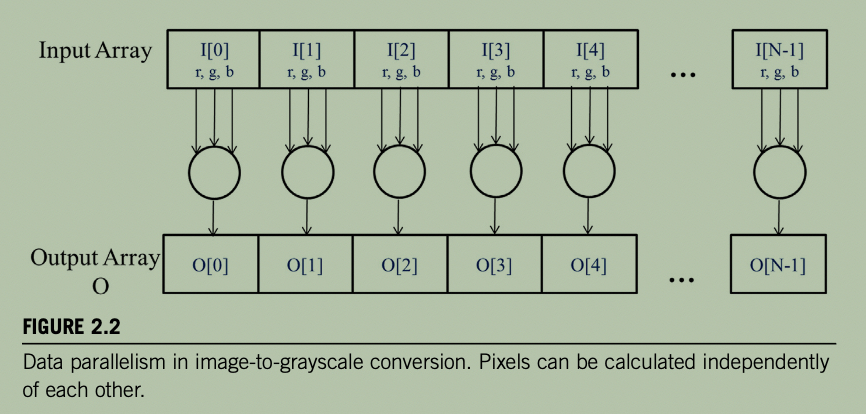
CUDA 编程步骤:
- 分配 device global memory
- 拷贝 host memory 内容到 device memory
- launch kernel 在 device 进行计算
- 从 device 拷贝计算结果到 host
- 释放 device 内存
注:
- 实际项目中,热点数据常驻 device memory,避免频繁 malloc/copy/free 影响性能。
- launch kernel 以及部份 CUDA API 是异步操作,实际项目中可以利用此特性进行 CPU 和 GPU 计算的 overlap,同时需要注意 host 侧操作依赖 device 侧计算完成时,要做好同步,确保 device 侧计算完成,host 侧读取到正确数据。
关于 memcpy/memset API 的同步/异步行为解释,见:
实际编程时,最佳实践是尽量使用 pinned memory + device memory +
显式指定 CUDA Stream(而不是依赖默认 stream),host 侧依赖 device
计算结果时,显式调用 cudaMemcpyAsync +
cudaStreamSynchronize 接口等待 device 侧计算/拷贝到 host
完成。示例代码:
1 | |
CUDA 线程层次
- many blocks -> grid
- many threads -> block
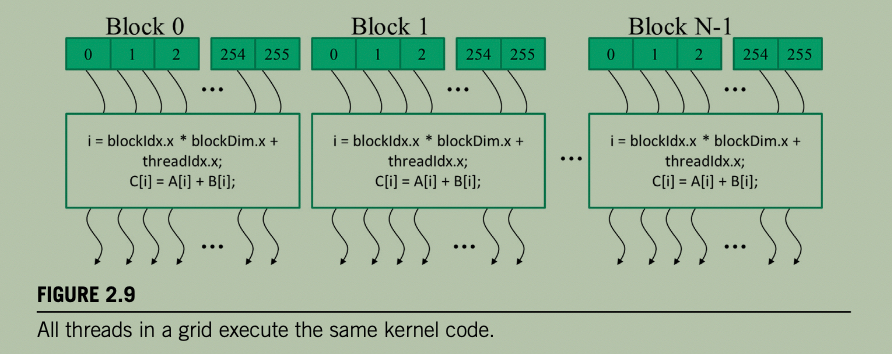
编译过程
- Use the CUDA keywords to separate the host code and device code.
- Compile host code with the host’s standard C/C++ compilers.
- The NVCC compiler compiles the device code into virtual binary files called PTX files. These PTX files are further compiled by a runtime component of NVCC into the real object files and executed on a CUDA-capable GPU device.
PMPP Chapter 02: Heterogeneous data parallel computing
https://arcsin2.cloud/posts/2026/09/2496157368/