PMPP Chapter 04: Compute architecture and scheduling
Architecture of a modern GPU
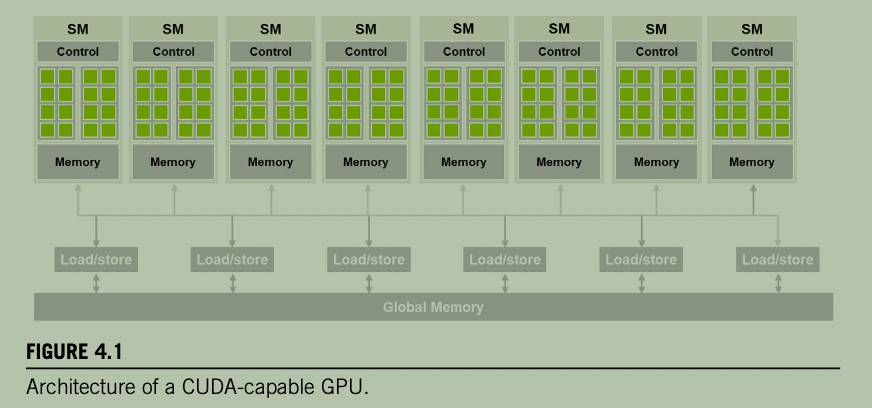
- GPU 计算单元由若干个 SM 组成(通常几十到一百多)
- 每个 SM 有若干个处理单元,称为 CUDA Cores(简称 cores)
- Memory(on-chip memory)
- Example:A100 GPU,108 SMs,每个 SM 64 个 cores
- global memory(off-chip memory)
- 较早的 GPU 或者非数据中心 GPU 采用 GDDR 内存
- 最近的数据中心 GPU 采用 HBM 内存
Block scheduling
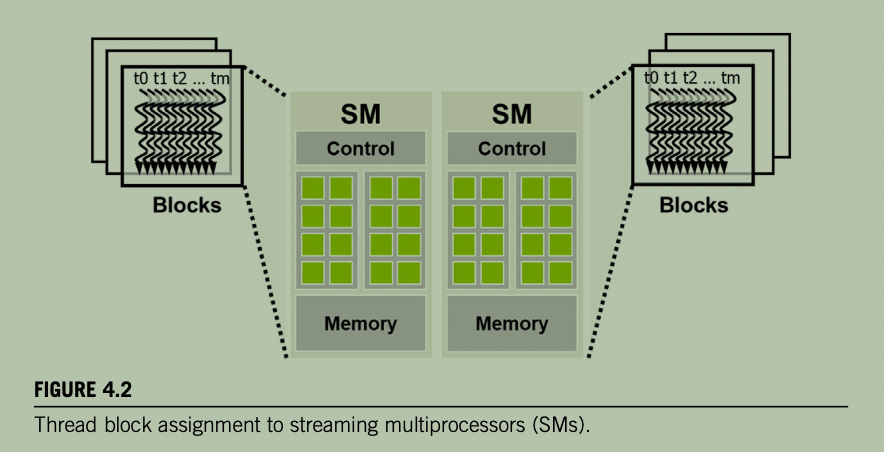
- 进行 kernel launch 时,CUDA runtime 以 block 为单位加载一个 block 到
SM 上执行,一个 block 内所有 threads 同时被分配到同一个 SM
上。为什么必须“同块同 SM”?:
- Block 内线程能够协作的根本前提。
- 使得 Block 内线程可以进行 Barrier
Synchronization(屏障同步,如
__syncthreads())。 - 使得 Block 内线程可以访问 SM 上低延迟的 Shared Memory(共享内存)。
- 跨 block 可以通过 Cooperative Groups API 同步。
- 多块驻留:一个 SM 可以同时驻留多个 Block(如图中显示一个 SM 同时处理 3 个 Block)。具体能驻留多少,取决于硬件资源限制(寄存器、共享内存、线程数等)。
- 调度与排队:由于 SM 数量和每个 SM 能容纳的 Block 数量都有限,设备能同时执行的 Block 总数是有上限的。如果 Grid 里的 Block 很多(通常都是如此),CUDA 运行时系统会维护一个待执行列表,当某个 Block 执行完毕后,再将新的 Block 动态分配给空出来的 SM。
Synchronization and transparent scalability
同一 block 内线程可以调用 __syncthreads() 实现 block
内线程同步(barrier)的目的。
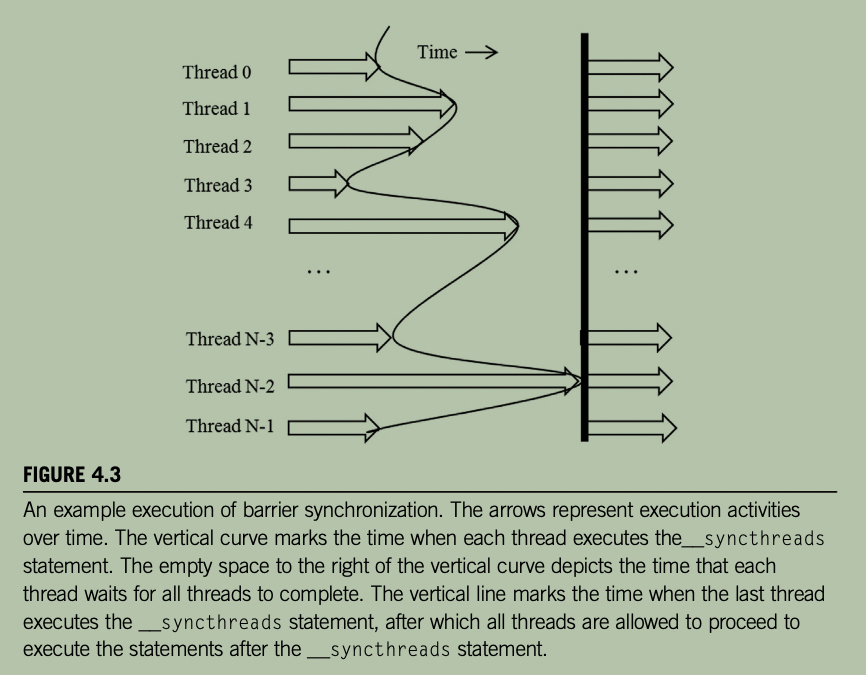
调用 __syncthreads() 时,必须保证 block
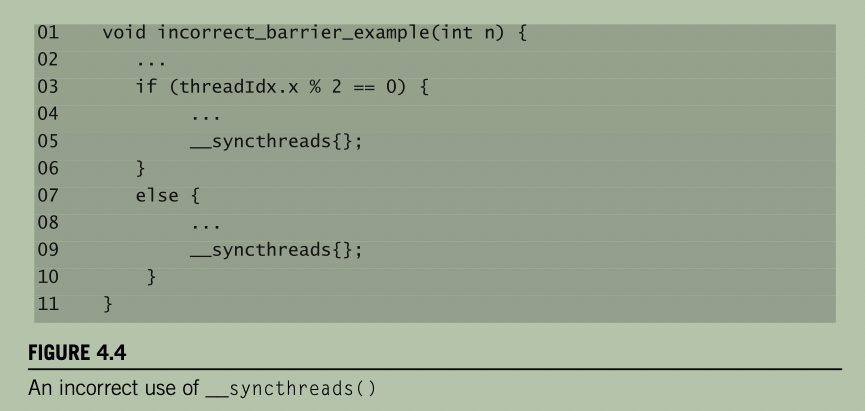
内所有线程都同时执行,不存在 if/early return
等情况。错误示例:
只要求一个 block 内线程同时在一个 SM 上执行,而不需要 block 间同步的特性,允许 CUDA 运行时对性能更好的 device(更多的 SM)实现透明扩展(transparent scalability)。
Warps and SIMD hardware
warp:32 个线程(threadIdx 连续的 32 个线程),是 SM 进行线程调度的单位。
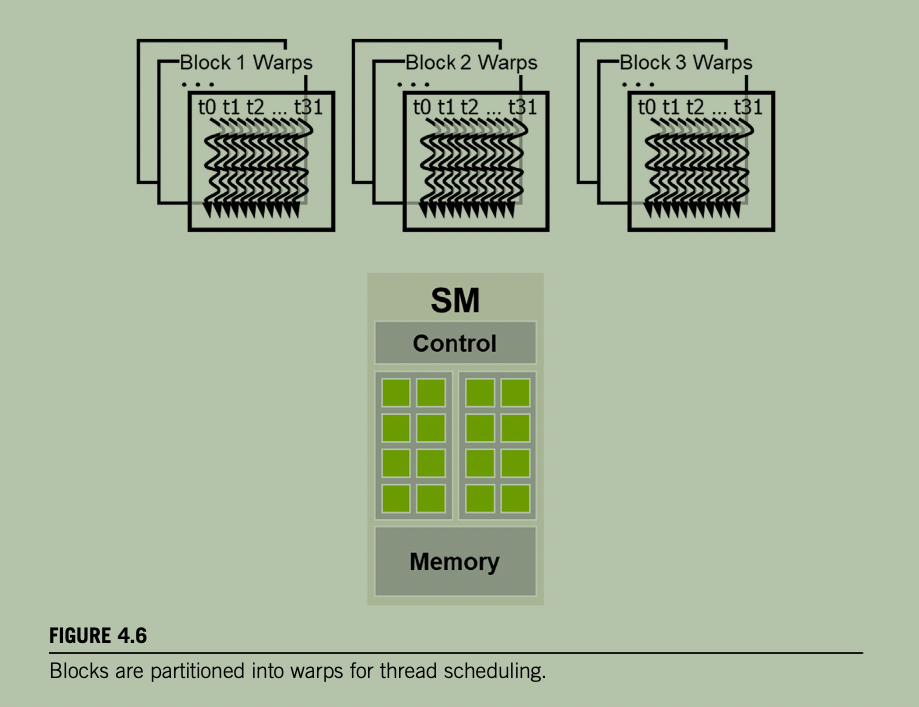
上图说明:
- 3 个 block 同时调度到一个 SM
- 每个 block 256 线程,即 256/32 = 8 个 warps
- SM 共有 3 * 8 = 24 warps
如果一个 block 的线程数不是 32 的倍数,SM 执行最后几个线程时会进行 padding:增加几个不活跃(inactive)线程凑成一个 warp 进行调度执行。
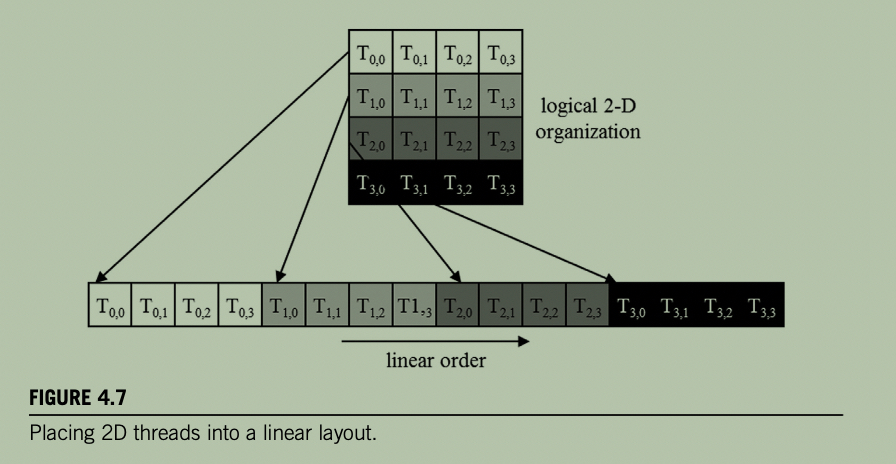
如果 blockDim(x, y, z) 是多维的,warp 划分规则如下:
- 首先将多维
threadIdx(x, y, z)展平(flatten),展平规则如下:- y, z 相同的情况下,先连续排列 x;z 相同的情况下,连续排列 y。
- 相当于将 x 作为连续(变化最快)的维度,将多维 threads 展平为一维行主序布局。
- flatten 后的连续 32 个线程构成一个 warp。
- 例子:注意,thread 坐标顺序为 (y, x)
SM 执行一个 warp 时,采用了 SIMD 模型。
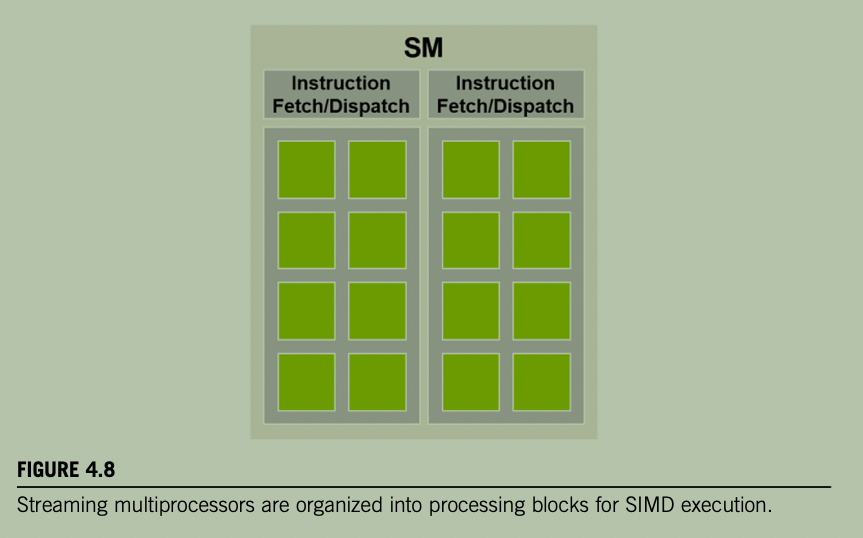
- SIMD 执行方式:
- 同一时刻,warp 内所有线程执行同一条指令,但作用于不同数据。
- 因此 warp 的执行行为常被称为 SIMT (Single Instruction, Multiple Thread)。
- SM 内部组织:
- SM 的 cores 被划分为多个 processing block。
- 每个 processing block 包含若干 core,并共享一个 instruction fetch/dispatch 单元。
- 例:Ampere A100 的 SM 有 64 个 core,分为 4 个 processing block,每块 16 个 core。
- 同一个 warp 的线程被分配到同一个 processing block。
- 设计优势:
- 控制硬件(取指/分发)由多个执行单元共享,降低控制开销。
- 更大比例的硬件可用于提升算术吞吐,而非控制逻辑。
- 这种 warp 划分方式预计在未来仍是主流实现技术。
- Warp 大小:
- 目前所有 CUDA 设备均为 32 线程/warp。
- 未来可能随实现变化。
Control divergence
如果一个 warp 内 thread 条件不同,不同 thread 需要执行 if-else 语句的不同控制流,硬件将需要分别对 if 执行路径和 else 执行路径进行两次执行(不满足条件的线程的指令不生效)。当同一个 warp 中的线程遵循不同的执行路径时,我们说这些线程表现出控制分歧/分支发散(control divergence)。控制分歧的代价在于:硬件需要额外的遍数来让 warp 中的不同线程做出各自的决策,以及每一遍中不活跃线程所消耗的执行资源。例子:
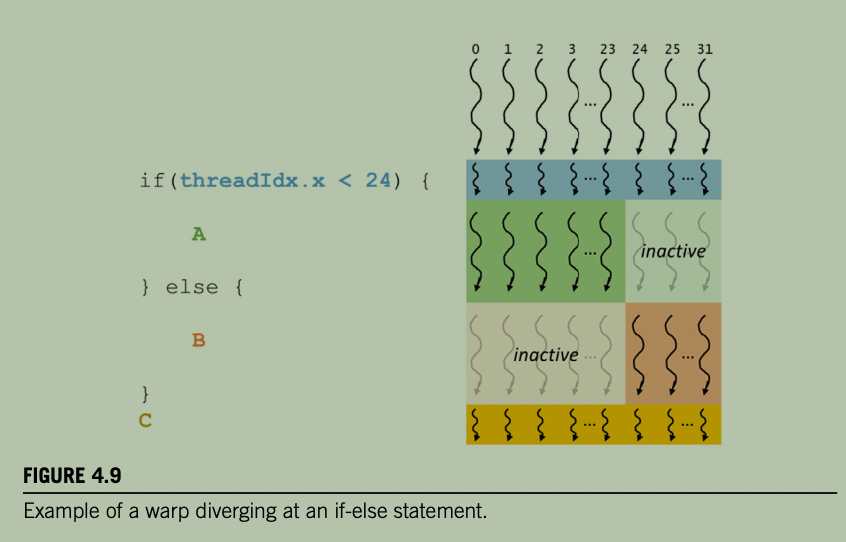
- 分支发散示例:
- Warp 到达 if-else:threads 0–23 走 then 路径(执行 A),threads 24–31 走 else 路径(执行 B)。
- 硬件执行两个 pass:
- Pass 1:threads 0–23 执行 A,threads 24–31 被 mask(inactive)。
- Pass 2:threads 24–31 执行 B,threads 0–23 被 mask。
- 之后所有线程 reconverge,一起执行 C。
- 架构差异:
- Pascal 及更早:两个 pass 顺序执行(一个 pass 完全执行完,再执行另一个)。
- Volta 及之后:两个 pass 可以并发/交错执行,称为 Independent Thread Scheduling(独立线程调度)。
- 嵌套 if 与分支发散的成本:
- 单个 warp 最多 32 个线程 → 最多 32 条不同执行路径。
- 嵌套 if 理论上产生 2^n 条路径,但实际受限于 32 线程,最多 32 条。
- 硬件串行执行不同路径,总指令发射数 ≈ Σ(各路径指令数)。
- 最坏情况:32 个线程走 32 条不同路径,执行时间约为单路径的 32 倍。
- 不会出现排列/组合爆炸式的乘法级增长。
- 循环发散:总时间 ≈ 最大循环次数 × 循环体指令数。
- 整体 kernel 中,多个 warp 独立调度,总吞吐受 SM 资源限制,但单个 warp 内不会指数爆炸。
for 循环控制分歧例子:
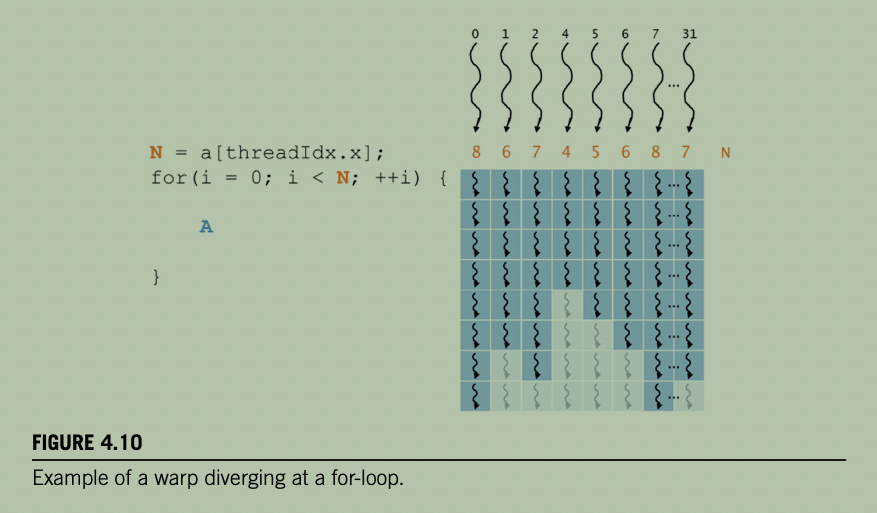
- 不同线程的循环次数不同(4 到 8),导致控制分歧
Summary:
- 在根据 threadIdx 和输入数据 shape 进行边界条件检查时,可能引入控制分歧(launch 的 threads 可能比处理数据需要的多,屏蔽部分 threads 避免越界访问)。
- 只有一个 warp 内线程执行路径不同时,才有控制分歧,前面的若干个处理 full tile 的 warps 不存在控制分歧。
- 这种边界判断引入的控制发散对性能的影响随着处理数据规模的增大而减小。
- 控制发散的一个重要含义是:不能假定一个 warp
中的所有线程具有相同的执行时序。因此,如果必须让一个 warp
中的所有线程都完成其执行的某个阶段之后,其中任何一个线程才能继续推进,那么就必须使用屏障同步机制(例如
__syncwarp())来确保正确性。
Warp scheduling and latency tolerance
- 核心问题:SM
中驻留的线程数远多于其执行单元(cores)能同时执行的线程数。为什么需要这么多线程?
- 答案:为了容忍长延迟操作(如全局内存访问),即延迟隐藏(latency hiding)。
- Warp 调度机制:
- 每个时刻 SM 只能执行所有驻留 warp 的一个子集(早期一次执行 1 个 warp,现代可同时执行少量 warp)。
- 当一个 warp 需要等待长延迟操作的结果时,它不会被选中执行。
- 调度器转而选择一个已就绪(不再等待)的 warp 来执行。
- 若有多个就绪 warp,则按优先级机制选择一个。
- 通过执行其他 warp 的工作来填补等待时间,称为延迟容忍 / 延迟隐藏。
- 零开销线程调度 (Zero-overhead Scheduling):
- GPU 将所有驻留 warp 的执行状态(PC、寄存器等)保存在硬件寄存器中,无需像 CPU 那样在切换时保存/恢复状态到内存。
- 因此 warp 之间的切换不引入额外空闲周期。
- 对比:CPU 上下文切换需要保存/恢复寄存器,开销显著。
- GPU 如何实现“零开销”?
- 所有驻留 warp 的执行状态都常驻在硬件寄存器中。
- 每个 warp 有自己的 PC、寄存器组、状态信息。
- 这些状态从 warp 被分配到 SM 开始,直到执行结束,一直留在 SM 的寄存器文件里。
- 切换 warp 时,不需要保存/恢复任何状态。
- 调度器只需改变“当前选择哪个 warp”的指针。
- 被换出的 warp 的寄存器内容原封不动地留在寄存器文件中,下次被选中时直接继续执行。
- 被换入的 warp 的状态也已经在寄存器中,无需从内存加载。
- 结果:warp 切换在硬件层面几乎是瞬时的,不引入额外空闲周期。
- 可以理解为:用海量的存储资源(寄存器、共享内存)来换取控制逻辑的精简,并通过超量线程(TLP)来隐藏延迟。
- 所有驻留 warp 的执行状态都常驻在硬件寄存器中。
- 与 CPU 的差异:
- GPU 不依赖大容量缓存和分支预测来隐藏延迟,而是依靠大量驻留 warp。
- 因此 GPU 可将更多芯片面积用于浮点执行单元和内存访问通道。
- 延迟容忍的有效性条件:
- SM 需要超量订阅(oversubscription) 线程:驻留线程数远大于执行单元数。
- 例如 Ampere A100:SM 有 64 个 core,但可同时驻留 2048 个线程(约 32 倍)。
- 这样当某个 warp 遇到长延迟操作时,更有可能找到其他就绪 warp 来执行。
- Sidebar 类比:邮局
- 顾客 = warp,柜员 = 执行单元。
- 需要填表的顾客 = 等待长延迟操作的 warp。
- 好柜员会让填表顾客先到旁边填,同时服务其他已就绪的顾客,避免阻塞。
- 即:不要让整个执行单元空等,而是切换到其他就绪 warp。
- 补充:
- Warp 调度也用于容忍其他延迟,如流水线浮点运算、分支指令等。
- 只要驻留 warp 足够多,硬件总能在某一时刻找到可执行的 warp,充分利用执行硬件。
- GPU 架构哲学:用存储换控制,用 TLP 隐藏延迟
- 存储资源:巨大的寄存器文件(A100: 256KB/SM),保存所有驻留 warp 的执行状态。
- 控制逻辑:精简调度器,无分支预测、无乱序执行,节省芯片面积和功耗。
- 延迟处理:靠超量驻留 warp(如 2048 threads/SM)和零开销切换来隐藏延迟。
- 代价:单线程性能弱、对分支发散敏感、寄存器压力限制驻留 warp 数。
- 结果:GPU 将更多面积用于 ALU 和访存通道,适合高吞吐数据并行任务。
Resource partitioning and occupancy
1. 占用率(occupancy)定义
- Occupancy(占用率) = 实际分配给 SM 的 warp 数 / SM 支持的最大 warp 数 或等价地:实际线程数 / SM 最大线程数。
- 目标:尽可能提高占用率,以更好地容忍长延迟操作。
2. SM 的执行资源
- 寄存器 (Registers)
- 共享内存 (Shared Memory)
- 线程块槽位 (Block Slots)
- 线程槽位 (Thread Slots)
- 这些资源由 SM 动态划分给各线程块使用。
3. 动态划分 vs. 固定划分
- 动态划分:按需分配,灵活支持“多块少线程”或“少块多线程”。
- 固定划分:每个块获得固定资源,容易浪费或不足。
- 动态划分可能导致资源限制之间的复杂交互,造成资源利用率不足。
4. 限制占用率的典型因素
① 线程块槽位限制
- 例:Ampere A100 SM 支持最多 32 个 block、64 个 warp(2048 线程)。
- 若 block size = 32,则需 64 个 block 才能填满 2048 线程,但最多只有 32 个 block → 仅 1024 线程 → 占用率 50%。
- 结论:要满占用,每个 block 至少需要 64 个线程。
② 最大线程数不能被 block size 整除
- 例:A100 最大 2048 线程/SM,若 block size = 768,则最多 2 个 block(1536 线程),剩余 512 槽位空闲 → 占用率 75%。
③ 寄存器限制
例:A100 每个 SM 最多 65,536 个寄存器。
要满占用(2048 线程),每线程最多使用: \[ \frac{65536}{2048} = 32 \text{ registers/thread} \]
若每线程用 64 个寄存器,则最多支持: \[ \frac{65536}{64} = 1024 \text{ threads} \]
占用率最多 50%。
若每线程用 33 个寄存器,2048 线程需: \[ 2048 \times 33 = 67584 > 65536 \]
运行时只能分配 3 个 block(如 512 线程/block),即 1536 线程 → 占用率从 100% 降到 75%。
性能悬崖 (Performance Cliff):资源使用微增(如多两个自动变量),导致并行度和性能显著下降。
编译器可能进行 寄存器溢出 (register spilling) 以降低每线程寄存器需求,但会增加访存和执行时间,可能得不偿失。
5. 关键结论
- 所有动态划分资源相互制约,精确确定每个 SM 能运行的线程数很复杂。
- 提高占用率不一定总是最优:有时低占用率但每个线程做更多工作(如更多寄存器)反而更快。
6. 速记公式
占用率: \[ \text{Occupancy} = \frac{\text{Assigned threads per SM}}{\text{Max threads per SM}} \]
满占用时每线程寄存器上限: \[ \text{Regs/thread} \le \frac{\text{Total regs per SM}}{\text{Max threads per SM}} \]
每 SM 可驻留 block 数: \[ \min\left(\text{Block slots limit},\ \left\lfloor\frac{\text{Max threads}}{\text{Block size}}\right\rfloor,\ \left\lfloor\frac{\text{Total regs}}{\text{Block size} \times \text{Regs/thread}}\right\rfloor,\ \dots\right) \]
shared memory 对占用率影响将在后续章节讨论
Querying device properties
实际编程时,需要查询 GPU 设备的属性(设备 SM 数量、SM 可以执行的 block 数和 thread 数等),以更好的利用高性能 GPU 以及对普通 GPU 保持兼容性。
SM 数量通常与计算能力直接关联:
- 计算能力 (Compute Capability):
- 每个 CUDA 设备 SM 中的资源数量由设备的 计算能力 (compute capability) 指定。
- 一般来说,计算能力等级越高,每个 SM 中可用的资源越多。
- GPU 的计算能力逐代增加。
- 例如:Ampere A100 的计算能力为 8.0。
查询 CUDA device 数量 API
1 | |
查询指定 id 的 CUDA device 属性
1 | |
- 更多信息见官方文档:Device Management
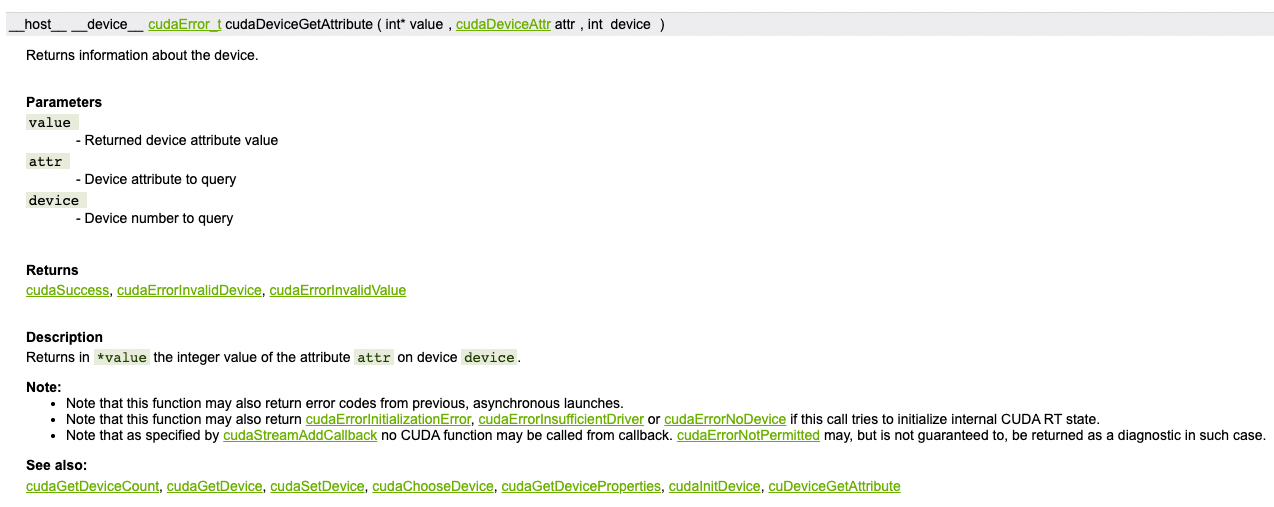
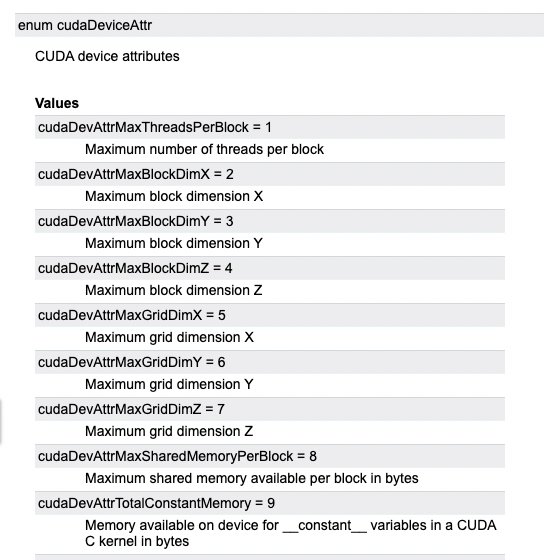
- 最近的新版 CUDA API 使用
cudaDeviceGetAttribute( int* value, cudaDeviceAttr attr, int device )API 进行属性查询,相关链接
Summary
- SM 组织:
- GPU 由多个 SM 组成,每个 SM 包含多个 processing block,共享控制逻辑和内存资源。
- Grid 启动后,block 以任意顺序分配给 SM,实现 CUDA 应用的透明可扩展性。
- 限制:不同 block 的线程之间不能同步。
- 线程分配与执行:
- 线程以 block 为单位分配到 SM;block 进一步划分为 warp。
- Warp 内线程按 SIMD 模型执行。
- 若 warp 内发生分支发散,不同路径分 pass 串行执行,线程仅在其对应路径的 pass 中活跃。
- 延迟容忍与占用率:
- SM 可驻留的线程数远多于其能同时执行的线程数。
- SM 只执行驻留 warp 的一个子集,其余 warp 等待长延迟操作,从而隐藏延迟、维持吞吐。
- Occupancy(占用率) = 分配给 SM 的线程数 / SM 支持的最大线程数。
- 占用率越高,越能隐藏长延迟操作。
- 资源限制:
- 每个 CUDA 设备的 SM 资源限制可能不同:block 数、线程数、寄存器数、共享内存等。
- 每个 kernel 可能受一种或多种资源限制,成为占用率的瓶颈。
- CUDA C 提供运行时查询 GPU 资源的能力(如
cudaGetDeviceProperties)。