PMPP Chapter 05: Memory architecture and data locality
本章主要关注 GPU 的 on-chip memory,重点是利用 shared memory 减少 global memory 访问,提升 kernel 性能。
Importance of memory access efficiency
Compute to Global Memory Access Ratio(算术强度 / 计算强度)
定义:
指程序某区域内,每访问 1 字节全局内存所执行的浮点运算次数(FLOPs)。
公式: \[ \text{Compute to Global Memory Access Ratio} = \frac{\text{FLOPs}}{\text{Bytes accessed from global memory}} \]
文献中也称为 arithmetic intensity 或 computational intensity。
例子:最简单的矩阵乘法 kernel(第三章)
主要执行部分:沿 k 维度做向量点积。
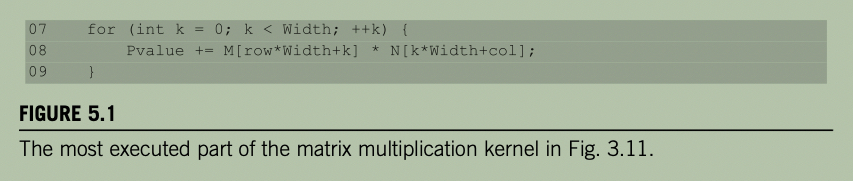
每次循环(内层 k 迭代):
访存:读取矩阵 M 和 N 各一个 float 元素 → 4 + 4 = 8 字节。
计算:一次浮点乘法 + 一次浮点加法 → 2 FLOP。
比率: \[ \frac{2 \text{ FLOP}}{8 \text{ B}} = 0.25 \text{ FLOP/B} \]
这一比例即为该 kernel 的 compute to global memory access ratio。
对于 A100 GPU,为了充分利用其计算能力,计算强度需要达到至少:19,500 GOP/second)/(1555 GB/second)=12.5 OP/B。
意义:
- 比率低 → 每次计算需要搬运大量数据 → 容易成为 memory-bound(内存带宽瓶颈)。
- 比率高 → 计算密集,可能成为 compute-bound。
- 优化方向:通过 tiling / shared memory 提高数据复用,减少全局内存访问,从而提高算术强度。
The Roofline Model
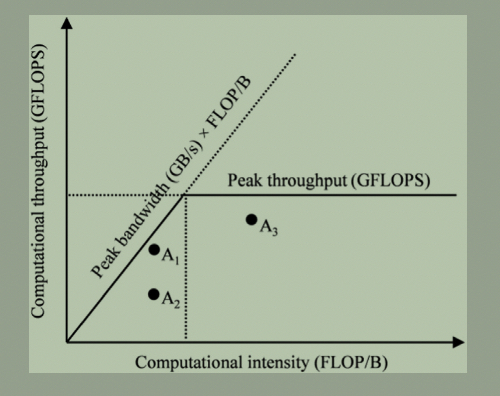
- 定义:一种可视化模型,用于评估应用性能相对于硬件极限的位置。
- 坐标轴:
- x 轴:算术强度 / 计算强度(Arithmetic / Computational Intensity),单位 FLOP/B。表示每加载 1 字节数据所完成的计算量。
- y 轴:计算吞吐量(Computational Throughput),单位 GFLOPS。
- 硬件极限线:
- 水平线:由硬件的峰值计算吞吐量(GFLOPS)决定。
- 从原点出发的正斜率线:由硬件的峰值内存带宽决定。
- 所有实际应用的性能点都位于这两条线下方(不可能超过硬件峰值)。
- 点的含义:
- 每个点代表一个应用:x 坐标是它的计算强度,y 坐标是它实际达到的吞吐量。
- 点越靠近两条线,说明资源利用越高效;点远低于线,说明资源利用低效。
- 交点(脊点):
- 两条线的交点对应的计算强度,是应用从 memory-bound 转向 compute-bound 的临界值。
- 交点强度 = 峰值计算吞吐 / 峰值内存带宽。
- 区域划分:
- 低计算强度 → memory-bound:受内存带宽限制,无法达到峰值计算吞吐。
- 高计算强度 → compute-bound:受计算单元限制,不受内存带宽限制。
- 示例(图中点):
- A1、A2:memory-bound 应用。
- A1:高效,接近峰值内存带宽。要提升吞吐,只能提高计算强度。
- A2:低效,离峰值内存带宽较远。可通过优化内存访问效率来提升吞吐。
- A3:compute-bound 应用,接近峰值计算吞吐。
- A1、A2:memory-bound 应用。
- 优化启示:
- memory-bound 应用:优化内存访问(合并、缓存、tiling)或提高计算强度。
- compute-bound 应用:优化计算单元利用率(指令级并行、减少分支发散等)。
CUDA memory types
CUDA device 内存模型:
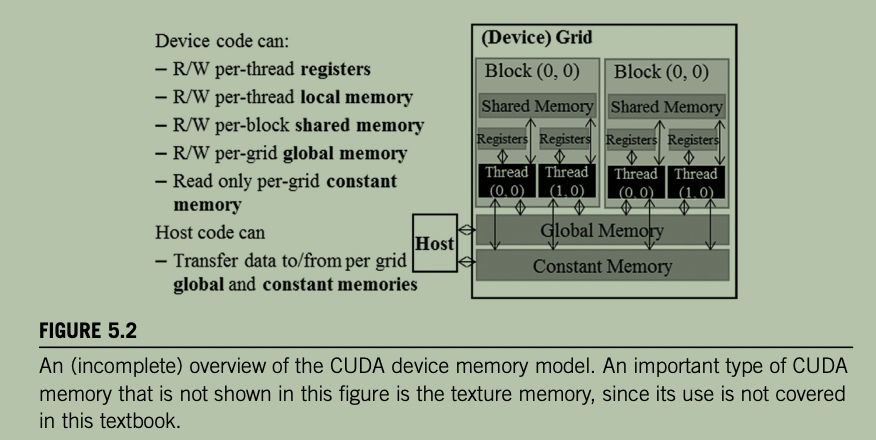
- global memory:host 可读可写;device 可读可写。
- constant memory:host 可读可写;device 可读不可写。
- local memory:实际上位于 global memory,但是 thread
间不共享,每个 thread 有自己私有的 global memory 一段作为 local
memory。通常在寄存器不够用的时候才会触发 local memory 分配与访问。
- This data includes statically allocated arrays, spilled registers, and other *elements of the thread’s call stack*.
- on-chip memory:可被快速访问。
- shared memory:分配给 block,同一 block 内所有线程都可以访问。
- registers:每线程私有。
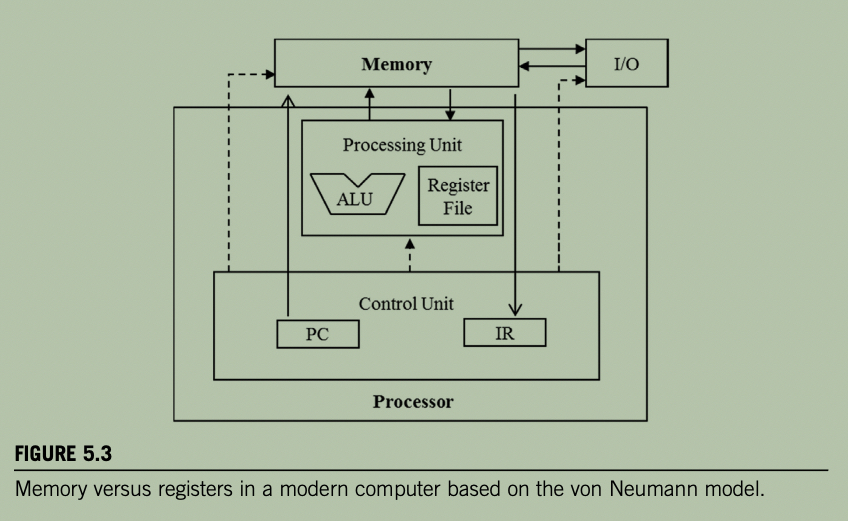
- 该图展示了 global memory 相当于上图的 Memory,在 Processor 外,所以也叫 off-chip memory。
- Register File 以及 shared memory 在 Processor 内,所以叫 on-chip memory。
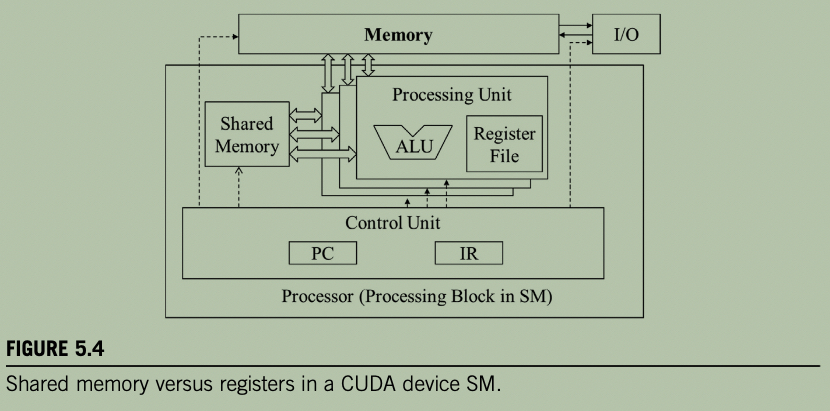
- shared memory 虽然也是 on-chip memory,但是其读取带宽/时延都远大于 register,同时与 shared memory 类似,也需要 Load 指令从 shared memory 读取。
- shared memory 可被 block 内所有线程访问,register 是线程私有的。
如何声明上述不同类型 memory 上的变量
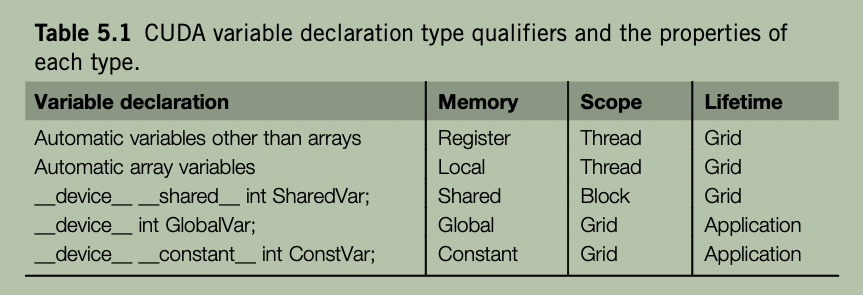
- 注意:自动数组变量默认分配在 Local
Memory,而不是寄存器。
- 原因:寄存器不支持运行期动态索引(如
arr[i]),数组通常需要动态寻址。 - 例外:仅当数组极小且所有索引在编译期展开为常量时,编译器可能通过“标量替换”将其放入寄存器。
- Local Memory 物理上位于全局内存,受 L1/L2 缓存,延迟高于寄存器。
- 原因:寄存器不支持运行期动态索引(如
- CUTLASS Fragment:寄存器支持的数组
- CUTLASS 中的 Fragment 是一个由寄存器支持的数组,用于存储每个线程持有的 tile 部分。
- 实现原理:
- 编译期确定大小:Fragment 的模板参数(元素类型、元素数量)都是编译期常量。
- 强制静态索引访问:通过 CuTe Layout
和模板元编程,确保所有访问索引都是
constexpr或在完全展开的循环中。 - 编译器标量替换:满足条件后,编译器将数组的每个元素视为独立标量,分配到寄存器中。
- 与普通自动数组的对比:
- 普通数组:索引为运行时变量 → 无法用寄存器寻址 → 放入 Local Memory。
- Fragment:索引在编译期解析为常量 → 可被标量替换 → 放入寄存器。
- 结论:Fragment 并非魔法,而是通过严格的编译期约束,引导编译器做出最优的寄存器分配决策。
- Global Variables 与跨块协作
- Global variables 可用于跨 block 的线程协作。
- 限制:目前没有简单方法在不同 block 的线程之间同步,或保证访问 global
memory 时的数据一致性,除非:
- 使用 原子操作 (atomic operations),或
- 终止当前 kernel 执行(例如通过 kernel 拆分)。
- 因此,global variables 常用于从一个 kernel 调用向另一个 kernel 调用传递信息。
- 内存栅栏 (memory fencing) 的补充条件:
- 若 block 数 < SM 数,可使用 CUDA 内存栅栏(如
__threadfence())来确保 block 间的数据一致性。 - 原因:此时所有 block 可同时驻留,不会因 block 排队导致死锁。
- 但内存栅栏只保证写入的可见顺序,不提供同步/等待语义,仍需配合原子操作或标志位。
- 该技术可移植性差,更推荐使用 Cooperative Groups 的
grid.sync()或拆分多个 kernel 启动来实现跨块同步。 - 详见 CUDA Programming Guide。
- 若 block 数 < SM 数,可使用 CUDA 内存栅栏(如
Tiling for reduced memory traffic
Motivation
- 固有权衡:
- Global memory:大但慢。
- Shared memory:小但快。
- 分块策略 (Tiling):
- 将数据划分为子集,称为 tiles,使每个 tile 能放入 shared memory。
- 类比:一堵大墙(global memory 数据)由小瓷砖(可分别放入 shared memory 的子集)覆盖。
- 关键条件:
- 各 tile 上的 kernel 计算必须相互独立。(对于任意 kernel 函数,并非所有数据结构都能划分成 tiles。)
第三章的简单矩阵乘法实现说明:
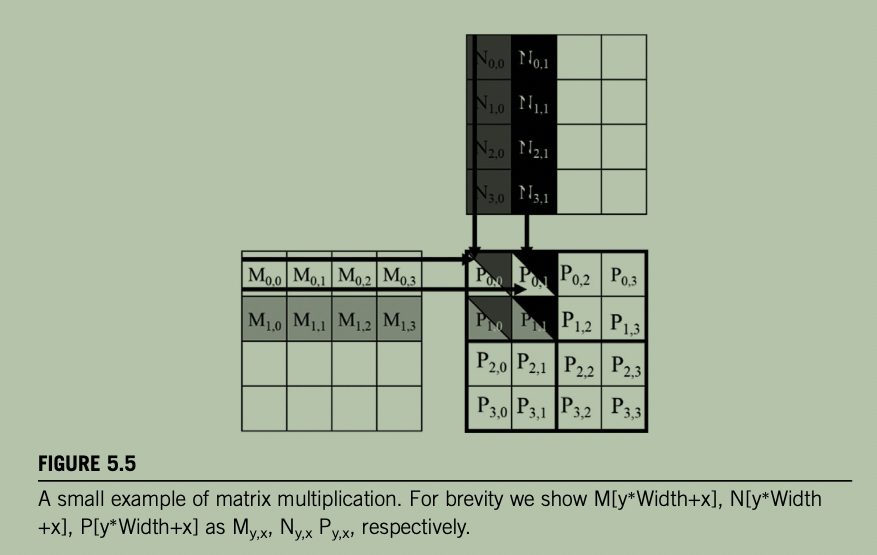
- 4 个 block,每个 block 负责一个 \(2 \times 2\) tile 的计算(每个线程负责 tile 中一个元素)
- \(\text{block}_{0,0}\) 的 4
个线程为了计算 P 矩阵的 4 个元素,分别需要访问矩阵 M/N 的元素:
- \(\text{thread}_{0,0}\) 为了计算得到 \(P_{0,0}\) 需要访问矩阵 M 的第 0 行全部 4 个元素;以及矩阵 N 的第 0 列全部 4 个元素
- \(\text{thread}_{0,1}\) 为了计算得到 \(P_{0,1}\) 需要访问矩阵 M 的第 0 行全部 4 个元素;以及矩阵 N 的第 1 列全部 4 个元素
- 类似的,\(\text{block}_{0,0}\) 的四个线程访问 global memory 顺序如下图所示:
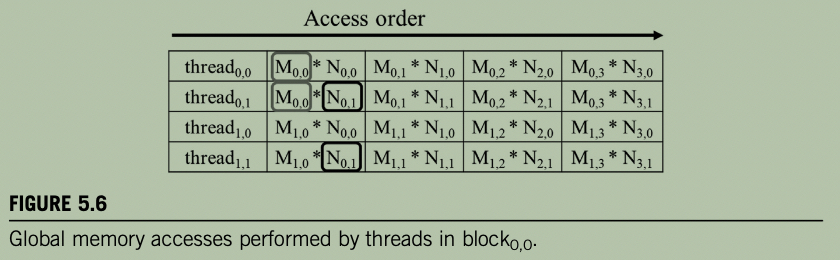
- 可以看到,每个线程需要访问矩阵 M/N 的个 4 个元素,总访存量:\(4 *2* 4 = 32\) 次 global memory 内存访问。
- 但是,\(\text{block}_{0,0}\) 为了计算得到矩阵 P 对应 tile 的输出结果,理论上只需要访问矩阵 M/N 的共:\(2 *4* 2 = 16\) 个元素。目前实现,矩阵 M/N 中元素实际上都被访问了两次。
- 如果能让 block 内的 4 个线程协作加载,使得每个元素只从 global memory 加载一次,就可以将 global memory 访问量减少一半(从 32 次降到 16 次)。
- 这正是 tiling 减少内存流量的核心思想:通过线程间协作(如 shared memory),消除同一 block 内对 global memory 的冗余访问。
- 一般化结论:
- 在矩阵乘法中,通过 tiling 实现的 global memory 流量减少量与 block 的宽度成正比。
- 对于 \(Width \times Width\) 的 block,每个元素被重复访问的次数为 \(Width\),因此理论上可将 global memory 流量减少到原来的 \(\frac{1}{Width}\)。
- 例:
- \(2 \times 2 block\) → 每个元素访问 2 次 → 流量减半(1/2)。
- \(16 \times 16\) block → 流量可降至原来的 1/16。
Tiled matrix multiplication algorithm & analysis
核心思想:
- 线程协作将 M 和 N 的子集(tiles)加载到 shared memory 中,然后再各自用这些元素做点积计算。
- 共享内存容量很小,加载时必须注意不能超过其容量。
- 解决办法:将 M 和 N 划分成更小的 tiles,tile 的尺寸选择为能放入 shared memory。
- 最简单形式:tile 的维度等于 block 的维度(如下图所示)。
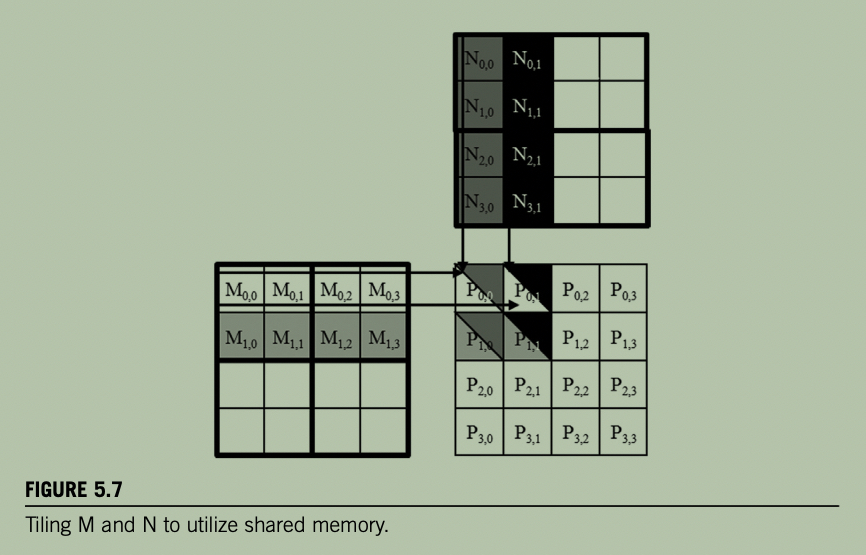
- 矩阵 M/N tile 之后,kernel 内点积计算过程需要分为多个阶段循环进行:
- 在每个阶段,线程协作将 M/N 一个元素从 global memory 读到 shared memory,如下图所示:
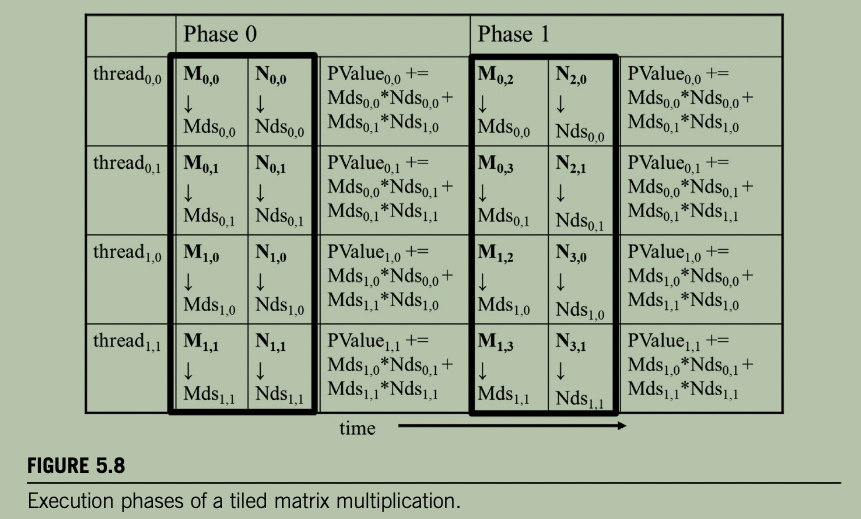
- 阶段 1(以 \(\text{block}_{0,0}\) 为例):
- 阶段 2:
- 四个线程协作加载 M 的一个 \(2 \times
2\) tile 到
Mds:- \(\text{thread}_{0,0}\) 加载 \(M_{0,0} \to \text{Mds}_{0,0}\)
- \(\text{thread}_{0,1}\) 加载 \(M_{0,1} \to \text{Mds}_{0,1}\)
- \(\text{thread}_{1,0}\) 加载 \(M_{1,0} \to \text{Mds}_{1,0}\)
- \(\text{thread}_{1,1}\) 加载 \(M_{1,1} \to \text{Mds}_{1,1}\)
- 类似地,四个线程协作加载 N 的一个 \(2
\times 2\) tile 到
Nds。 - 加载完成后,调用
__syncthreads()确保所有线程都完成写入。 - 每个线程用
Mds和Nds中的元素计算部分点积,累加到局部变量。
- 四个线程协作加载 M 的一个 \(2 \times
2\) tile 到
- 重复直到覆盖整个 k 维度(本例中 k=4,tile 宽度=2,共 2 个阶段)。
- 最后将累加结果写回
P[row][col]。
整体流程(每个 block 负责一个输出 tile):
- 将 M 和 N 划分成与 block 同尺寸的 tile。
- 每个线程协作把 M 和 N 的当前 tile 从 global memory 加载到 shared memory。
__syncthreads()确保所有线程完成加载。- 每个线程用 shared memory 中的 tile 计算部分点积。
- 重复加载下一个 tile(沿 k 维度),累加结果。
- 最后将结果写回 P。
关键优势:
- 每个 M/N 元素从 global memory 只加载一次(而不是每个线程各加载一次)。
- 全局内存访问量降低为原来的 \(1/Width\)(\(Width\) 为 block 宽度)。
- 用 shared memory 的高带宽替代 global memory 的低带宽,显著提升性能。
注意点:
- 必须使用
__syncthreads()保证加载完成后再计算,计算完成后再加载下一个 tile(避免读写冲突)。 - shared memory 大小有限,tile 尺寸不能超过硬件限制。
- 边界情况:矩阵维度不是 tile 尺寸整数倍时,需要边界检查。
A tiled matrix multiplication kernel
1 | |
上述 kernel 执行示意图:
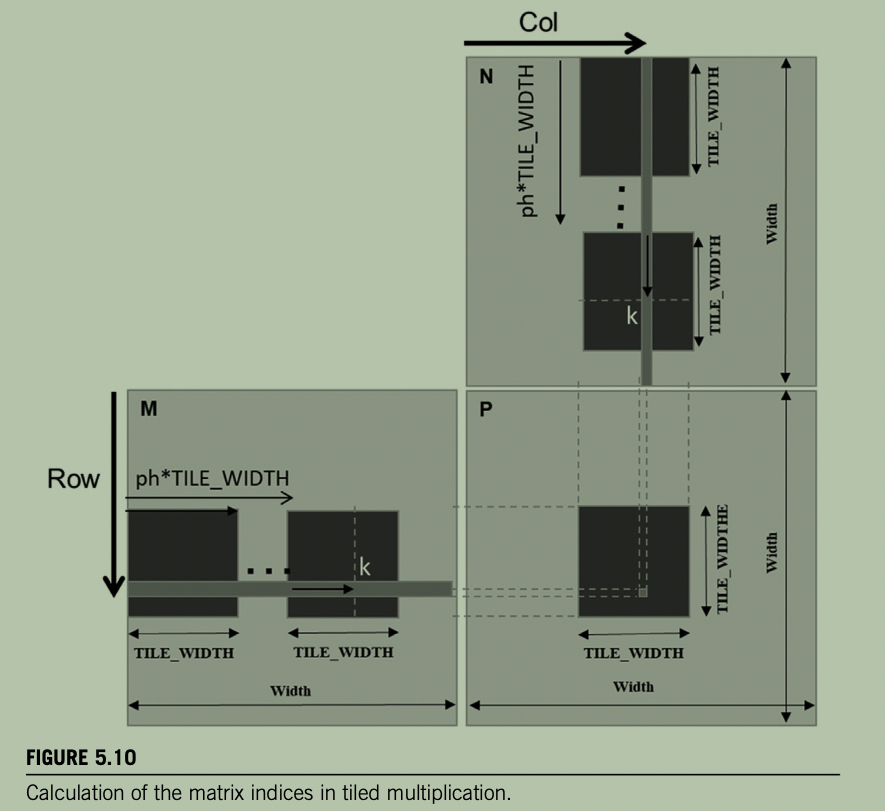
kernel 详细解释
共享内存声明(第 04–05 行):
Mds和Nds是 shared memory 数组,作用域为 block。- 每个 block 会创建自己的一份
Mds/Nds,block 内所有线程共享访问。
寄存器变量(第 07–08 行):
bx, by, tx, ty是自动标量变量,存储在 寄存器 中,每个线程私有。- 目的是简化代码、避免重复访问
blockIdx/threadIdx。
输出元素索引(第 11–12 行):
- 每个线程负责计算一个 P 元素。
- 列索引:\(\text{Col} = bx \times
\text{TILE\_WIDTH} + tx\)
- 每个 block 横向覆盖
TILE_WIDTH个 P 元素。 - 前面的
bx个 block 覆盖 \(bx \times \text{TILE\_WIDTH}\) 个元素,再加 block 内偏移tx。
- 每个 block 横向覆盖
- 行索引:\(\text{Row} = by \times \text{TILE\_WIDTH} + ty\)
- 例:\(\text{block}_{1,0}\) 的 \(\text{thread}_{0,1}\) 计算 \(P_{2,1}\)(列=1,行=2)。
阶段循环(第 16 行):
ph表示已完成的阶段数,每阶段处理一个 M tile 和一个 N tile。- 循环次数 =
Width / TILE_WIDTH(假设整除)。
协作加载(第 19–20 行):
- 每个线程加载 M 和 N 各一个元素到 shared memory。
- M 元素线性索引:\(M[\text{Row} \times
\text{Width} + ph \times \text{TILE\_WIDTH} + tx]\)
- 行 =
Row,列 = \(ph \times \text{TILE\_WIDTH} + tx\)。
- 行 =
- N 元素线性索引:\(N[(ph \times
\text{TILE\_WIDTH} + ty) \times \text{Width} + \text{Col}]\)
- 行 = \(ph \times \text{TILE\_WIDTH} +
ty\),列 =
Col。
- 行 = \(ph \times \text{TILE\_WIDTH} +
ty\),列 =
- 由于
Row是ty的线性函数,且每个线程(tx, ty)唯一,因此TILE_WIDTH²个线程各自加载唯一的 M/N 元素。
第一个
__syncthreads()(第 21 行):- 保证所有线程完成 tile 加载后,才开始计算。
- 对应 read-after-write (true) dependence:读线程真正需要写线程的数据,必须等待。
内层点积循环(第 23–25 行):
每个线程用 shared memory 中的 tile 做部分点积: \[ \text{Pvalue } += \text{Mds}[ty][k] \times \text{Nds}[k][tx] \]
访问方向沿
k维度,数据来自Mds/Nds,不再访问 global memory。
第二个
__syncthreads()(第 26 行):- 保证所有线程用完当前 tile 后,才能进入下一阶段覆写 shared memory。
- 对应 write-after-read (false) dependence:写线程不需要读线程的数据,只是因为复用同一内存位置才需要等待。
写回结果(第 29 行):
- 所有阶段完成后,
Pvalue即为完整点积结果。 - 写回
P[Row * Width + Col]。
- 所有阶段完成后,
Strip-mining(循环拆分):
- 原始长循环(沿 k 维度)被拆成 外层循环(阶段)+ 内层循环(tile 内 k)。
- 每个阶段前后加 barrier,强制 block 内所有线程聚焦同一段输入数据。
- 这是 tiling 在数据并行程序中的关键实现手段。
性能收益:
- global memory 访问量降至原来的 1 / 。
- 算术强度从 0.25 OP/B 提升到 4 OP/B(TILE_WIDTH=16)。
- 例(A100,1555 GB/s):
- 无 tiling:\(1555 \times 0.25 \approx 389\) GFLOPS
- 有 tiling:\(1555 \times 4 \approx 6220\) GFLOPS
- 峰值:19,500 GFLOPS → tiling 后达到约 32% 峰值。
- 进一步优化可用 cuBLAS / CUTLASS 等高度优化库。
CPU vs. GPU tiling 的区别:
- CPU:依赖 cache 隐式保留复用数据。
- GPU:显式使用 shared memory 保留复用数据。
- 原因:SM 同时运行大量线程,cache 槽位竞争激烈,不可靠;shared memory 由软件显式管理,更可控。
简化假设(本节 kernel):
- 矩阵宽度是
TILE_WIDTH的整数倍。 - 矩阵是方阵。
- 下一节会加入边界检查,去掉这些假设。
- 矩阵宽度是
从教学版 tiled GEMM 到 CUTLASS GEMM 的演进:
- 核心 pipeline 结构相同:K 维度分 tile → load → sync → compute → sync。
- 差异在于每个环节的工程化优化:
- 索引:手写线性索引 → CuTe Layout
- 计算:CUDA core → Tensor Core MMA
- 搬运:同步 ld.global → TMA / cp.async 异步拷贝
- 流水线:单缓冲 → multi-stage 双/多缓冲
- 同步:
__syncthreads()→mbarrier - Shared memory:简单二维 → swizzled 布局(避免 bank conflict)
- 寄存器:每线程一个累加器 → Fragment(MMA 所需的分片)
- 层次:block tile → CtaTile / WarpTile / MmaTile
- Epilogue:直接写回 → epilogue pipeline
Boundary checks
扩展上一小节 kernel 支持 width 不是 tile 倍数情况。以 M/N/P 是 3 矩阵,tile 还是 \(2 \times 2\) 为例:
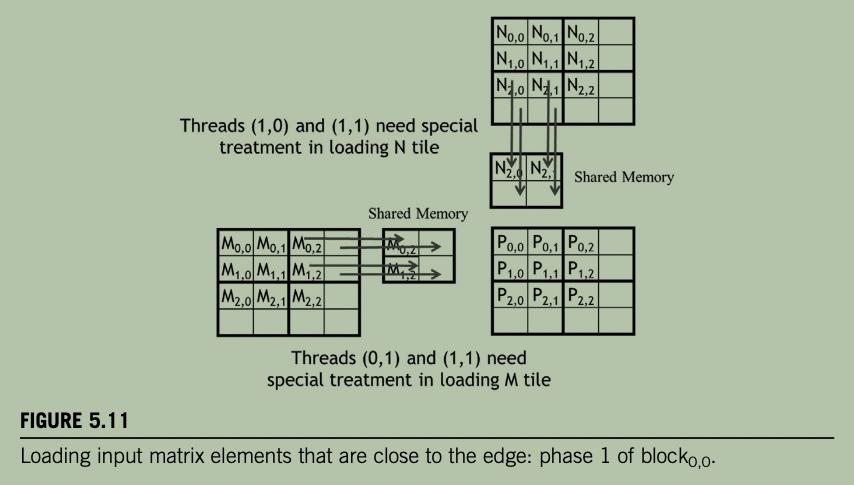
- 上图展示了 \(\text{block}_{0,0}\)
的第二个 phase 线程访存情况
- \(\text{thread}_{1,0}\) 和 \(\text{thread}_{1,1}\) 试图访问不存在的矩阵 M 中元素 \(M_{0,3}\) 和 \(M_{1,3}\) (矩阵 N 情况类似,只不过是列越界)
- 由于矩阵 M 是 row-major 存储,\(\text{thread}_{1,0}\) 试图访问的 \(M_{0,3}\) 存储位置上真实元素是 \(M_{1,0}\) ,这将导致错误的计算结果。(矩阵 N 对应的 tile 会有线程越界访问未分配给 N 的内存,可能导致 illegal memory access)
- 并非只有最后一个 phase 才需要考虑边界情况,以 \(\text{block}_{1,1}\) 为例,其第一个 phase 就可能访问不存在的元素:
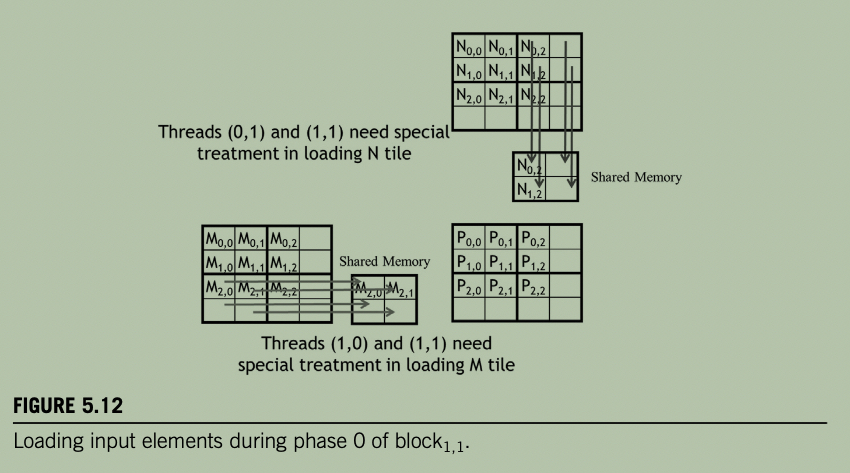
- 并不是仅让不需要计算 P 输出的线程不访问 M/N 就可以的,因为这些线程虽然不需要负责计算并写入 P,但是可能需要加载 M/N tile 到 shared memory,比如:\(\text{block}_{1,1}\) 的线程 \(\text{thread}_{0,1}\) 理论上需要计算不存在的 \(P_{2, 3}\),但是其需要加载 \(M_{2, 1}\) 供其他线程计算使用,因此不能简单屏蔽不需要计算 P 的线程。
- 负责计算 P 合法位置的线程也可能需要访问不存在的 M/N 元素。
- 因此:
- 加载任务与计算任务解耦:计算无效 P 元素的线程仍需参与加载。
- 需要三套独立边界检查:加载 M、加载 N、计算 P 各自检查。
- 不能用计算边界条件跳过整个线程的加载,否则共享内存数据缺失。
- A rule of thumb to follow is that every memory access needs to have a corresponding check that ensures that the indices used in the access are within the bounds of the array being accessed.
- 边界检查代码如下:
1 | |
带有边界检查的矩阵乘法 kernel main loop:
1 | |
- 从方阵乘法扩展到通用矩阵乘法 (Rectangular Matrix
Multiplication)
- 当前限制:目前实现的 kernel 仅支持方阵(\(Width \times Width\))。
- 通用情况:矩阵乘法支持矩形矩阵,即一个 \(m \times k\) 的 M 矩阵乘以一个 \(k \times n\) 的 N 矩阵,得到一个 \(m \times n\) 的 P 矩阵。
- 扩展方法(只需简单修改):
- 将原来的单一
Width参数替换为三个参数:m,k,n。 - 参数映射规则:
- 原
Width用于表示 M 的高度或 P 的高度 → 替换为m。 - 原
Width用于表示 M 的宽度或 N 的高度 → 替换为k。 - 原
Width用于表示 N 的宽度或 P 的宽度 → 替换为n。
- 原
- 将原来的单一
- 示例代码:
1 | |
Impact of memory usage on occupancy
核心问题
- 共享内存(shared memory)和寄存器一样,会限制 SM 上能驻留的线程数(占用率)。
- 每个线程使用的资源越多,SM 能同时驻留的线程数越少。
占用率计算(以 A100 为例)
A100 SM 可配置最多 164 KB shared memory,最多支持 2048 threads/SM。
要满占用率,每线程平均 shared memory 使用量不得超过: \[ \frac{164 \text{ KB}}{2048 \text{ threads}} = 82 \text{ B/thread} \]
不同 kernel 的 shared memory 使用对比
| Kernel | 每 block shared memory | 线程数/block | 平均 B/thread | 是否限制占用率 |
|---|---|---|---|---|
| Tiled matrix multiplication | \(2 \times \text{TILE\_WIDTH}^2 \times 4\) B | \(\text{TILE\_WIDTH}^2\) | 8 B/thread | 否 |
| 示例 kernel | 32 KB | 256 | 132 B/thread | 是 |
Tiled matrix multiplication:
- 每 block 使用 \(2 \times \text{TILE\_WIDTH}^2 \times 4\) B shared memory。
- 平均每线程 8 B → 远低于 82 B 上限 → occupancy 不受 shared memory 限制。
示例 kernel(32 KB / 256 threads):
每线程 132 B → 超过 82 B 上限。
SM 最多驻留: \[ \frac{164 \text{ KB}}{132 \text{ B/thread}} \approx 1272 \text{ threads} \]
占用率: \[ \frac{1272}{2048} \approx 62\% \]
设备差异与动态调整
- 不同设备、不同代的 SM 共享内存大小不同。
- 理想情况下,kernel 应能根据硬件可用 shared memory 动态调整使用量。
- 可通过
cudaGetDeviceProperties查询:devProp.sharedMemPerBlock:每个 SM 可用的 shared memory 量。
- 程序员可根据查询结果决定每个 block 使用多少 shared memory。
静态 vs. 动态 shared memory
静态声明:
1 | |
- 大小在编译期固定。
- 修改
TILE_WIDTH需重新编译。 - 无法在运行时调整 shared memory 用量。
动态声明:
1 | |
- 使用
extern __shared__,数组大小在声明时省略。 - Mds 和 Nds 合并为一个一维动态数组。
- 需手动定义 Mds 和 Nds 的起始位置。
- 访问时用线性化索引,如
Mds[ty * TILE_WIDTH + tx]。
动态配置 kernel launch:
1 | |
- 第三个配置参数
size指定动态 shared memory 的总字节数。 - kernel 额外接收两个参数:Mds 和 Nds 各自的字节大小(此处为
size/2)。 - 例:\(16 \times 16\) tile,size = \(2 \times 16 \times 16 \times 4 = 2048\) B,每个 section 1024 B。
kernel 关键变化
1 | |
关键结论
- shared memory 使用量是占用率的重要限制因素之一,与寄存器并列。
- 每线程平均 shared memory 超过 SM 容量 / 最大线程数时,占用率下降。
- 通过
extern __shared__+ 动态 launch 参数,kernel 可在运行时适应不同设备的 shared memory 容量。 - 动态 shared memory 需手动管理内存布局(Mds/Nds 分区)和线性化索引。
Summary
- 内存速度是现代处理器性能的关键瓶颈
- 要充分利用 CUDA 设备的执行吞吐,kernel 必须追求高的 compute to global memory access ratio(算术强度)。
- 比率低 → kernel 是 memory-bound,执行速度受限于操作数从内存中获取的速率。
- CUDA 高速内存层级
- 寄存器、共享内存、常量内存:容量小,但访问速度远高于 global memory。
- 有效使用这些内存需要重新设计算法。
- Tiling 策略
- 以矩阵乘法为例,通过 tiling 增强数据访问局部性,有效利用 shared memory。
- 使用 barrier synchronization 强制多个线程在每个阶段共同关注输入数据的子集,使子集数据放入高速内存,从而获得更高访问速度。
- Tiling 几乎对所有并行计算系统都有效,因为需要数据局部性来利用高速内存(如多核 CPU 的 on-chip cache)。
- 资源限制与 occupancy
- 特殊内存容量有限且依赖具体实现。
- 一旦超出容量,会限制每个 SM 上可同时执行的线程数,影响计算吞吐和延迟容忍能力。
- 推理硬件限制是并行编程的关键能力。
- 本章内容回顾
- 引入 locality、tiling、不同 CUDA 内存类型。
- 实现了 tiled matrix multiplication kernel(shared memory)。
- 讨论了边界条件检查以支持任意数据维度。
- 简要介绍了动态共享内存分配,使 kernel 可根据硬件能力调整每个 block 使用的 shared memory 大小。
- 未讨论寄存器在 tiling 中的使用,将在本书第二部分讨论并行算法模式时介绍。
- 核心 takeaway
- 高性能并行程序必须表现出数据访问局部性,以有效利用高速内存。
- Tiling 是实现局部性的通用且有效的手段。
- 必须时刻关注硬件资源限制及其对 occupancy 的影响。