LLM Systems 20: LLM Quantization: GPTQ
0. Recap
- low-bit number representation in computer
- BF16: 16-bit half precision floating point numbers, better for ML
- int8
- Direct quantization
- Absmax: linearly scale according to max abs value
- Zero-point: finding zero-point and scale
- Layer-wise quantization approaches
- AdaQuant
- KD: ZeroQuant
- LLM.int8()
1. Theoretical Background: OBS & OBQ
GPTQ 并非横空出世,其二阶误差补偿的核心数学框架源自经典的神经网络剪枝与量化理论。
1.1 Optimal Brain Surgeon (OBS)
- 起源:Hassibi & Stork (1993) 提出的二阶网络剪枝算法(General Network Pruning)。
- 核心问题:在不重训练的前提下,若强行剪掉(置 0)权重矩阵中的某一个权重 \(w_p\),如何调整剩余权重以最小化模型重构损失的增加?
- 数学推导(泰勒展开二阶近似):
假设模型在一阶极小值点附近,对损失函数做泰勒展开并保留二阶项: \[\delta L \approx \frac{1}{2} \delta w^T H \delta
w\] 约束条件为第 \(p\)
个权重被清零(\(\delta w_p =
-w_p\))。利用拉格朗日乘子法求解出:
- 删除权重 \(w_p\) 带来的最小损失增加: \[\Delta L = \frac{1}{2} \frac{w_p^2}{[H^{-1}]_{pp}}\]
- 对剩余未剪枝权重的最优二阶补偿: \[\delta_p = -\frac{w_p}{[H^{-1}]_{pp}} \cdot H^{-1}_{:, p}\] 其中 \(H\) 为损失函数对权重的 Hessian 矩阵(维度 \(d \times d\)),\(H^{-1}_{:, p}\) 扮演了按特征曲率指明补偿方向的角色。
- 计算瓶颈:全网权重向量维度 \(d = d_{\text{row}} \cdot d_{\text{col}}\),存储与求逆 Hessian 的复杂度为 \(O(d^3)\)。每剪枝一个权重都需要更新 \(H^{-1}\),总复杂度高达 \(O(d^4)\),在大模型上完全不可行。
1.2 Optimal Brain Quantization (OBQ)
- 推广:Frantar et al. (2022) 将 OBS 的剪枝框架推广到后训练量化(PTQ)。
- 核心思想:不将权重置 0,而是将其四舍五入吸附到最近的离散量化网格 \(\text{quant}(w_q)\) 上,并利用二阶信息将产生的舍入误差补偿给剩余未量化的权重 \(F\)。
- 数学公式:
- 贪心挑选当前最佳量化权重 \(w_q\)(挑选使损失增加最小的权重): \[w_q = \arg\min_{w_q} \frac{(\text{quant}(w_q) - w_q)^2}{[H_F^{-1}]_{qq}}\]
- 对剩余未量化权重 \(F\) 的最优补偿更新 \(\delta_F\): \[\delta_F = -\frac{w_q - \text{quant}(w_q)}{[H_F^{-1}]_{qq}} \cdot (H_F^{-1})_{:, q}\]
- Hessian 矩阵显式化: 逐层重构目标为 \(\arg\min_{\hat{W}} | W X - \hat{W} X |_2^2\),对应的 Hessian 矩阵直接等于输入特征的协方差矩阵: \[H = 2 X X^T\] (其中 \(X\) 为校准数据的层输入激活矩阵,协方差反映了特征通道间的联动补偿关系)。
- OBQ 的优化突破:
- Row-wise Decomposition(行独立分解):观察到重构目标在矩阵行之间是独立的:\(\sum_{i=1}^{d_{\text{row}}} | W_{i,:} X - \hat{W}_{i,:} X |_2^2\)。行与行之间没有 Hessian 交互,因此把 \(d \times d\) 的超大 Hessian 降维拆解为 \(d_{\text{row}}\) 个独立的 \(d_{\text{col}} \times d_{\text{col}}\) Hessian。
- Rank-1 Inverse Update(高斯消元一步扣除):每量化完一个权重 \(w_q\),通过一步高斯消元直接更新逆 Hessian,避免重新求逆: \[H_{-q}^{-1} = H^{-1} - \frac{1}{[H^{-1}]_{qq}} H^{-1}_{:, q} H^{-1}_{q, :}\]
- 复杂度降低至 \(O(d_{\text{row}} \cdot d_{\text{col}}^3)\),成功在 ResNet-50(25M)等中小模型上实现 1 小时内量化。
- OBQ 难以扩展至千亿大模型: 由于 OBQ 采用“贪心搜索”(每行独立寻找当前误差最小的权重),导致矩阵中每一行被量化的列顺序完全不同**。因此,逆 Hessian 矩阵 \(H^{-1}\) 必须针对每一个元素独立更新(共 \(d_{\text{row}} \times d_{\text{col}}\) 次),面对千亿模型需要计算数万 GPU 小时。
2. GPTQ Algorithm
2.1 Overview & Motivation
- 逐层量化目标(Layer-Wise Quantization): \[\arg\min_{\hat{W}} | W X - \hat{W} X
|_2^2\] 其中:
- \(W\):原始全精度(FP16/BF16)权重矩阵(如 FFN 或 Self-Attention 中的线性投影层)。
- \(\hat{W}\):求解的目标低比特(INT3/INT4)量化权重矩阵。
- \(X\):流经当前线性层的输入特征数据/激活值矩阵(形状为 \(d_{\text{in}} \times \text{Len}\))。
- 预先固定网格(Fixed Grid Assumption):在开始迭代量化前,各层的量化刻度尺(Scale & Zero-point)就已经预先计算并锁死,迭代过程中仅通过 Hessian 信息调整未量化权重的浮点数值,而不动态改变网格本身。
- GPTQ 的两大核心 Intuition:
- 按列块/逐列固定顺序量化(Quantizes one column-block of weights at a time): 摒弃 OBQ 针对单元素的复杂贪心搜索,强制所有行采用统一的列顺序推进量化,使得 Hessian 逆矩阵 \(H^{-1} = (2XX^T)^{-1}\) 可以在全矩阵所有行之间跨行共享复用。
- 未量化权重的实时二阶补偿(Updates all not-yet-quantized weights): 利用输入特征 \(X\) 算出的 Hessian 矩阵曲率信息,把当前列四舍五入产生的舍入误差实时反向传导并平摊给右侧所有尚未量化的权重,动态抹平量化损失。
2.2 Method & Core Steps
GPTQ 的成功依赖于三大递进式的核心突破:
Step 1: Arbitrary Order Insight (固定列顺序洞察)
- 问题:OBQ 每行独立贪心选择列,导致 \(H^{-1}\) 无法跨行复用,复杂度高达 \(O(d_{\text{row}} \cdot d_{\text{col}}^3)\)。
- 洞察:在千亿大模型的高维参数空间中,按照任意固定的列顺序(如简单的从左到右逐列)量化权重,最终的重构误差与复杂的贪心搜索几乎没有差异。前期产生的少量较大误差会被后面大量未量化的权重在迭代更新中完美平摊补偿。
- 突破:强制矩阵所有行按照完全相同的列顺序执行量化。由于 Hessian 矩阵 \(H = 2XX^T\) 仅取决于输入激活值 \(X\),与权重 \(W\) 的具体数值无关,因此未量化集合 \(F\) 以及逆 Hessian 矩阵 \(H^{-1}\) 在所有行完全相同。
- 收益: \(H^{-1}\) 的扣除更新次数从 \(d_{\text{row}} \cdot d_{\text{col}}\) 次剧减为按列更新 \(d_{\text{col}}\) 次。计算复杂度暴降为 \(O(\max(d_{\text{row}} \cdot d_{\text{col}}^2, d_{\text{col}}^3))\),算法速度提升了 \(\min(d_{\text{row}}, d_{\text{col}})\) 倍(数个数量级)。
Step 2: Lazy Batch-Updates (延迟批量更新)
- 问题:直接按列循环更新时,由于每次更新只执行极其微小的 FLOPs 计算,计算访存比(Compute-to-memory-access ratio)极低,导致运行卡在 GPU 显存读取带宽瓶颈(Memory Bandwidth Bound)上。
- 洞察:第 \(i\) 列在量化时的四舍五入决策仅取决于此前对该列的累积更新,对后面列的更新在当前时刻并不需要立刻写入全局矩阵。
- 突破(Block 级延迟更新):
- 将权重矩阵按列划分为 Block(如 \(B=128\) 列)。
- Block 内部局部更新:仅在当前 Block 内部逐列量化,并利用局部 \(B \times B\) 的 \(H^{-1}\) 矩阵更新 Block 内右侧未量化的列。
- Block 间延迟全局更新:当前 Block 内部 128 列处理完毕后,拼合积累的误差矩阵 \(E\),调用 GPU 原生高效的大矩阵乘法(GEMM),一次性更新 Block 右侧所有剩余全局未量化权重: \[W_{:, (i+B):} = W_{:, (i+B):} - E \cdot H^{-1}_{i:(i+B), (i+B):}\]
- 收益:在不改变理论计算量的前提下,将散乱低效的显存访存打包为高吞吐的 GEMM 操作,带来近一个数量级的实际运行提速。
Step 3: Cholesky Reformulation & Damping (Cholesky 预计算与阻尼)
- 问题:千亿模型下经历了数千次 Block 更新与矩阵扣除后,浮点数的累积数值误差极易导致逆 Hessian 矩阵 \(H^{-1}\) 失去正定性(Become Indefinite),引发更新方向倒错、剩余权重剧烈震荡爆表,导致量化崩溃。
- 突破:
- 对角线阻尼(Damping):在 Hessian 矩阵对角线上增加常数项 \(\lambda I\)(通常取对角线均值的 1%),注入“正数补丁”,确保矩阵绝对强正定。
- Cholesky 预计算:观察到二阶补偿仅需要 \(H^{-1}\) 从对角线开始的行信息,而对称逆 Hessian 矩阵的逐行扣除在数学上完全等价于 Cholesky 分解(\(A = L \cdot L^T\))。因此利用高性能 GPU Cholesky Kernel,在循环开始前一次性预计算: \[G = \text{Cholesky}((2X X^T + \lambda I)^{-1})^T\]
- 收益:彻底消除了循环中反复显式求逆带来的数值积累误差,极大增强了算法在大模型上的鲁棒性,并借由 Cholesky Kernel 获得了额外加速。
The Full Algorithm
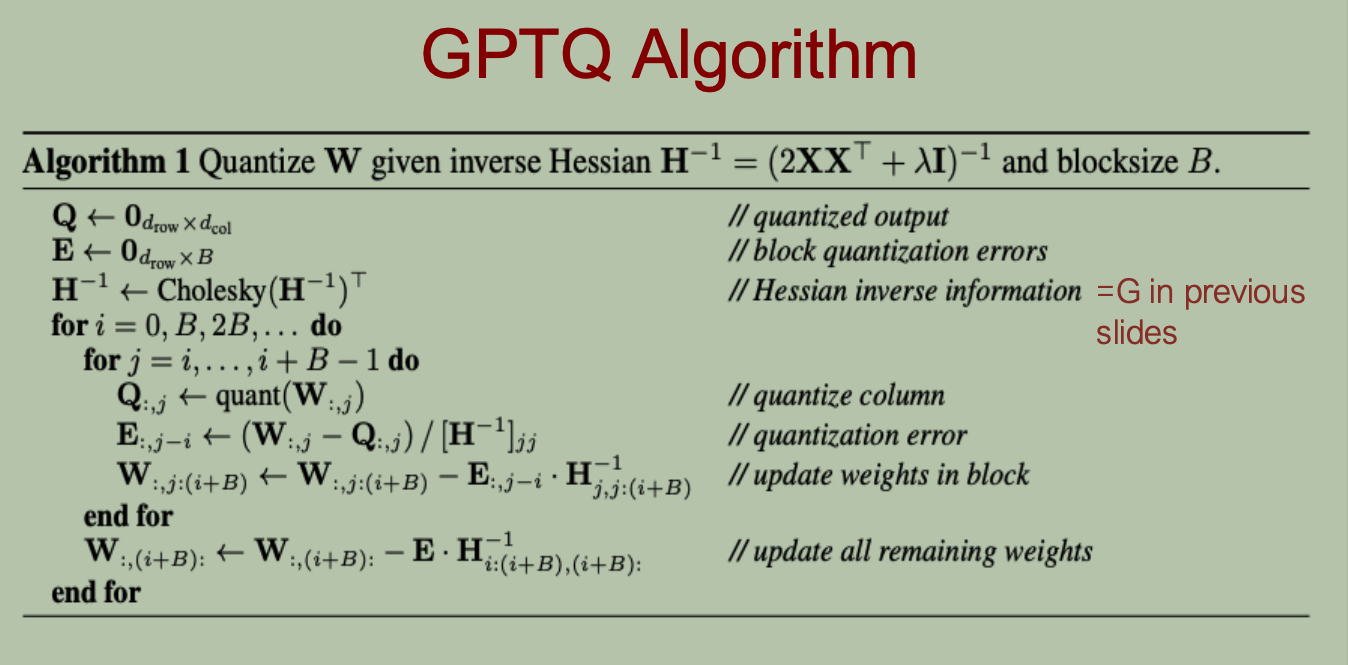
2.3 Code Walkthrough
基于开源实现(GPTQ-for-LLaMa/gptq.py )剖析核心步骤的代码体现:
1. 校准集 Hessian
矩阵构造与增量累加(add_batch)
1 | |
- 说明:通过传入小批量无标注校准文本(如 128 段 C4
随机样本),计算当前线性层的输入特征协方差矩阵
self.H。
2. 注入阻尼与 Cholesky 逆矩阵预计算(fasterquant
预处理)
1 | |
- 说明:对应 Step 3。预先算好上三角 Cholesky 矩阵
Hinv,彻底消除量化循环中的显式矩阵求逆。
3. Block 内逐列量化与 Block 间延迟 GEMM
更新(fasterquant 主循环)
1 | |
- 说明:内层循环只修改当前列块
W1,减少显存读写;外层循环通过单次Err1.matmul(...)GEMM 矩阵乘法快速刷新右侧所有剩余权重。
4. AutoGPTQ 工具高层调用
1 | |
3. Conclusion
- GPTQ
- approximate second-order of weights
- layer-wise quantization + compensation for errors + precompute
- accurately compress some of the largest publicly-available models down to 3 and 4 bits, and bring end-to-end speedups
- Limitations
- Theoretical computation is the same
- Focus on weight quantization, and does not consider activation quantization
LLM Systems 20: LLM Quantization: GPTQ
https://arcsin2.cloud/posts/2026/11/4083942997/