LLM Systems 21: Parameter Efficient Fine-Tuning for LLM
0. Recap
- Direct quantization for low-bit numbers
- absmax: linearly scale according to max abs value
- zero-point: finding zero-point and scale
- Layer-wise quantization approaches
- AdaQuant / KD: ZeroQuant / LLM.int8()
- GPTQ
- layer-wise quantization + compensation for errors + precompute
- accurately compress some of the largest publicly-available models down to 3 and 4 bits, and bring end-to-end speedups
1. Overview of Parameter Efficient Fine-Tuning
Parameter Efficient Fine-tuning (PEFT)
PEFT 的核心思路是仅更新模型的一小部分参数或低秩矩阵,冻结大部分原始参数:
- LoRA:权重梯度、优化器状态及 Adapter 权重的显存开销大幅降低,使得微调 LLaMA-8B 的总显存需求降至 ~33GB,可单张 A100 GPU 运行。
- 进一步结合量化(QLoRA):将预训练模型权重压缩至 4-bit,使得微调 LLaMA-8B 的显存需求进一步降低至 ~9.2GB。
PEFT Approaches 分类
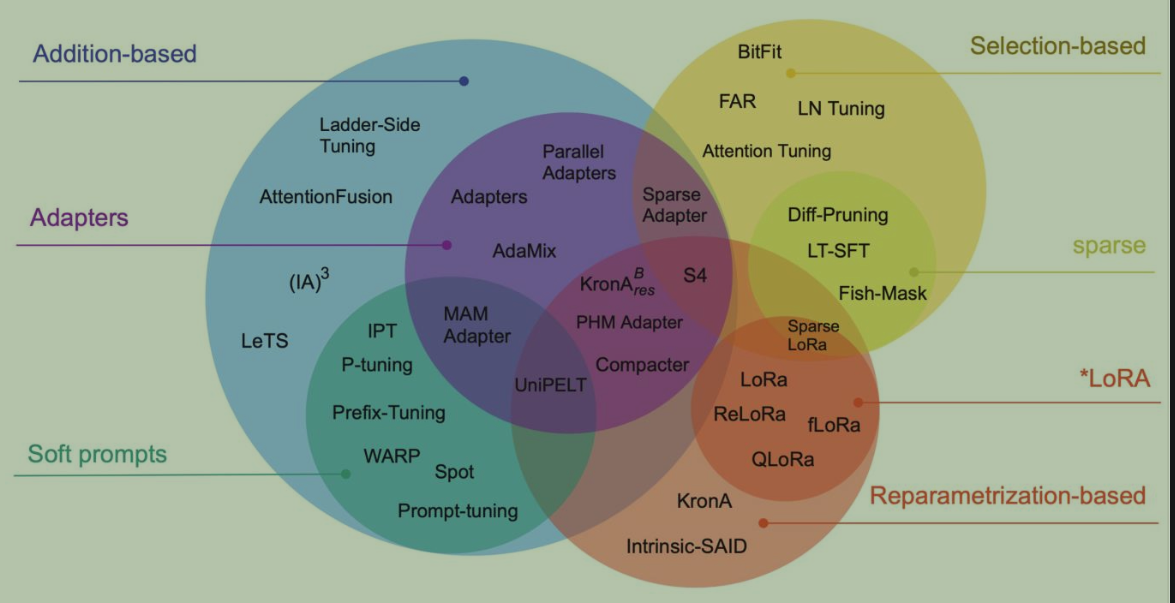
- 选择性方法(Selective Methods):
- 原理:仅对模型参数的特定子集进行微调。
- 代表技术:BitFit、LN Tuning、Attention Tuning、Diff-Pruning 等。
- 重参数化方法(Reparameterization Methods):
- 原理:利用低秩(Low-rank)结构来表征参数的更新量。
- 代表技术:LoRA、ReLoRA、fLoRA、QLoRA、KronA 等。
- 附加方法(Additive Methods):
- 原理:冻结原模型,通过在模型中添加额外的可训练层或参数来进行微调。主要包含两大子类:
- Adapters:在模型内部插入小型瓶颈层(如 Adapters、Parallel Adapters、Compacter 等)。
- Soft Prompts:在输入层或中间注意力层追加可训练的虚拟 Token/Prompt 向量(如 Prompt Tuning、Prefix-Tuning、P-tuning 等)。
- 原理:冻结原模型,通过在模型中添加额外的可训练层或参数来进行微调。主要包含两大子类:
Reference:
- Scaling Down to Scale Up: A Guide to Parameter-Efficient Fine-Tuning. Lialin et al. 2024.
2. LoRA: Low-rank Adaptation
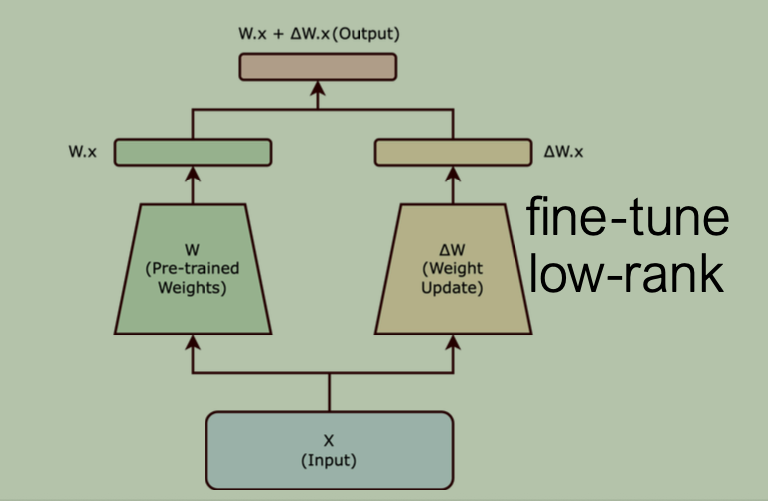
- 核心思想:冻结预训练好的原始权重矩阵 \(W_0\),仅通过训练一个低秩分解更新矩阵 \(\Delta W\) 来拟合微调的参数变化。
- 形式化描述:
\[ W' = W_0 + \Delta W = W_0 + A \cdot B \]
其中 \(A \in \mathbb{R}^{d \times r}\),\(B \in \mathbb{R}^{r \times d}\),且秩满足 \(r \ll d\)。
- 作用位置:通常主要应用于 Transformer 的 自注意力层(Self-Attention) 权重矩阵(如 \(W_q, W_v\) 等),不应用于 FFN Linear 层(认为 FFN Linear 权重存储了知识)。
- 无推理延迟(Zero Additional Latency):微调结束进行推理时,只需提前将低秩矩阵融合进主模型 \(W' = W_0 + A \cdot B\),推理计算与标准大模型完全一致,不会增加任何额外计算耗时或延迟。
- 高效任务/领域切换:在不同下游任务间切换时,无需重新加载大模型主干,只需通过矩阵加减法替换 LoRA 权重即可:\(W'' = W' - A \cdot B + A'' \cdot B''\) ,其中 \(A'', B''\) 为新任务的 LoRA 权重。
- 前向传播(Forward):输出计算为原始路径与低秩路径之和,即 \(h = W_0 x + A \cdot B x\)。
- 反向传播(Backward):由于原始权重 \(W_0\) 保持冻结,只需对小矩阵 \(A\) 和 \(B\) 计算梯度:
\[ \frac{\partial L}{\partial A} = \frac{\partial L}{\partial (W_0 x + A \cdot B x)} \cdot \frac{\partial (W_0 x + A \cdot B x)}{\partial A} = g_{out} \cdot (B x)^T, \quad \\ \\ \frac{\partial L}{\partial B} = \frac{\partial L}{\partial (W_0 x + A \cdot B x)} \cdot \frac{\partial (W_0 x + A \cdot B x)}{\partial B} = (g_{out}^{T} \cdot A)^{T} x^T = (A^{T} \cdot g_{out}) x^T \]
Memory Consumption of LoRA Training
以 LLaMA-8B 为例:
- 可训练参数量:从 80亿(8B)减至约 400万(4M),权重仅占约 8MB。
- 优化器状态显存(Adam):从 48GB 降至仅 ~24MB。
- 总工作显存:从全参数微调的 ~80GB 降低至 ~33GB,可直接在单张 NVIDIA A100 GPU 上运行。
实验分析与核心结论
- 覆盖任务与基线:在自然语言理解(NLU,如 RoBERTa/DeBERTa 运行 GLUE 榜单)、自然语言生成(NLG,如 GPT-2/GPT-3 175B)以及数学推理(GSM8K)等多个任务上,与全参数微调及 Adapter、Prefix-Tuning 等基线进行了对比。
- 秩 \(r\) 的选择:实验表明,增加秩 \(r\) 并不一定会包含更多有意义的子空间。设置极小的秩(如 \(r = 8\) 或 \(r = 16\))就能达到甚至超越全参数微调的效果。
- 大模型扩展性(Scalability):随着模型参数扩展至 GPT-3 175B 和 LLaMA-70B,LoRA 展现出极高的参数利用效率和出色的任务性能。
3. QLoRA: Quantization + Low-rank training
3.1 Overview
- QLoRA 属于 Quantization-Aware Training (QAT) 类方法。
- Quantization-Aware Training (QAT):integrates the weight conversion process during the training stage. often superior model performance.
- QLoRA = Low-rank + Quantized training
- 主要创新点:
- 4-bit 正态分布参数存储(4-bit Normal Float for storage);
- 双重量化(Double Quantization);
- 分页优化器 (Paged Optimizers);
- 使用 BF16 类型进行计算(计算到某个层时,先反量化为 BF16 类型再计算)。
QLoRA algorithm 整体流程
- 两种数据类型:
- NF4(4-bit NormalFloat)存储格式;
- BF16 计算格式;
- 算法流程:
- 将模型权重双重量化为 NF4 格式。
- 将权重双重反量化为 BF16 格式。
- 用 BF16 格式进行 forward 和 backward 计算。
- 仅对 LoRA 参数计算梯度(BF16 格式)。
3.2 Method
3.2.1 4-bit NormalFloat (NF4) 数据类型
- 背景与问题:标准的 4-bit 线性量化(如 absmax)采用均匀划分区间的方式,在处理非均匀分布的数据时会引入较大的量化误差。
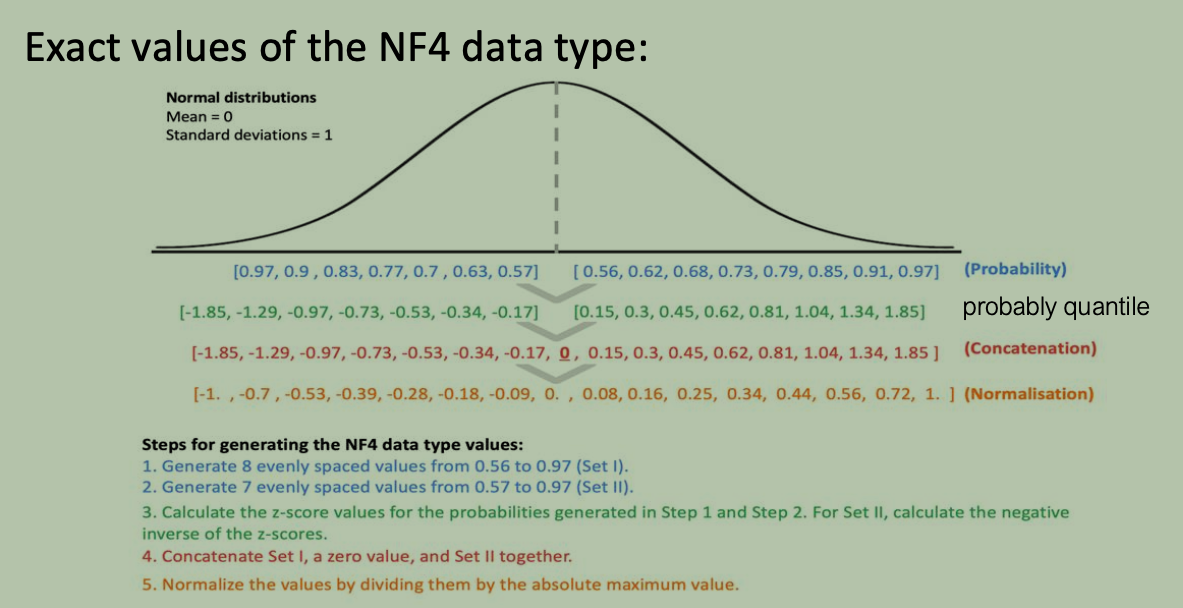
- 正态分布设计:由于预训练模型的权重通常呈现均值为 0 的正态分布,NF4 专为这种分布建立了包含 16 个非线性采样点的分位数查找表(Lookup Table)。
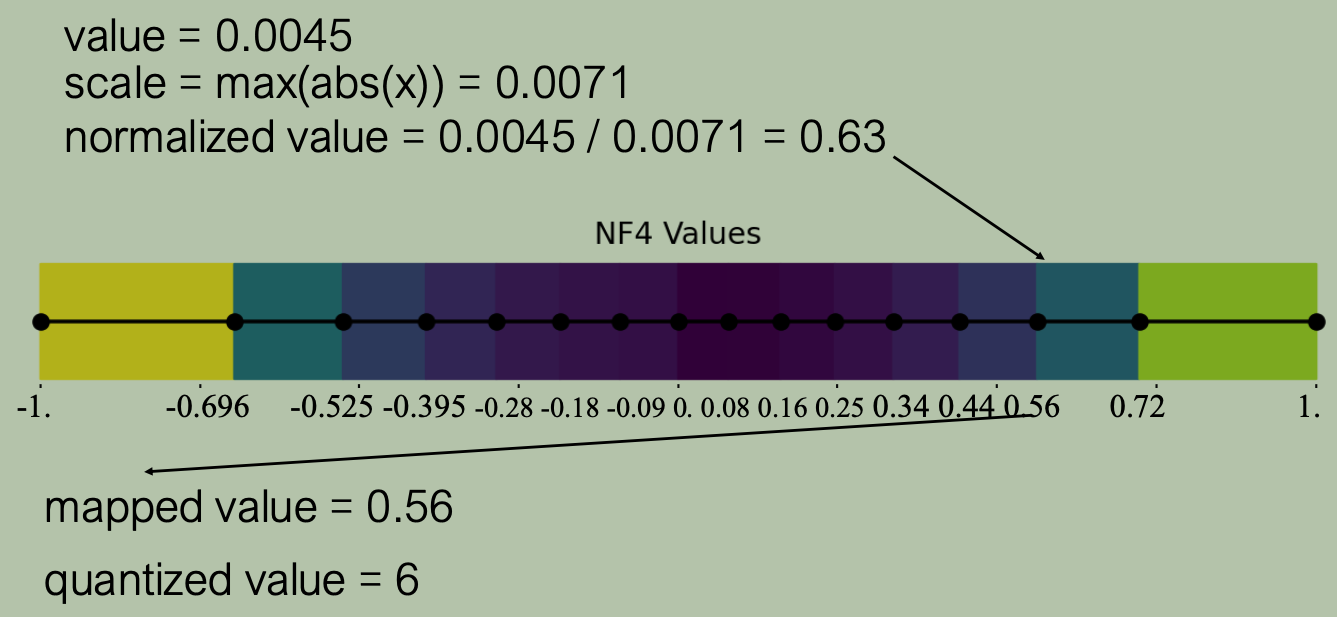
- 量化步骤:
- 将权重按 64 个数字划分为一个 Block(Block size = 64)。
- 找到该 Block 内的最大绝对值作为缩放因子(Scaling Factor),计算规范化数值 \(\hat{x} = \frac{x}{\text{scale}}\) 。
- 将规范化数值在 NF4 查找表中匹配最近邻点,输出对应的量化索引(范围为 [-7, 8])。
- 整个模型共享一个 NF4 Lookup Table,每个 block 有各自的 scale 和量化后数值表示。
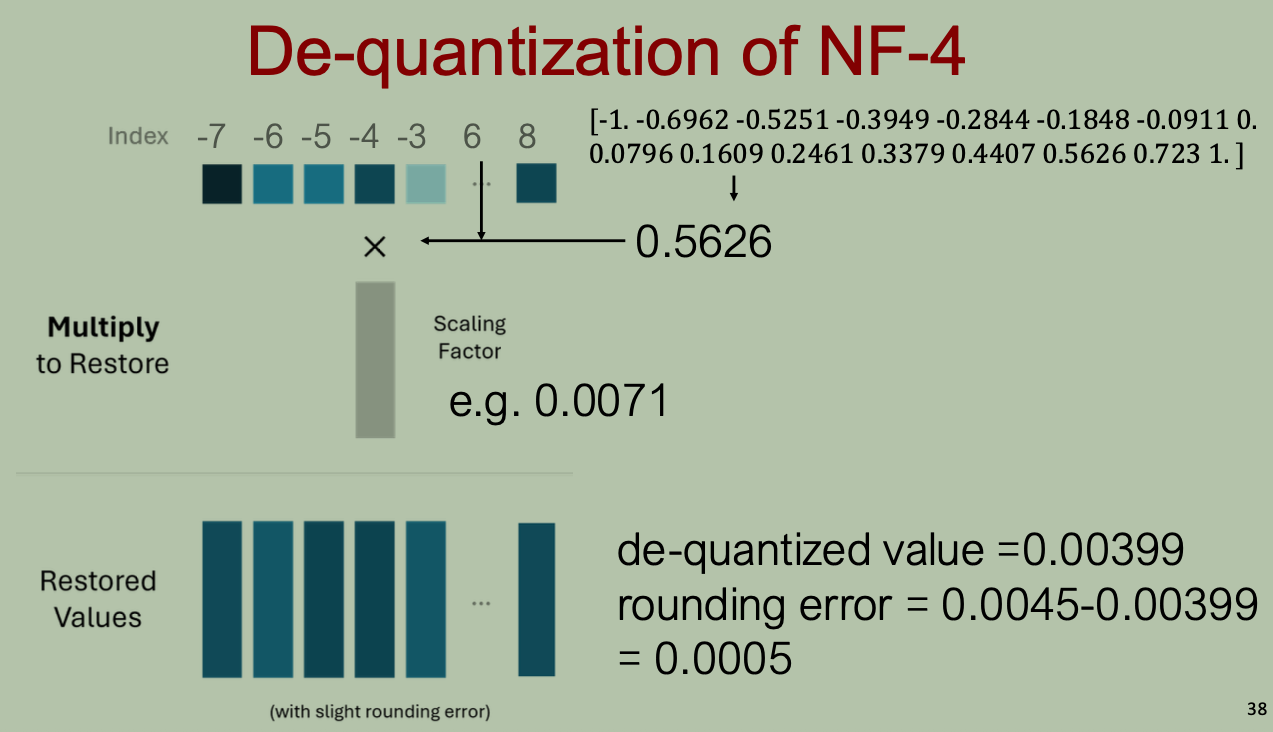
- 反量化:前向计算时,通过查找表将 4-bit 索引映射回浮点数,再乘以缩放因子恢复原值。
NF4 量化与反量化过程示意图
Lookup Table 构建
- 直观理解:
- 由于预训练大模型权重在规范化后呈标准正态分布 \(\mathcal{N}(0, 1)\),传统 INT4 的均匀划分(absmax)会导致高密度区域(0 附近)量化误差极高。NF4 的核心就是在累积概率分布(CDF)上做等概率分位数划分,使每个 4-bit 量化区间在信息论上具有相同的期望概率,从而最大程度降低量化信息损失。
- 构建流程:
- 假设分布:假定规范化后的模型权重服从标准正态分布 \(\mathcal{N}(0, 1)\)。
- 概率分割与尾部裁剪:将累积概率分布划分,同时裁剪掉两端极小概率的极端尾部(避免离群点拉大区间)。
- 分位数映射 (Z-score):通过正态分布的反累积分布函数(Inverse CDF / Quantile Function),求出概率点对应的原始变量取值(Z-score)。
- 归一化缩放:将得到的 Z-score 统一除以最大绝对值,缩放到 \([-1.0, 1.0]\) 区间,得到全局固定的 16 个 NF4 标量查找表。
NF4 v.s. Absmax 与量化方法的先验/假设
量化算法设计的本质:量化器(Quantizer)的效率,取决于其先验假设(Prior)与真实数据分布(Data Distribution)的匹配程度。
从信息论与统计学的角度来看,对比 NF4 与 Absmax:
- 传统 Absmax / 线性量化(Uniform Quantization)
- 先验假设:权重服从均匀分布 \(W \sim \text{Uniform}[-a, a]\)。
- 设计策略:采用 等间距步长(Fixed Step Size) 划分区间。
- 痛点:在大模型中,极少有权重会落在两端极端位置。按均匀分布划分,会导致大量采样点浪费在几乎没有权重的“空白区域”,而权重极其密集的 0 附近区域却因为分辨率不够而产生了巨大的量化噪声。
- QLoRA 的 NF4(NormalFloat 4)
- 先验假设:权重服从正态分布 \(W \sim \mathcal{N}(0, \sigma^2)\)。
- 设计策略:采用 等概率分位数(Equi-probable Quantiles) 划分区间。
- 优势:把采样点大量“压”在概率密度极高的高频区域(0 附近),而在稀疏的尾部区域拉大间距。这本质上是在已知正态分布先验下,实现了信息熵最大化(Entropy Maximization)——让每一个 4-bit 编码所代表的概率质量相等。
从 NF4 的原理更进一步,任意分布指定目标量化 bits(假设希望量化为 \(b\) 个 bits),如何获取接近最优的量化结果?
- 只要已知任意连续概率密度函数 \(f(x)\),通过将其累积分布函数(CDF)在 \([0, 1]\) 区间内做 \(2^b\) 等分,再通过反函数 \(F^{-1}(p)\) 求得映射标量,就能实现熵最大化(Maximum Entropy)的标量量化最优解。
- 理论基础:
- 信息熵最大化(Max-Entropy): 如果把 CDF 均匀切分为 \(2^b\) 份,就能确保每个量化区间被数据落入的概率严格等于 \(\frac{1}{2^b}\)。此时,量化后的离散随机变量达到了最大信息熵 \(H = b\text{ bits}\),没有浪费任何 1 bit 的编码容量。
- NF4 的定位: NF4 恰恰就是这个通用理论在 “先验分布 \(f(x) = \mathcal{N}(0, 1)\)” 且 “目标位数 \(b=4\)” 时的特例实现。
- 为什么这一量化方式没有被广泛使用?
- 对模型权重(静态)可行,但是对于激活值(分布动态变化)做量化,动态分布拟合的计算开销很大,导致量化耗时增加,无法补偿带来的量化精度提升。
- 计算时需要先查找 Lookup Table 反量化为 BF16 等格式计算,无法利用 GPU 硬件提供的原生 int4/int8 等计算加速。
- 极端离群点(Outliers)与重尾分布的破坏(Salient Outliers
Problem):纯粹按 CDF 概率均匀切分时,由于离群点的发生概率极低(如小于
\(0.01\%\)),它们会被强行压缩挤进最大或最小的那个量化
Bucket
里,导致离群点的绝对数值精度发生巨大失真。而在大模型中,这些极少数的离群点往往承载了模型关键的注意力与推理能力。
- 后来的工作(如 AWQ、SmoothQuant、SpQR)退而求其次:不强行做纯 CDF 量化,而是专门把这些 Outlier 抽出来保留为 FP16,其余正常分布部分再做量化。
3.2.2 双重量化 (Double Quantization, DQ)
- 动机:为了保证量化精度,NF4 采用了较小的 Block size(64),但这导致每个 Block 需存储一个 FP32 缩放因子,产生 \(32 / 64 = 0.5\text{ bits/param}\) 的额外显存开销。
- 双重压缩机制:对第一级量化产生的缩放因子进行二次量化。它将每 256 个 FP32 缩放因子看作一组,采用 FP8 进行二次量化,仅保留一个 FP32 存储第二次量化的 Absmax 缩放因子。
- 显存节省:成功将缩放因子的显存开销从 0.5 bits/param 大幅压缩至约 0.127 bits/param(0.125(\(\frac{8}{64}\)) + 0.002(\(\frac{32}{64 \times 256}\)) bits/param)。
- 前向计算公式:
\[ Y^{\text{BF16}} = X^{\text{BF16}} \text{doubleDequant}(c_1^{\text{FP32}}, c_2^{\text{k-bit}}, W^{\text{NF4}}) + X^{\text{BF16}} L_1^{\text{BF16}} L_2^{\text{BF16}} \]
其中 \(\text{doubleDequant}(\cdot)\) 函数在运行时将 NF4 权重重新解压为 BF16 参与矩阵运算。
3.2.3 分页优化器 (Paged Optimizers)
- 动机:在大模型训练过程中,激活值或梯度数据的突发峰值容易导致 GPU 显存溢出(OOM)。
- 工作机制:借助 NVIDIA Unified
Memory(统一内存)技术,在内存与显存之间实现自动的页对页(Page-to-page)传输。
- 类似于操作系统中 CPU 内存与磁盘之间的虚拟内存换页。
- 自动调度:将优化器状态分配在分页内存中;当 GPU 显存出现临界溢出时,系统会自动将优化器状态换出(Evict)至 CPU 内存,待进入优化器更新阶段时再重新拉回 GPU,有效规避了训练中断。
4. Code Walkthrough
4.1 LoRA Code Walkthrough
代码:
1 | |
4.2 QLoRA code
代码:
训练加载配置:
1 | |
5. Conclusion
- LoRA
- LoRA/CIAT enables cost-effective adaptation of large models by modifying fewer parameters (low-rank).
- Scalability: Effective for giant models like GPT-3, making adaptation more accessible.
- Low-Data Efficacy: Superior in low-data settings, reducing the need for large datasets.
- QLoRA
- QLoRA: double quantizing weights using NF4, computing in BF16
- QLoRA matches original Low-rank Adapter performance.
- 1st method that enables fine-tuning of 33B LLM on a single consumer GPU