LightSeq: A High Performance Inference Library for Transformers
- LightSeq: A High Performance Inference Library for Transformers
- arXiv 提交日期:23 Oct 2020
- GitHub:https://github.com/bytedance/lightseq
- 作者:
摘要
Transformer、BERT 及其变体在自然语言处理领域取得了巨大的成功。由于 Transformer 模型体积庞大,如何在实际工业应用中进行模型服务(Serving)成为了一个挑战。在本文中,我们提出了 LightSeq,这是一个针对 Transformer 家族模型的高效推理库。LightSeq 包含一系列 GPU 优化技术,用于简化神经网络层的计算并减少内存占用。LightSeq 可以轻松导入使用 PyTorch 和 TensorFlow 训练的模型。在机器翻译基准测试上的实验结果表明,与 TensorFlow 相比,LightSeq 实现了高达 14 倍的加速;与并发 CUDA 实现的 FasterTransformer 相比,实现了 1.4 倍的加速。代码已开源,访问地址为:https://github.com/bytedance/lightseq。
1. Introduction
Transformer 模型在多种 NLP 任务中被广泛使用,但是随着模型规模的增大,给推理和部署带来挑战:
- 训练框架如 PyTorch/TensoFlow,允许灵活的模型结构,导致了额外内存分配和小 kernel launch 开销。因此直接使用训练框架部署模型无法高效利用硬件。
- 目前的深度学习编译优化器主要为固定 shape 输入设计,无法良好处理 NLP 场景序列长度变化情况。
LightSeq 主要优化点:
- Kernel Fusion:减少 kernel launch 开销和内存访问。
- hierarchical auto regressive search:加速自回归生成。
- propose a dynamic GPU memory reuse strategy:预先为每个 kernel 分配最长 seq_len 需要的内存,在无依赖关系的 kernel 间进行内存复用。
2. Approach
基于 Transformer 的模型主要由两大模块组成:
- 特征计算层:TransformerBlockLayer,包括 encoder 和
decoder,内部进一步包括:
- 注意力 & FFN:主要由 GEMM 实现
- 一系列 IO 密集型操作,如:reshape 与 LayerNorm(reduce)
- 输出层:由具体任务类型决定,如理解任务的分类;生成任务的搜索(beam
search)
- Softmax 操作与概率排序等,是 IO 密集型
模型结构特性带来的可优化点:
- 通过 kernel fusion 消除对细粒度的 IO 密集型 kernel 多次调用,减少内存访问。
- 消除输出层的冗余计算:仅需要概率最高的少量 tokens/labels,不需要在整个词表上计算。
- 通过预先设置 max_seql_len 以及事先分配内存进行复用,避免动态 seq len 下频繁的内存分配。
2.1 Operation Fusion
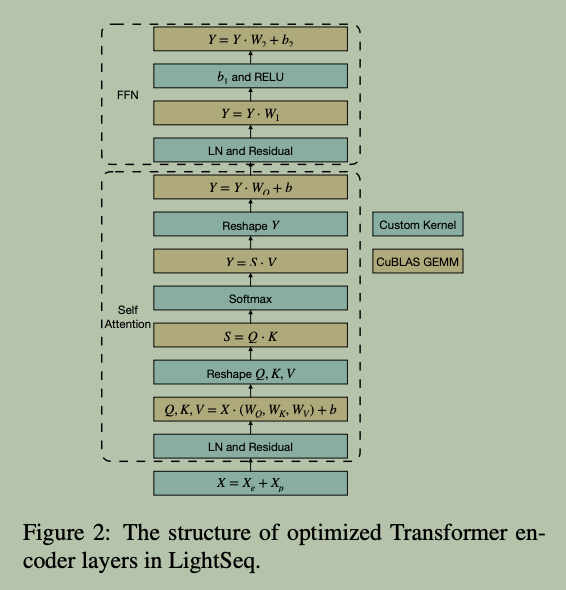
- 上图展示了 encoder layer kernel fusion 之后的 operator 调用情况。
- LayerNorm 例子
- 朴素实现:需要先用单独 kernel 计算 mean/var,然后计算结果,共 3 个 kernel 调用。
- fused 实现:一个 kernel 完成。
2.2 Hierarchical Auto Regressive Search
略,见课程 slides。
2.3 Dynamic GPU Memory Reuse
略,见课程 slides。
3. Conclusion
在本文中,我们解决了高昂序列模型的部署问题,并提出了一个用于序列处理和生成的高效推理库 LightSeq,缩小了大模型性能与在线服务需求之间的差距。与 FasterTransformer 的对比表明,我们在机器翻译和文本生成任务中均表现更优。在未来的工作中,我们将致力于探索更多技术以实现更显著的加速,包括高效的纯整数算术推理(integer-arithmetic-only inference)和稀疏 GEMM 计算。
LightSeq: A High Performance Inference Library for Transformers
https://arcsin2.cloud/posts/2026/10/34805025/