LLM Systems 14: Distributed Training
0. Recap
之前课程主线:
- LLM 简介
- CUDA 编程基础
- 深度学习框架(自动求导)
- Transformer/Pre-trained LLM
- LLM 前后两个辅助组件:Tokenizer 与 Decoding
- Transformer 加速:Kernel Fusion & Mix-precision & Memory Management Optimization
- 支线(跳过):Guest Lecture:Google TPU/JAX 生态介绍
从本 lecture 开始,我们将视角转向大规模模型的训练:当模型无法在一张 GPU 上进行训练时,该如何实现系统,以支持高效利用多卡支持模型进行分布式训练。
除了本课程 slides,这里额外推荐个介绍 LLM 分布式训练的在线书籍:
其中对各种分布式训练策略,如:DP、FSDP、TP、SP、PP、CP、EP 等有非常详细的分析与介绍。
1. Overview of large-scale model training
1.1 Background
模型参数量与训练数据量增长:
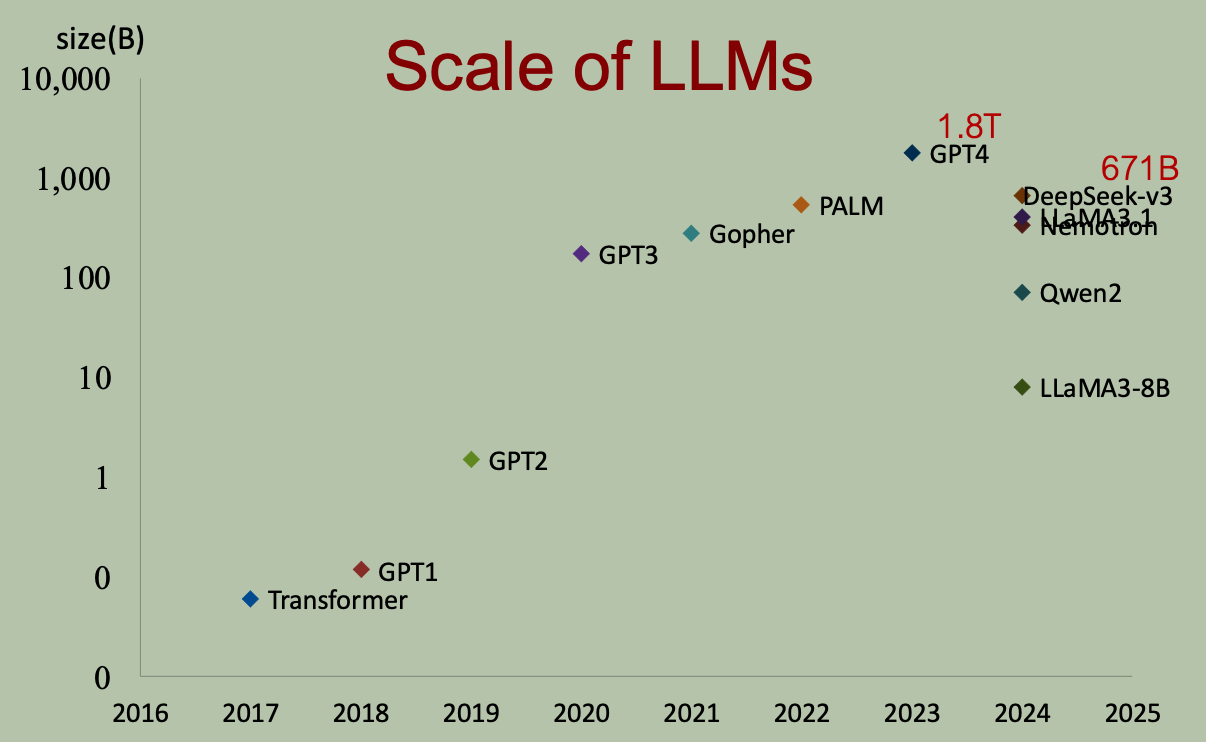
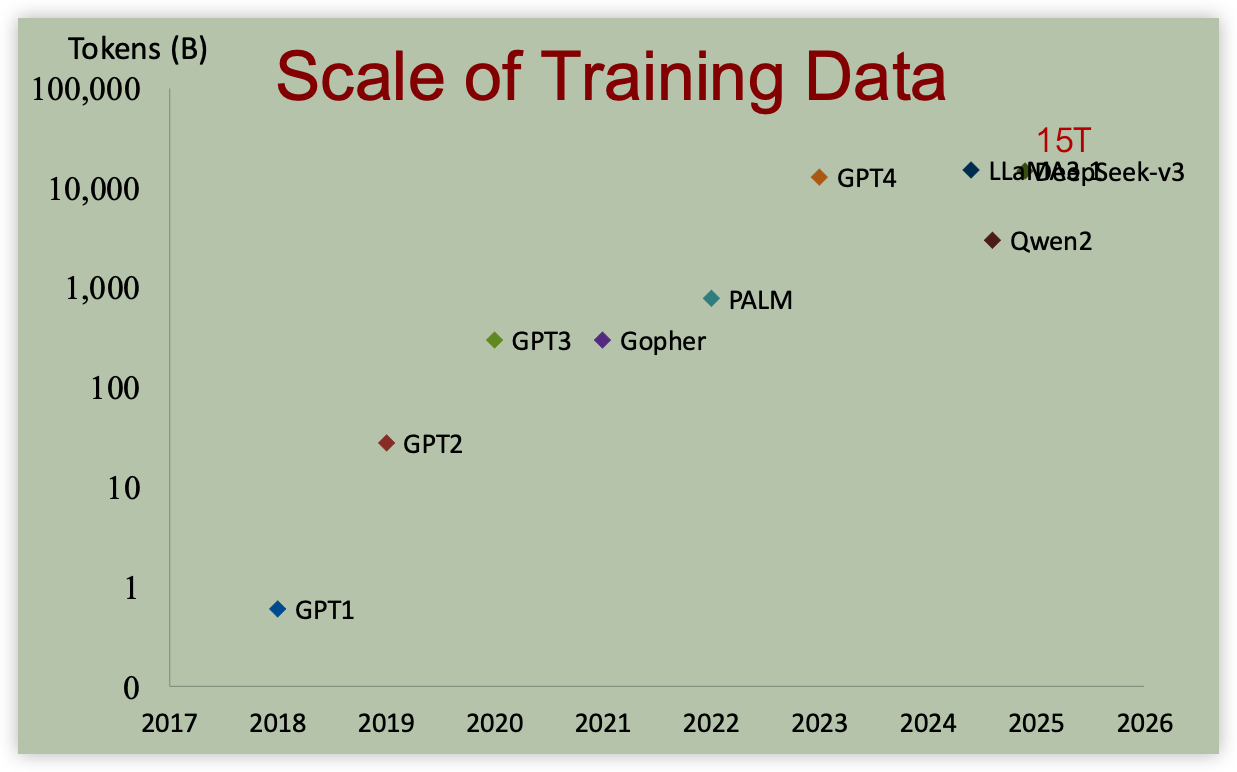
- 从 Transformer 提出的 2017 年至今(2026 年),模型参数量与训练 token 数呈指数增长。
- 问题:系统该如何支持如此大规模的模型训练?
1.2 Case Study
- Pretraining for Deepseek V3 (671B)
- 2,048 H800 GPUs
- trained for 2 months
- a total of 2.664 million H800 GPU hours
- LLaMA 3.1(405B)
- using 16,000 H100 GPUs
- a total of 30.84 million GPU hours
1.3 Strategies for Scalable Training
- Partition the data
- single node data parallel
- distributed data parallel
- parameter server
- Partition the model
- Model parallel
- Pipeline parallel
- Tensor parallel
1.4 Classical Distributed Training: Parameter Server
PS 示意图:
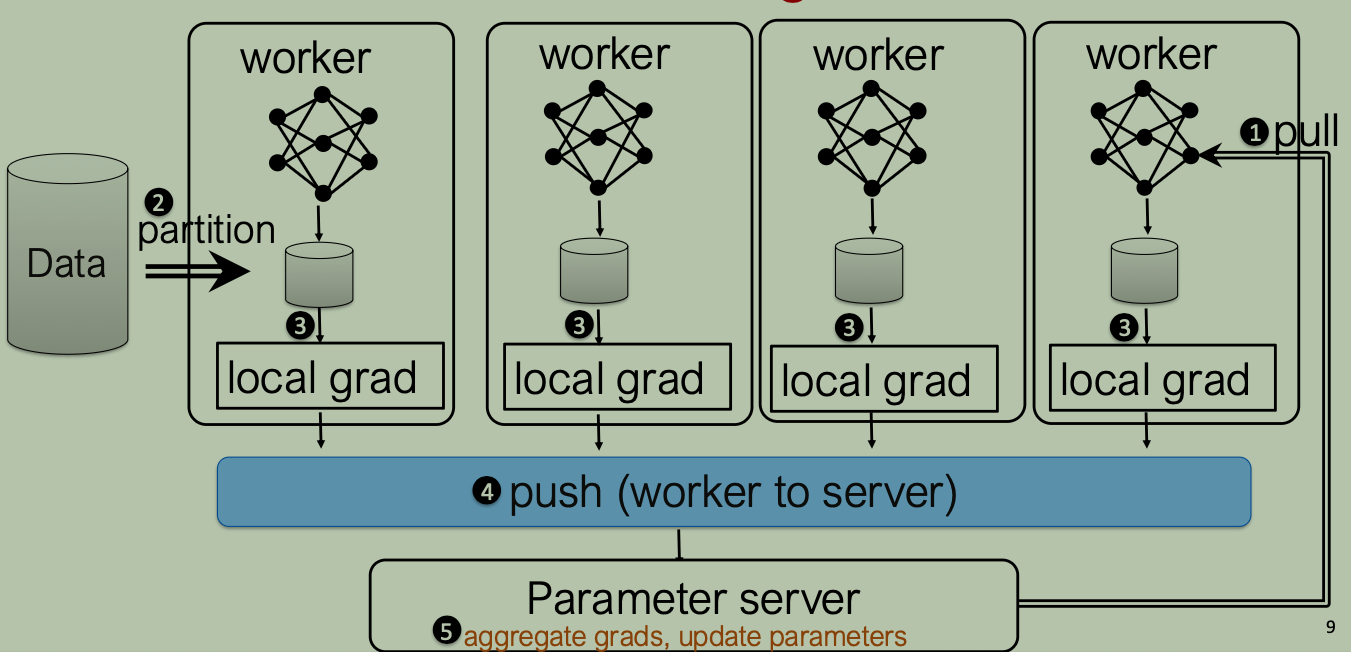
在一个完整训练迭代(Iteration)中,系统执行以下 4 个步骤:
- Pull(拉取参数): Worker 节点从 Parameter Server
获取当前最新的全局模型参数(在 NCCL 等通信库中对应
ncclBroadcast操作)。 - Compute(本地计算):Worker 利用最新参数和本地数据执行前向与反向传播,生成局部梯度。
- Push(推送与聚合梯度): Worker 将局部梯度发送给
Parameter Server;PS 将所有 Worker 的梯度进行规约求和/平均(对应
ncclReduce操作)。 - Update(更新参数):Parameter Server 使用聚合后的全局梯度更新模型权重,进入下一个迭代。
PS 架构存在的问题:
- 两次同步开销:每个迭代周期内,系统需要在网络上进行两次全量数据传输(一次广播 Pull 模型参数,一次规约 Push 梯度数据)。
- 网络带宽瓶颈:所有 Worker 均与中心 PS 节点通信,当 Worker 数量较多时,PS 节点的网络卡/总线带宽容易成为单点瓶颈。
2. Multi-GPU communication
在支持模型的多卡分布式训练时,通常使用 NCCL(Nvidia Collective Communication Library)进行多 GPU 间的集合通信。NCCL 特性如下:
- provides inter-GPU communication APIs
- both collective and point-to-point send/receive primitives
- supports various of interconnect technologies
- PCIe
- NVLink
- InfiniBand
- IP sockets
- Operations are tied to a CUDA stream.
2.1 NCCL Primitives
2.1.1 Broadcast
- The Broadcast operation copies an N-element buffer on the root rank to all ranks (devices).
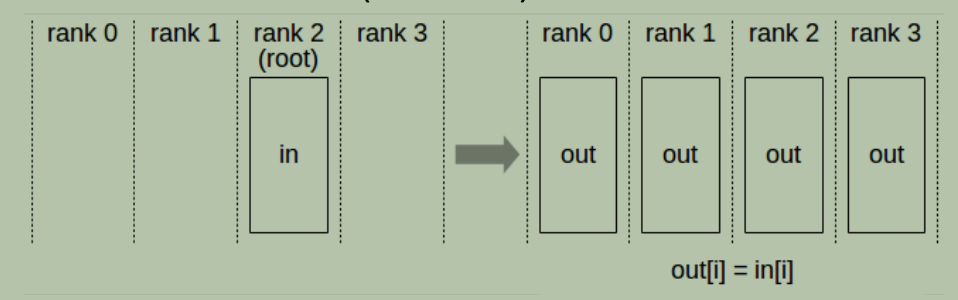
NCCL API:
1 | |
count:datatype 类型的元素数量(个数)。root:发送方(数据源根节点)的 Rank 编号。sendbuff:发送缓冲区,仅在 root 节点生效并读取;非 root 节点可传 NULL。recvbuff:接收缓冲区,所有 rank 用于存放广播接收到的数据。大小要与sendbuff相同,保证可以接收所有广播结果。comm:通信句柄,标识参与本次通信的 GPU 拓扑集合。
2.1.2 Reduce
- Compute reduction (max, min, sum) across devices and write on one rank (device).
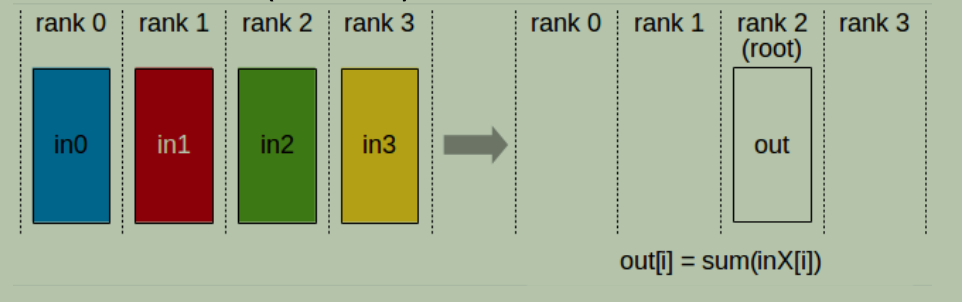
NCCL API:
1 | |
sendbuff:发送缓冲区,所有 Rank(包含 root)都需要传入各自包含局部数据的 buffer。recvbuf:接收缓冲区,仅在 root 节点生效,用于存放最终聚合后的数据;非 root 节点可传 NULL。大小要与sendbuff相同。count:元素数量,传输和规约的元素个数(与 ncclBroadcast 一致,代表 datatype 类型的个数,非字节数)。op:规约操作符,指定具体的聚合运算方式(如求和、最大值等)。root:目标根节点 Rank,接收并保存最终规约结果的 GPU 编号。
2.1.3 Reduce Scatter
- Compute reduction (sum, min, max) and writing parts of results scattered in ranks.
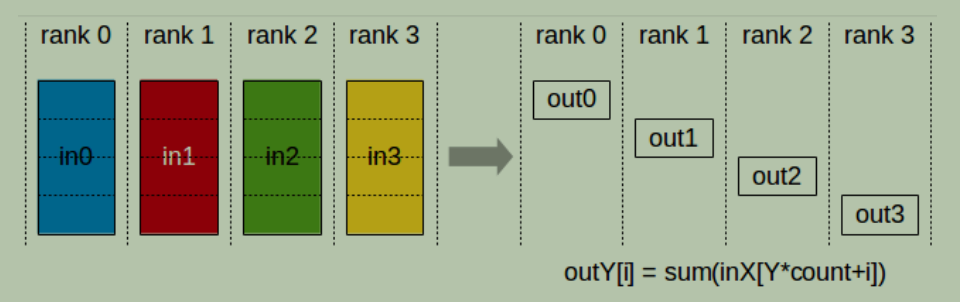
NCCL API:
1 | |
sendbuff:大小为nrank * recvcount。recvbuff:大小为recvcount。recvcount:每个 rank 接收的元素数量。
2.1.4 AllGather
- gathers N values from k ranks into an output of size k * N, and distributes that result to all ranks (devices).
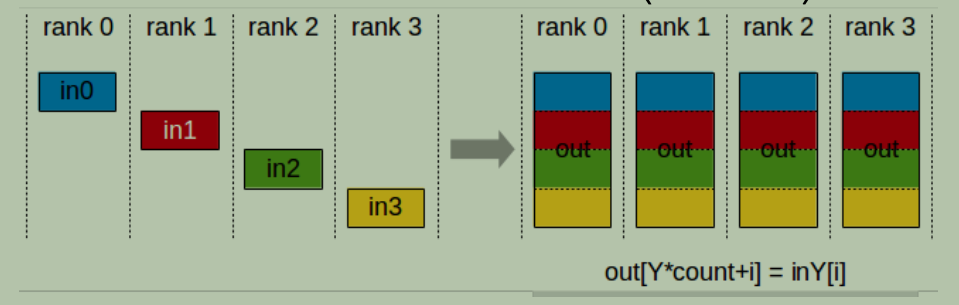
NCCL API:
1 | |
sendbuff:大小为sendcount。recvbuff:大小为nranks * sendcount。通信完成后,recvbuff内元素顺序为:rank 0 chunk;rank 1 chunk;...;rank n-1 chunk。sendcount:每个 rank 发送的元素数量。
2.1.5 AllReduce
- Compute reduction (sum, min, max) across devices and writing the result in the receive buffers of every rank.
AllReduce = Reduce + Broadcast = ReduceScatter + AllGather
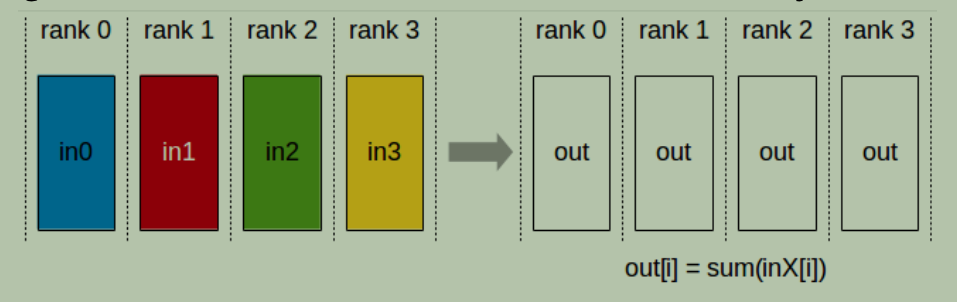
NCCL API:
1 | |
- 整体类似于
ncclReduce接口。 recvbuff:不同于ncclReduce接口只需要 root rank 传入有效地址,所有节点都必须传入有效地址。
2.1.6 Point-to-Point Communication
NCCL 点对点通信相关 API:
1 | |
- 调用点对点通信 API
ncclSend/ncclRecv时必须使用ncclGroupStart()/ncclGroupEnd()包裹起来。- 为什么必须要 Group 封装? NCCL 的 P2P 调用的底层逻辑是非阻塞的异步操作。如果不使用 Group API 进行打包,各 GPU 进程各自独立发起通信请求,非常容易导致线程间阻塞甚至网络死锁(Deadlock)。Group API 能够将这一组 Send/Recv 操作汇总,让 NCCL 在底层统一构建传输拓扑并调度硬件链路,实现高效无死锁的并发传输。
ncclSend(sendbuff, sendcount, sendtype, peer, comm, stream):将当前节点sendbuff中的sendcount个元素发送给目标节点 peer。ncclRecv(recvbuff, recvcount, recvtype, peer, comm, stream):从源节点 peer 接收数据存入当前节点的recvbuff。
示例:
- 单向传输:Rank 0 \(\rightarrow\) Rank 1
1 | |
- 双向传输:Rank 0 与 Rank 1 互相发送/接收
1 | |
2.2 Broadcast Implementation
- 朴素实现:单向环通信
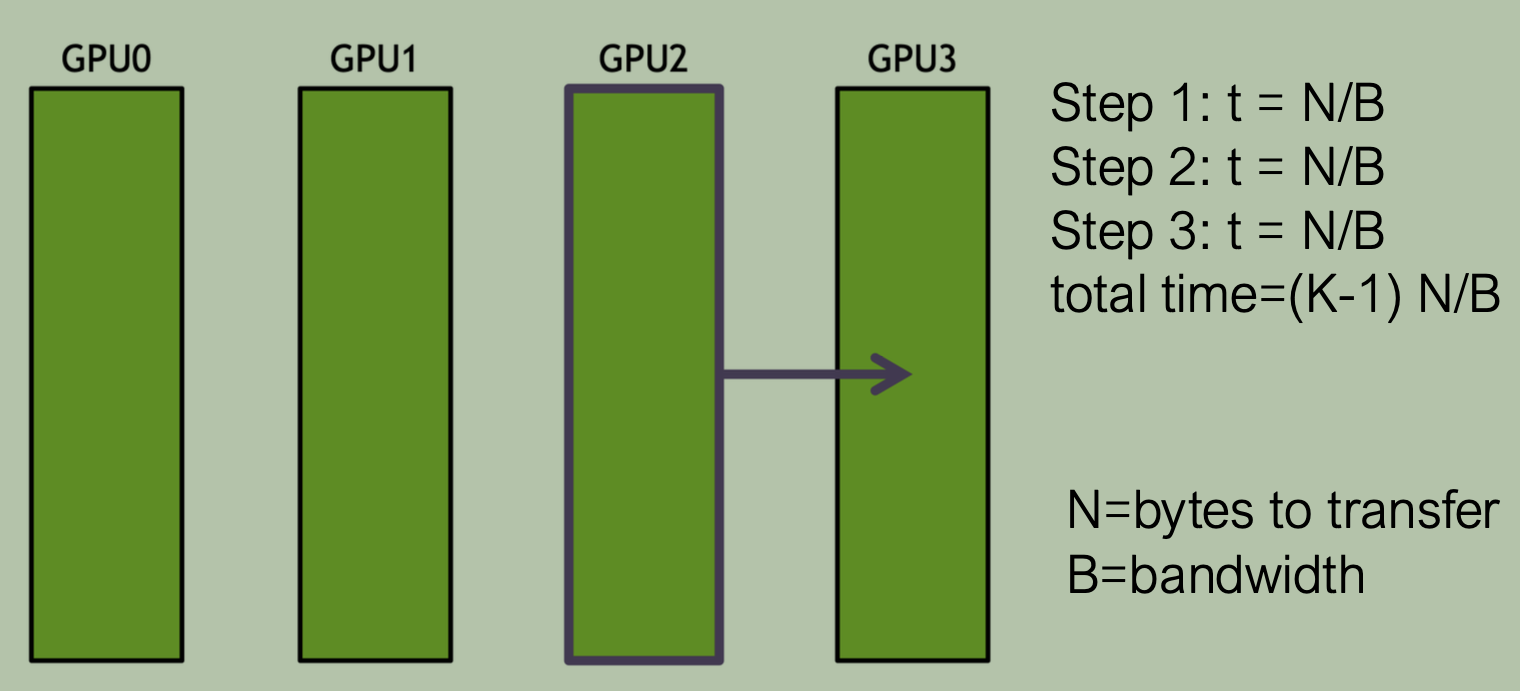
假设需要广播 \(N\) bytes,网络带宽为 \(B\),GPU 数量为 \(K\)
分为 \(K-1\) 步,每步发送全量 \(N\) bytes 到下一个 rank,单步通信耗时为 \(t = \frac{N}{B}\)
总通信耗时为:\((K-1)\frac{N}{B}\)
改进实现:将全量数据划分为 \(S\) 个 chunk,每步发送一个 chunk 到相邻 rank
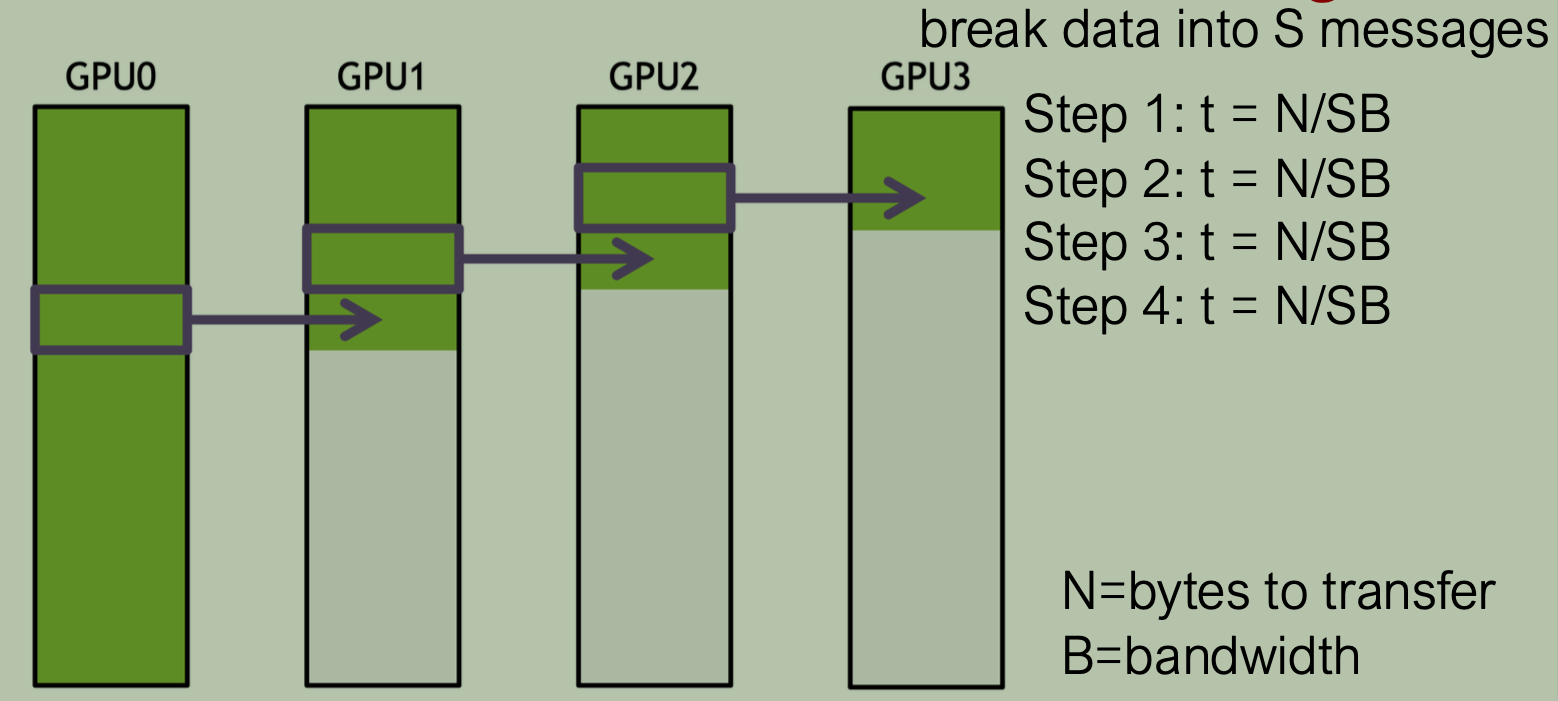
- 每步通信一个 chunk 大小为 \(\frac{N}{S}\) bytes,耗时为 \(t = \frac{N}{SB}\)
- 一共需要 \(K+S-2\) 步以完成全量广播
- 总通信耗时为:\(t = (K+S-2)\frac{N}{SB} = (1 + \frac{K-2}{S})\frac{N}{B}\) ,当分块数量远大于节点数,即:\(S >> K\) 时,耗时可近似为 \(\frac{N}{B}\) 。
NCCL 示例代码:
1 | |
- 在 单线程/单进程管理多个 GPU(Single-Thread/Process
Multi-GPU) 的模式下,使用 NCCL 进行通信域初始化以及发起并发
ncclAllReduce集合通信的标准范式。 ncclGroupStart()/ncclGroupEnd()使用ncclCommInitRank是一个阻塞式握手函数,它要求集群中所有的 GPU Rank 必须同时参与初始化。- 如果不使用 Group API 包裹,当前单线程在执行到
i=0(即第一个 GPU)时就会一直阻塞等待其他 Rank;而由于其他 GPU(i=1, 2...)也在同一个线程内等待轮询,线程永远无法执行到下一个 GPU 的初始化,直接导致死锁。 - 通过 Group API,NCCL 会将这
nDev个 GPU 的初始化意图先挂起并打包,直到ncclGroupEnd()时才一次性向所有设备发起并行握手,从而避免死锁。
2.3 Implementing Parameter Server using NCCL
- Pull:
ncclBroadcast- Parameter server to send parameters to all workers
- Push:
ncclReduce- workers send grads to server and sum
- Synchronization:
- workers need to wait for server to send param
- server need to wait for work to send grad * N
3. Data Parallel Training via AllReduce
Data Parallel 训练与 AllReduce 梯度通信示意图:
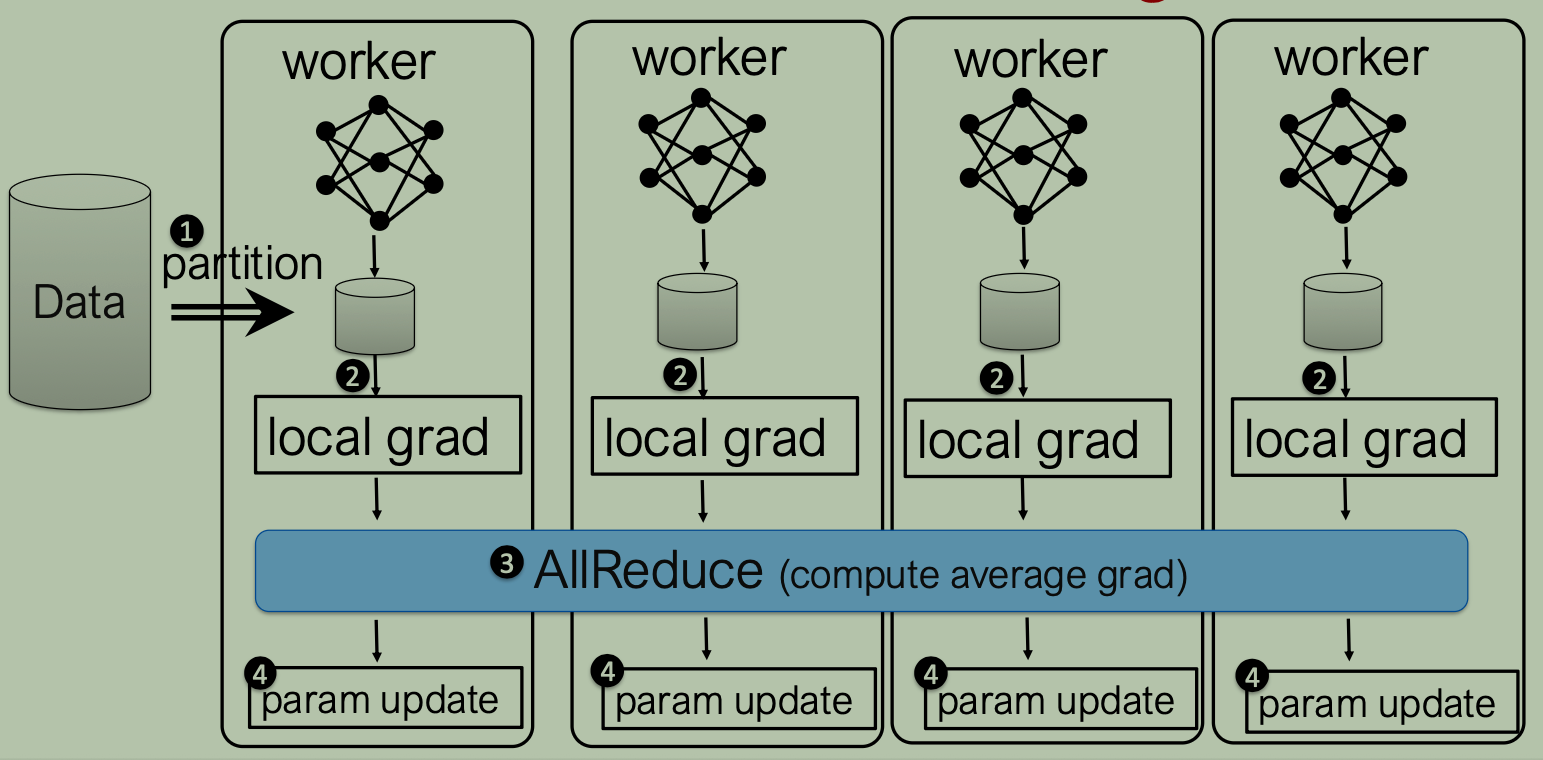
- 数据划分到多个 worker; - 每个 worker 用各自的数据独立进行 fwd
与 bwd,得到 local grad; - 所有调用 AllReduce 得到 local grad reduce
后的结果,确保不同 worker 最终梯度相同; - 用 reduce
结果梯度进行参数更新。
3.1 Ring AllReduce
3.1.1 Algorithm
假设有 \(K\) 个 GPU,Ring AllReduce 核心思想是将数据分为 \(K\) 个 chunk,通过 ReduceScatter + AllGather 高效实现 AllReduce。
数据切分
以 \(K=4\) 个 Worker 为例:
- Worker 0:梯度切分为 \([a_0, a_1, a_2, a_3]\)
- Worker 1:梯度切分为 \([b_0, b_1, b_2, b_3]\)
- Worker 2:梯度切分为 \([c_0, c_1, c_2, c_3]\)
- Worker 3:梯度切分为 \([d_0, d_1, d_2, d_3]\)
ReduceScatter
- 执行过程:共经历 \(K - 1\) 次传输迭代。在每一次迭代中,每个 GPU 将自己持有的某个分块发送给环中的右相邻节点,同时接收左相邻节点发来的分块,并在本地执行累加规约(Sum)。
- 核心成果:经过 \(K -
1\) 步累加后,每个 Worker 各自获得了 1 个分块的全局累加梯度:
- Worker 0 最终拥有第 0 块的全局梯度:\((a_0 + b_0 + c_0 + d_0)\)
- Worker 1 最终拥有第 1 块的全局梯度:\((a_1 + b_1 + c_1 + d_1)\)
- Worker 2 最终拥有第 2 块的全局梯度:\((a_2 + b_2 + c_2 + d_2)\)
- Worker 3 最终拥有第 3 块的全局梯度:\((a_3 + b_3 + c_3 + d_3)\)
- 注意,课程 slides 示意图实际上 Worker \(i\) 最终拥有第 \(i + 1\) 个块的全局梯度,这取决于实现,不影响 Ring AllReduce 核心思想与流程。
AllGather
- 执行过程:同样经历 \(K - 1\) 次传输迭代。在此阶段,无需再进行加法计算,各个 GPU 仅需将自己上一阶段计算好的全局梯度分块顺着环向后顺传给下一个节点。
- 核心成果:经过 \(K - 1\) 步分发后,所有 Worker 都收集齐了其余 \(K-1\) 个分块的全局梯度,最终所有 GPU 都获得了完整全局累加梯度数组 \([a_0..d_0, a_1..d_1, a_2..d_2, a_3..d_3]\)。
3.1.2 Implementation
Ring all-reduce: Implementing Scatter-reduce
1 | |
Ring all-reduce: Implementing All-gather
1 | |
3.2 Parameter Server vs AllReduce Data Parallel
- Parameter Server
- needs to synchronize twice (parameters and local gradients)
- AllReduce Data Parallel
- each local worker needs to update parameters
- redundant?
- 指每个 worker 都需要进行参数更新,存在冗余计算。但是相比多一次通信代价可以忽略。
- local updating is much faster than transferring data across gpus
4. Summary
- Overall idea: partition the data, distribute the forward/backward
- Parameter Server
- server to update and distribute parameters, worker to get local grad
- NCCL Multi-GPU communication
- using ring and batching to reduce the latency for Broadcast
- Data Parallel Training via All Reduce
- Efficient Ring AllReduce (ScatterReduce+AllGather