LLM Systems 08: Tokenization and Embedding
0. Recap
- Pretraining: Mask-labeled recovery of random spans + next token prediction
- Multitask supervised fine-tuning with instruction templates
- Relative position instead of absolute position: Rotary positional embedding
- Smooth activation: SwishGLU
- Sparse attention patterns
1. Subword tokenization: Byte-Pair-Encoding
1.1 Tokenizer
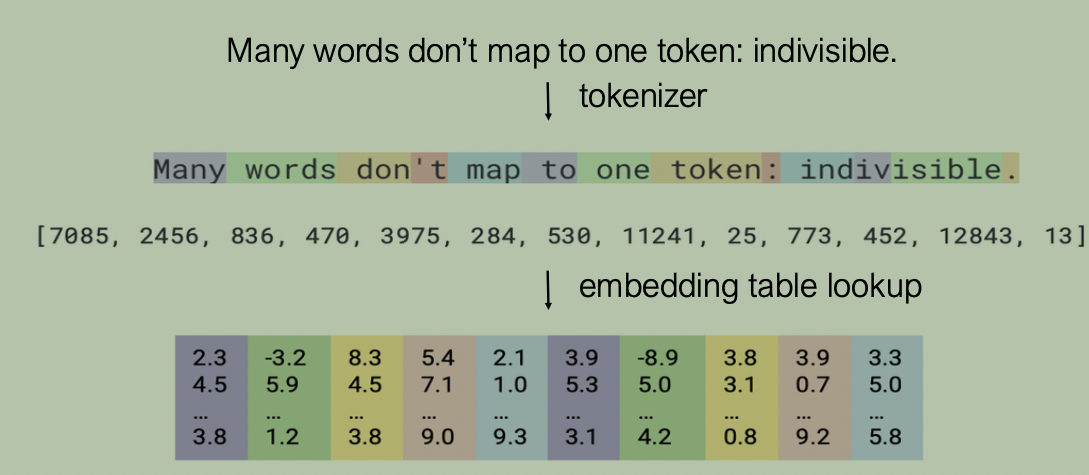
Tokenizer(分词器)核心功能:将文本切分为基本单元。
Tokenizer + Embedding 流程示例:
1.2 Word-level Tokenization
分词规则:
- 通过空格/标点符号进行切分
- 适用的典型语言:English, French, German, Spanish
- 数字用特殊 token [number] 表示
- 词表大小
- 词表截断(Frequency Cut-off):自然语言中的单词量巨大且存在长尾分布,不可能将所有词都存入词表。因此会按词频排序,只保留最常出现的 Top-K 个高频词作为词表。
- [UNK] 替换(Unknown Token):对于词频较低被截断的罕见词,或者训练集之外的新词(即 OOV,Out-of-Vocabulary),在分词时会被统一映射替换为特殊符号 [UNK]。
- 优点:
- 易于实现:只需要简单的 Key(word)-Value(出现频率) 统计。
- 缺点:
- 词表大小与 OOV
率的矛盾:如果词表设置过小,会有大量的词变成
[UNK],丢失关键语义信息;如果词表设置过大,模型底层 Embedding 层和顶层输出层的参数量会剧增。 - 无法原生支持无空格语言:对于中文、日语等没有天然空格分隔的语言(Continuous Script),这种简单拆分机制完全失效,必须依赖专门的分词工具(如 Jieba 等)。
- 词表大小与 OOV
率的矛盾:如果词表设置过小,会有大量的词变成
1.3 Character-level Tokenization
- 每个字母/标点符号都是一个 token
- 优点:
- 词表很小(对部分语言:如中文,不成立)。
- 不存在 OOV token。
- 缺点:
- 句子转换成的 token 序列过长。
- token 无语意信息。
1.4 Subword-level Tokenization
- 目标:
- 中等词表大小
- 消除 OOV
- Idea:
- represent rare words (OOV) by sequence of subwords
- Byte Pair Encoding (BPE)
- not necessarily semantic meaningful
- Originally for data compression
1.5 Byte Pair Encoding (BPE)
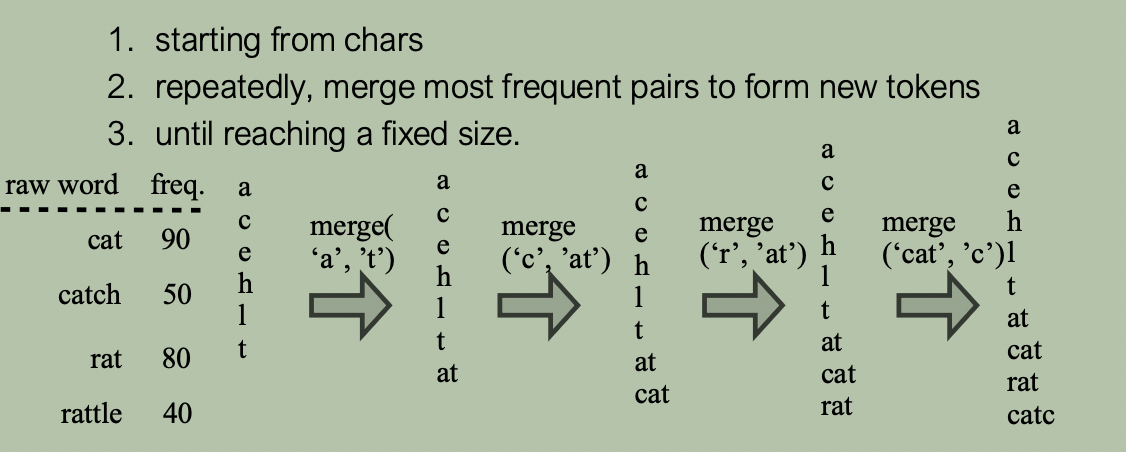
BPE 词表构建流程:
词表构建阶段的目的是在给定的训练语料库上,通过迭代合并最高频相邻字符对的方式自动学习出最佳词表及合并规则:
- 初始化基础词表:
- 将训练语料中的所有文本拆分为最基础的字符(Character,或者 Byte)。
- 收集所有基础字符作为初始词表,并可加入词尾/分隔特殊标记(如空格占位符或单词结尾符),统计语料库中各个基础符号及词汇的频次。
- 迭代合并最高频 Pair(Loop until fixed size):
在达到预设的词表目标容量(Vocabulary Size)之前,循环反复执行以下步骤:
- 统计频次:遍历语料库,统计所有连续相邻的 Token 组合对(Successive Pairs of Tokens) 的出现总频次。
- 选择并合并:找出当前语料中频次最高的 Token 对(Top Frequent Pair)。
- 扩充词表:将选出的最高频对合并为一个新的子词 Token,并添加到词集中。
- 更新语料:用新生成的 Token 替换原语料中所有对应的相邻字符对。
- 输出词表与规则:
- 当词表大小达到设定的容量限制后停止循环,输出最终的词表(Vocabulary)以及按优先级排序的合并规则列表(Merge Rules)。
BPE 词表构建示例:
BPE Tokenization 流程:
- 基础切分:按照空格或预分词正则表达式(Pre-tokenization Regex)将输入文本拆分为字符/字节级别的初始序列。
- 贪心/规则匹配合并:按照训练阶段学习到的合并规则顺序(或采用贪心匹配算法,寻找能匹配词表的最长前缀),依次将相邻子词合并,直至无法进一步合并为止。
- 无 OOV
风险:即便是遇到训练集未见过的罕见词或新词,也会被自然拆解为基础字符或常见子词片段进行编码,因此不会产生未知词标记(
[UNK])。
2. Information-theoretic vocabulary (VOLT)
问题:在不反复训练和测试全量模型的前提下,如何自动寻找最优的词表大小与子词组合?
衡量词表压缩性指标:
- 平均每 token 字节数(average number of bytes per token) \[ BPT = \frac{\text{\# utf-8 bytes}}{\# tokens} \]
- 归一化序列长度(normalized sequence length) \[ NSL = \frac{\text{\# tokens}}{\text{\# tokens in LLaMA}} \]
- 归一化熵(normalized entropy) \[ \mathcal{H}(v) = -\frac{1}{l_v} \sum_{i \in v} P(i) \log P(i) \] 其中,\(l_v\) 表示词表中所有 Token 的平均字符长度;\(P(i)\) 表示 token 在预训练语料中出现的频率(即某个 token 出现频次在全部 token 数量比例)。
归一化熵意义:
- 归一化熵衡量了每个字符的语意信息。
- 越小越好;越小表示歧义越小,易于生成。
例子:
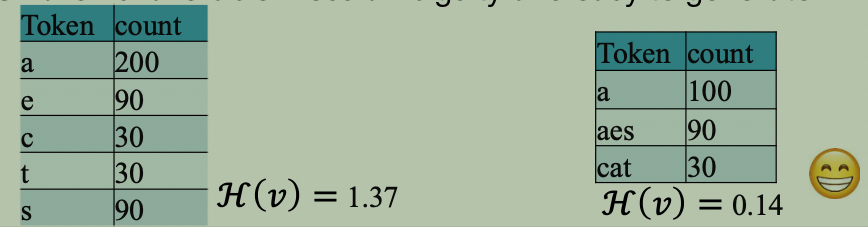
边际信息效用(MUV, Marginal Utility of information for Vocabulary)
定义:
\[ M_{v_k \to v_{k+m}} = -\frac{\mathcal{H}(v_k) - \mathcal{H}(v_{k+m})}{m} \]
解释:
- 即每增加一个 Token 所带来的归一化熵下降幅度的负梯度(即单位成本带来的信息增益),平衡 信息价值(归一化熵) 与 词表成本(Vocab Size)。
- 与模型性能的强关联:MUV 达到最大值的性价比拐点(Maximum MUV Point),与下游任务(如机器翻译 BLEU 得分)的峰值性能高度一致。在约三分之二的任务中,MUV 都可以作为生成性能的良好粗粒度指示器。
图表说明:
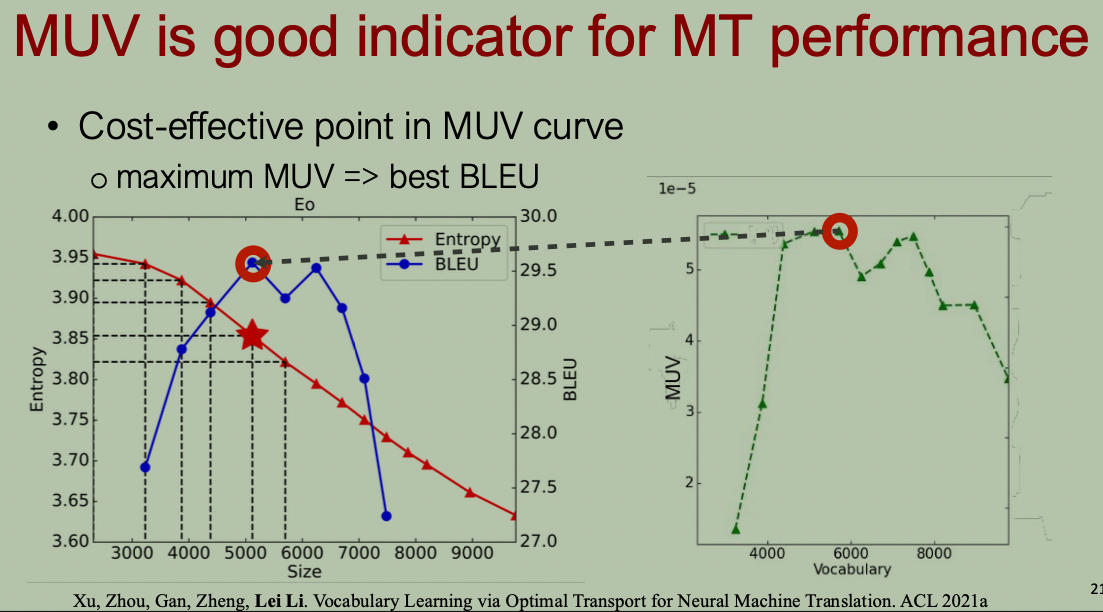
VOLT 如何求解 MUV 最大化问题略。
3. Practical Considerations in LLM
LLMs 预训练 Tokenizer 需要考虑的实际问题:
- 去重
- SentencePiece:SentencePiece: A simple and language independent subword tokenizer and detokenizer for Neural Text Processing
- 代码(编程语言)
- 数字
- 多语言
语料去重与过滤
- LLaMA 3 去重方式
- URL 级别去重。
- 使用 minHash 进行文档级去重。
- 每 3000 万文档使用 SHA-1 64-bit 哈希码识别重复行,重点剔除网页导航菜单、Cookie 警告、联系方式等模版化冗余内容。
- 过滤
- 一行的 n-gram 重复情况。
- “dirty word” 计数。
- token 分布与语料差异过大(KL 散度)。
Modern Subword Tokenization
- BBPE: byte-level BPE (universal for all languages)
- treating language as sequence of unicode bytes
- Wordpiece:
- 与 BPE 类似,但合并策略改为寻找能最大化条件概率 \(p(b|a)\) 的子词对3。
- SentencePiece:
- 统一对待空格与标点符号。
- 直接处理原始句子并将空格显式替换为下划线
_(U+2581)。
代码与数字的预分词特化处理(Pre-tokenization)
- 代码预分词(Code
Pre-tokenization):为了避免代码中的缩进、换行或连写符号被不合理切碎,使用复杂的正则表达式(Regex,如
GPT-4 正则表达式)在 BPE 前进行强制切分(例如将
.append识别为独立 Token 块)。 - 数字编码与数学增强(Handling Numbers):为了增强
LLM 的数学计算与数值推理能力,通过专门设计
[NUM]占位符或引入独立的 Number Head(数字预测头),将文本 Token 与数值连续表达分离开来。
多语言词表
- Q:如何构建多语言词表?
- A:
- 合并来自多种(LLaMA 3 中包含 176 种)语言的文档(约占总文本数据的 8%),然后在该联合语料库上应用 BPE 算法。
- 为每种语言获取相同数量的 BPE Token,然后再进行合并。
- 通过平衡平均对数概率(ALP, Average Log Probability)来分配每种语言的词表容量。
4. Vocabulary sharing and impact on multilingual performance
- 词表共享现象:在多语言场景下,许多跨语言词汇(如英语
television与法语télévision、西班牙语televisión)拥有相同或相似的词根与拼写,共享词表允许模型复用这些子词表达。 - Embedding Finetuning
- 构造了一个包含 10k 双语平行数据的轻量级指令微调集,对 LLaMA-7B 进行 Embedding 微调。
- 观察模型在 有监督的双语翻译方向(Bilingual) 与 其他非监督的多语言方向(Multilingual)上的性能变化。
- 实验结果:
在双语数据上微调 Embedding 并不总是能提升该有监督方向本身的性能。根据双语(Bilingual)和多语言(Multilingual)性能的变化(上升 ↑ 或下降 ↓),语言的表现划分为 4 种象限模式:
| 象限类型 | 双语性能 | 多语言性能 | 代表语言 | 现象解释 |
|---|---|---|---|---|
| Reciprocal(互利象限) | ↑ | ↑ | 捷克语 (cs)、德语 (de)、法语 (fr)、丹麦语 (da) | 主要是印欧语系,双语微调同时促进了双语与多语言能力。 |
| Altruistic(利他象限) | ↓ | ↑ | 中文 (zh)、阿拉伯语 (ar)、越南语 (vi)、韩语 (ko) | 牺牲了本语言的双语性能,却泛化提升了整体多语言能力。 |
| Stagnant(停滞象限) | ↓ | ↓ | 高棉语 (Km)、老挝语 (lo)、古吉拉特语 (gu)、泰卢固语 (te) | 两种性能均下降,出现了负迁移。 |
| Selfish(利己象限) | ↑ | ↓ | 印地语 (hi) | 仅提升了本语言的双语性能,损害了其他多语言能力。 |
原因分析: 过度分词(Over-tokenization)
为什么 Stagnant(停滞象限) 的语言会在微调中表现糟糕?
- Byte 级序列膨胀:在 BBPE(Byte-level BPE)下,非印欧语系或低资源语言的字符会被切分为极长的 Byte Token 序列。
- 实例:例如汉字 “饕” 被直接拆解为了 3 个字节 Token。
- 性能影响:这种过长的序列增加了模型表征和注意力机制的负担,导致数据效率低下。
5. Tokenizer-free model (Byte Latent Transformer, BLT)
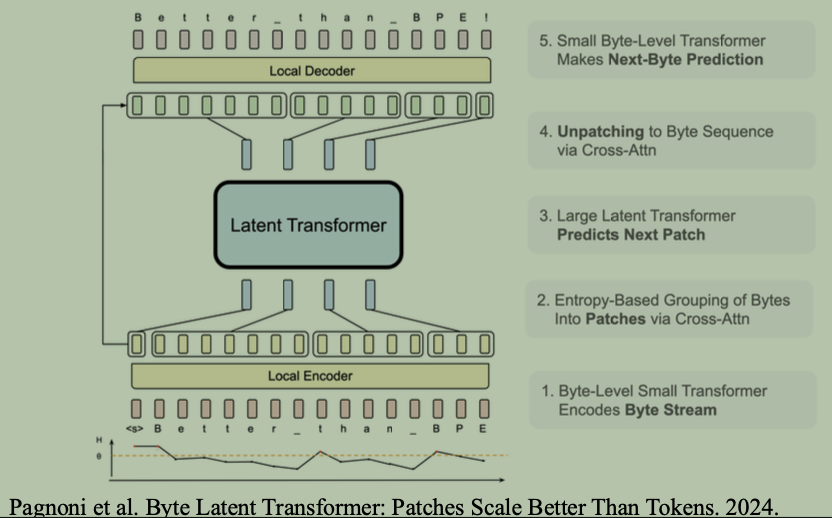
- 局部编码(Local Encoder – Byte-Level Small
Transformer):
- 使用一个轻量级的字节级 Transformer 对输入的原始 UTF-8 字节流进行初步编码。
- 基于熵的动态分组(Entropy-Based Grouping of Bytes Into
Patches):
- 算法实时监控字节流的不确定性/信息熵(Entropy \(H\))。当下一个字节的预测熵升高(超过设定的阈值 \(\theta\))时,意味着到了语义边界(例如词与词之间或符号转换处),系统会通过 Cross-Attention 动态地将若干字节打包组合成一个 Patch。
- 隐空间核心预测(Large Latent Transformer Predicts Next
Patch):
- 模型把大部分计算量集中在这个大型的 Latent Transformer 上,它在变长 Patch 的隐空间中进行高层级的上下文建模并预测下一个 Patch。
- 解包还原字节(Unpatching to Byte Sequence via
Cross-Attn):
- 通过 Cross-Attention 机制将预测出的 Patch 隐向量重新“解包/展开”(Unpatching)恢复为具体的字节序列。
- 局部解码输出(Local Decoder Makes Next-Byte
Prediction):
- 最后由另一个轻量级的字节级 Transformer(局部解码器) 逐字节预测(Next-Byte Prediction)出最终的文本字节。
6. Conclusion
- Subword tokenization: Byte-Pair-Encoding
- iteratively merging most frequent pairs of tokens
- Information-theoretic vocabulary (VOLT)
- solving entropy constrained optimal transport problem
- Pre-tokenization through regex
- Number treatment
- Vocab sharing impact multilingual performance
- how to solve languages in stagnant quadrant
LLM Systems 08: Tokenization and Embedding
https://arcsin2.cloud/posts/2026/10/2166139914/